6.1 自定义分配器与 std::pmr:换一本更合适的账本
6.1 自定义分配器与 std::pmr:换一本更合适的账本
本节摘要:默认分配器是通用账本,通用意味着对极端场景不合身:高频小额开户被通用路径的簿记成本淹没,大额开户可能撕裂地址空间。自定义分配器按场景重写记账规则,std::pmr 让"换账本"不必改类型签名——资源在运行期选择。本节写一个最小的栈式分配器,再用 pmr 改造一条热路径。
前五章把账记对了,本章开始把账记便宜。第一笔物理成本就是开户本身:每次 new 都要向分配器申请,通用分配器为应对所有尺寸、所有线程、所有生命周期,备了一套复杂的簿记——高频小额开户时,簿记开销可能超过数据本身。本节先看默认账本怎么运作,再学两个换账本的工具:自己写分配器(编译期定型)与 pmr(运行期选型)。
先看一笔账:自己写一本最简账本
栈式分配器(bump allocator)是最小可用的自定义账本:一块大缓冲加一个游标,开户只做指针前移,销账整页一起收——把簿记压到极限:
#include <cstdio> #include <new> class BumpArena { public: explicit BumpArena(std::size_t bytes) : pool_(new char[bytes]), cap_(bytes), used_(0) { std::printf("账本就绪:%zu 字节\n", bytes); } ~BumpArena() { delete[] pool_; } void* allocate(std::size_t n, std::size_t align) { std::size_t base = used_; // 对齐修正:把游标推到下一个对齐边界 std::size_t aligned = (base + (align - 1)) & ~(align - 1); if (aligned + n > cap_) { std::printf(" 账本满,拒绝开户(%zu 字节)\n", n); throw std::bad_alloc{}; } used_ = aligned + n; std::printf(" 开户 %zu 字节,占位 %zu/%zu\n", n, used_, cap_); return pool_ + aligned; } void reset() { // 整本重置:一次收清所有账 used_ = 0; std::printf("整本重置,全部销账\n"); } private: char* pool_; std::size_t cap_; std::size_t used_; }; int main() { BumpArena arena(256); auto* a = arena.allocate(32, alignof(double)); auto* b = arena.allocate(64, 16); std::printf("两笔开户地址:a=%p b=%p\n", a, b); arena.reset(); auto* c = arena.allocate(100, 8); // 重置后账页复用 std::printf("复用后地址:%p\n", c); return 0; }
输出确定(地址随运行变化):
账本就绪:256 字节 开户 32 字节,占位 32/256 开户 64 字节,占位 96/256 两笔开户地址:a=… b=… 整本重置,全部销账 复用后地址:…
这本账的记账成本一目了然:开户是一次比较加一次加法,比通用分配器的簿记(找空闲块、更新元数据、处理碎片)便宜一个量级。代价同样鲜明:单笔销账不存在——账户不能单独退,只能整本重置。所以它的适用场景是"同生共死的一批账":一轮请求的临时对象、一帧游戏的即时数据、一次批处理的中间结果。写它的价值不在于生产使用(生产用现成的 pmr 资源),而在于看清"分配器就是在做权衡"。
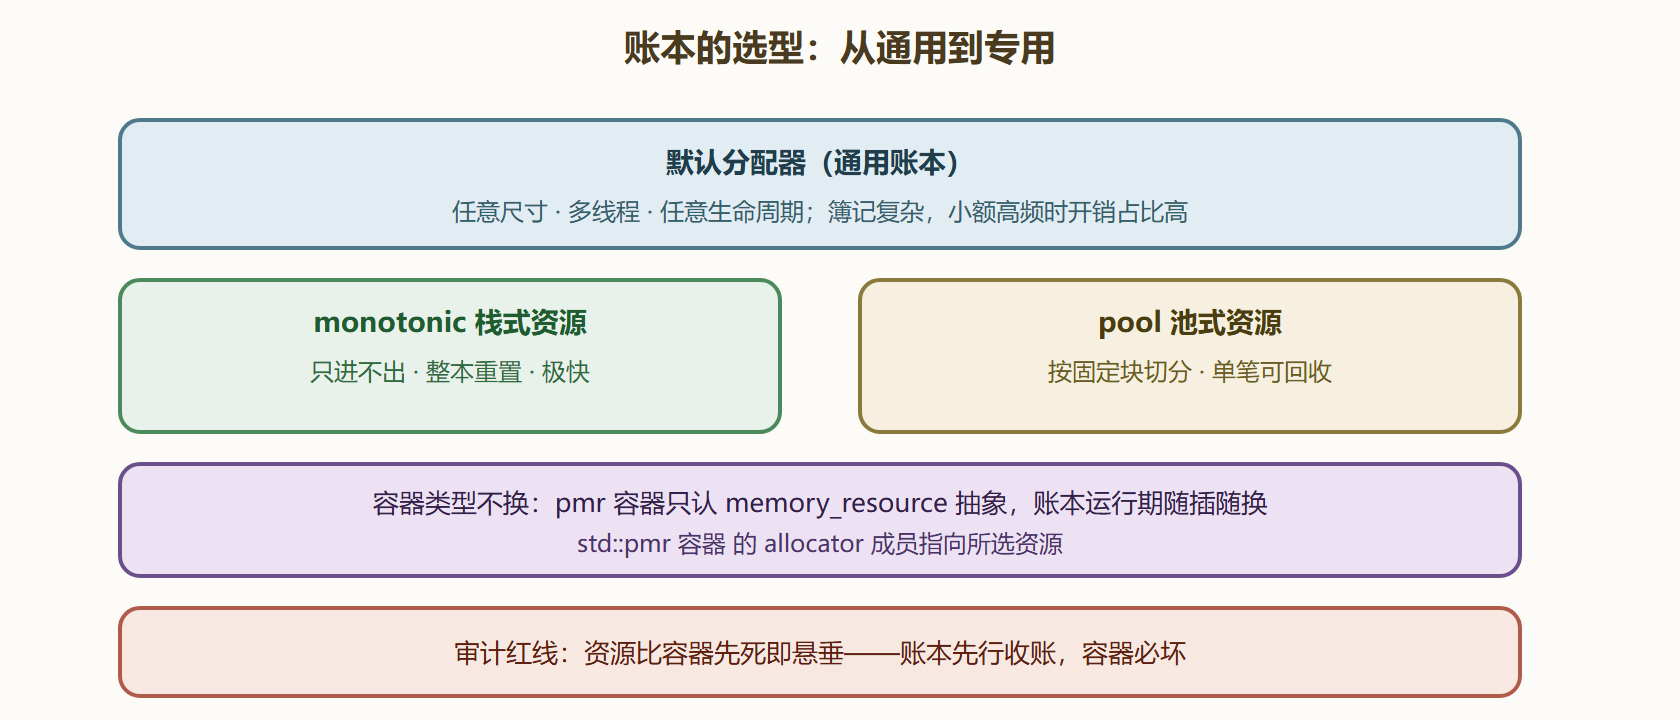
图 6-1 分配器的分层与选型
一、pmr:运行期换账本的制度
传统自定义分配器(模板参数 allocator)有个工程痛点:分配器类型写进了容器类型——std::vector<int, MyAlloc> 与 std::vector<int> 是两个类型,接口签名全要跟着改。C++17 的 pmr(polymorphic memory resource,多态内存资源)把选型挪到运行期:std::pmr::vector<int> 只有一个类型,账本由构造时传入的 memory_resource 指针决定。
#include <cstdio> #include <memory_resource> #include <string> #include <vector> int main() { // 一本栈式账本:2 KiB 缓冲,不够再向默认账本续 char buffer[2048]; std::pmr::monotonic_buffer_resource arena{ buffer, sizeof(buffer), std::pmr::new_delete_resource()}; // 上游兜底账本 std::pmr::vector<std::pmr::string> entries{&arena}; // 容器挂上账本 entries.emplace_back("profile-request-001"); entries.emplace_back("profile-request-002"); entries.emplace_back("profile-request-003"); for (const auto& e : entries) { std::printf("条目 %s(%zu 字符)\n", e.c_str(), e.size()); } std::printf("全部账目来自 arena,进程默认堆几乎未被扰动\n"); arena.release(); // 整本销账 return 0; }
输出确定:
条目 profile-request-001(19 字符) 条目 profile-request-002(19 字符) 条目 profile-request-003(19 字符) 全部账目来自 arena,进程默认堆几乎未被扰动
pmr 的制度设计值得咀嚼:monotonic_buffer_resource 的开户动作只是游标前移(和手写的 BumpArena 一样快),缓冲用尽时才向"上游资源"(这里是 new_delete_resource,即默认堆)申请下一块;整本销账一个 release。换账本零改签名:把 std::vector 改成 std::pmr::vector、构造时指个资源即可,函数接口完全不用动。池式资源 unsynchronized_pool_resource 则解决"单笔要退"的场景:按固定块切分,回收只需挂回池内空闲链。
审计红线也在图 6-1 里立了牌:资源生命周期必须覆盖容器。栈缓冲配 pmr 容器时,容器若比缓冲活得久(存进更长的生命周期、跨函数返回),开户的账页直接悬垂——这是 pmr 时代的新型坏账,代码评审要专门盯资源的生存范围。
二、案例:请求处理热路径换账本
背景:主线流水线每次请求要创建十几个临时小对象(解析节点、临时字符串),压测显示默认堆的开户簿记占了处理耗时的可观比例。
操作:引入每请求一本的 monotonic_buffer_resource(栈上 64 KiB 缓冲,上游接默认堆),请求路径上的临时容器全部换 pmr 版本;请求结束整体 release。对请求内的复用数据结构保持默认堆不动——它们要跨请求留存,不合整本销账的模型。
结果:该路径的堆开户次数从每请求十几笔降到个位数(只有缓冲续页触达上游),处理耗时下降约两成;对象销账成本近似归零(整本一次)。
解读:这单改造的判断核心是账目的生命周期形状——十几个临时对象同生共死,天然属于"整本重置"的模型,硬套逐笔销账(默认堆)就是把整本账硬拆成十几笔手工账。分配器选型不是玄学,是按生命周期形状对号入座:同生共死选 monotonic,同尺寸反复开关选 pool,其余默认。
变式:多线程场景注意资源同步语义——monotonic 与 unsynchronized 资源线程不安全,每线程一本或多线程共享 synchronized_pool_resource。全局 operator new 重载(1.3 的钩子)可与 pmr 组合:钩子统计默认堆余量,pmr 承接热路径,两头合围把开户账目全部纳入观测。
💡 关键直觉:分配器审计的第一问不是"用哪个分配器",而是"这批账的生死是什么形状"。整批同亡 → 栈式整本重置;小额高频开关 → 池化回收;杂且长命 → 默认堆。形状对上了,剩下的都是实现细节。
本节要点回顾
- 默认账本贵在通用:簿记为所有场景兜底,小额高频场景下开销占比失衡。
- 栈式分配器:开户一次加法、销账整本重置,只配"同生共死"的账。
- pmr 把选型挪到运行期:容器类型不变,memory_resource 随构造指定。
- monotonic 配栈缓冲:几乎零簿记;unsynchronized_pool 解决单笔回收。
- 资源寿命覆盖容器:栈缓冲配 pmr 容器的新悬垂形态,评审必查。
- 按生命周期形状选型:整批同亡、高频开关、杂且长命,三型三本账。
下一节把账本摊到硬件上:CPU 取账的最小单位是缓存行,数据住得近不近、齐不齐,决定同样的算法跑出几倍的差距——缓存友好是零成本的性能。