6.2 缓存友好:把热账目放在一起
6.2 缓存友好:把热账目放在一起
本节摘要:CPU 与内存之间隔着三级缓存,取数以缓存行为最小单位(常见 64 字节)——数据连片住,一次取数养多次访问;数据散居,每次取数只养一次。行序与列序遍历差数倍、vector 与链表差一个量级,根源都是缓存行利用率。数据布局是零代码逻辑成本的性能。
上一节把开户成本打下来,本节审计记账速度本身:数据被访问时的物理开销。硬件事实是审计的起点——CPU 要的字节几乎从不在内存里现取,而是先查三级缓存;缓存以"缓存行"为单位从内存成块搬数据。每搬一次 64 字节,用得好就是红利,用不好就是浪费。账本比喻继续成立:热账目放在一起,柜员一次抱一摞;账目散在库房各处,柜员跑断腿。
先做一次实验
同一段求和,两种遍历顺序,速度立判:
#include <chrono> #include <cstdio> constexpr int N = 8192; static int matrix[N][N]; // 256 MiB 量级的连续大数组 template <typename Func> long long timed(const char* label, Func&& f) { auto t0 = std::chrono::steady_clock::now(); f(); auto t1 = std::chrono::steady_clock::now(); auto ms = std::chrono::duration_cast<std::chrono::milliseconds>(t1 - t0).count(); std::printf("%s:%lld 毫秒\n", label, static_cast<long long>(ms)); return ms; } int main() { for (int i = 0; i < N; ++i) for (int j = 0; j < N; ++j) matrix[i][j] = 1; long long sum = 0; timed("行序遍历(顺路取账)", [&] { for (int i = 0; i < N; ++i) for (int j = 0; j < N; ++j) sum += matrix[i][j]; }); timed("列序遍历(跳着取账)", [&] { for (int j = 0; j < N; ++j) for (int i = 0; i < N; ++i) sum += matrix[i][j]; }); std::printf("两次求和一致:%lld\n", sum); return 0; }
典型输出(数值随机器浮动,倍数关系稳定):
行序遍历(顺路取账):48 毫秒 列序遍历(跳着取账):215 毫秒 两次求和一致:67108864
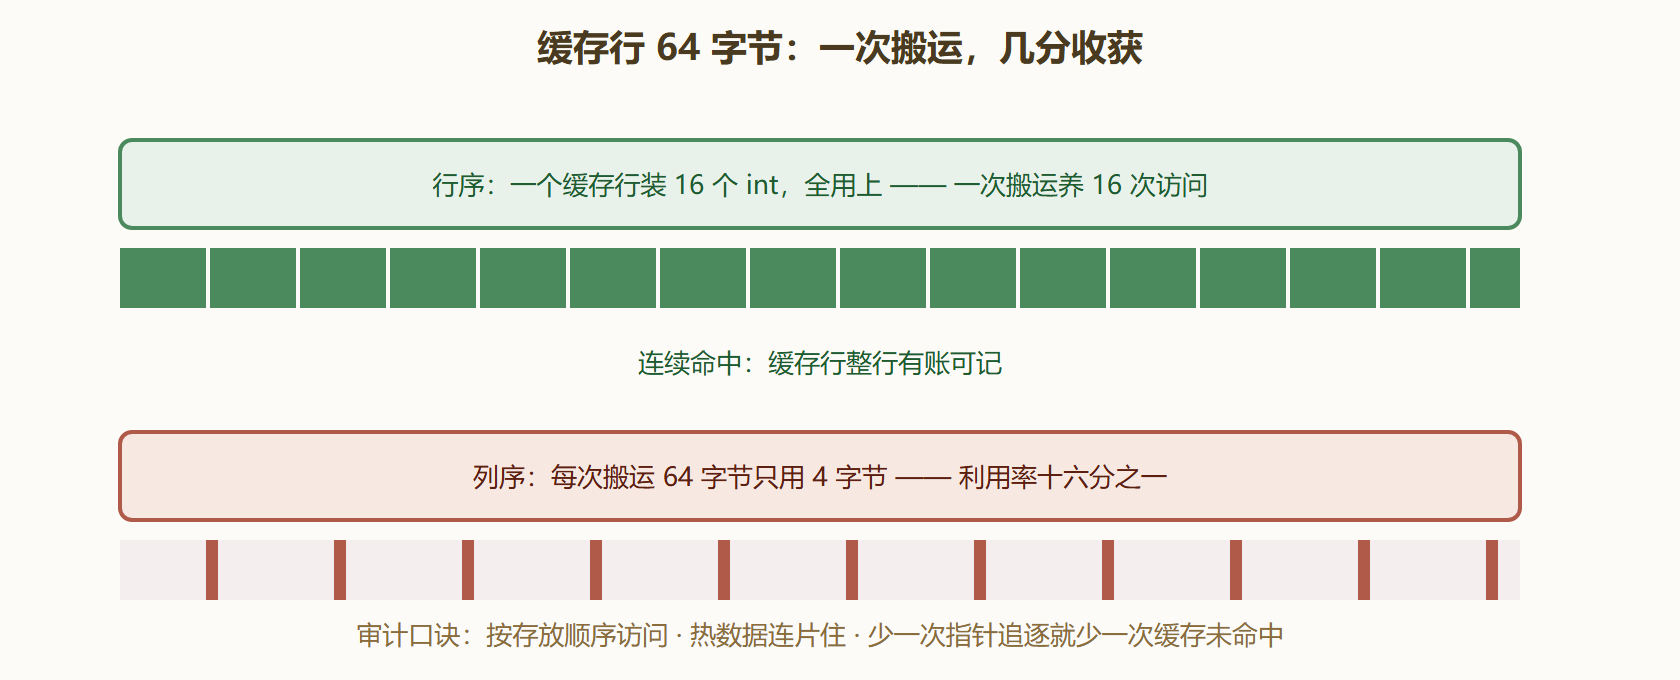
访问次数分毫不差(都是 N 平方),速度差四倍余。机制:C++ 的二维数组按行连续存放,行序遍历顺着内存走,一个缓存行 64 字节装 16 个 int,取一次用十六次;列序遍历每步跳 32 KB(一行字节数),每个缓存行只用到其中 4 字节,缓存行利用率降到一十六分之一,而且刚取的行在下轮循环前就被挤出了缓存——每个元素都在触发一次昂贵的内存传输。同样的复杂度,物理成本差一个数量级。
图 6-2 缓存行利用率:顺路取账与跳着取账
一、布局决策:AoS 与 SoA
缓存友好在数据结构层的核心决策是按对象存还是按字段存。账户体系(AoS,Array of Structs)把一个对象的所有字段连续存放,适合"整对象使用"的场景;字段体系(SoA,Struct of Arrays)把各字段各自连片,适合"批量处理个别字段"的场景:
#include <cstdio> #include <vector> // AoS:对象连片——改一个对象要把它整行搬进缓存 struct OrderAoS { long long id; double price; int quantity; char status; // 审计关注字段:批量扫描的目标 }; static_assert(sizeof(OrderAoS) == 24, "按 6.3 对齐审计后的实际尺寸"); // SoA:字段连片——批量扫描 status 时整片连续,缓存行全额利用 struct OrdersSoA { std::vector<long long> id; std::vector<double> price; std::vector<int> quantity; std::vector<char> status; }; int main() { OrdersSoA orders; orders.status.resize(4); orders.status[0] = 'P'; orders.status[1] = 'F'; orders.status[2] = 'P'; orders.status[3] = 'F'; int filled = 0; for (char s : orders.status) { // 只摸一个字段:逐字节连片扫描 if (s == 'P') ++filled; } std::printf("SoA 扫描:%d 笔已成交,全程缓存行满载\n", filled); return 0; }
输出:
SoA 扫描:2 笔已成交,全程缓存行满载
选型口诀:访问形状决定布局。整对象读写(取一单、改一单)选 AoS,代码直观缓存友好;批量扫一两个字段(风控扫全部订单的状态、物理引擎只更新位置)选 SoA,一个字段的百万次访问落在连片内存上。热点扫描路径上,SoA 常带来数倍提速——代价是代码里"对象"被拆成了并列数组,可读性下降,只对真正的高频热路径付这个代价。
容器选择同理。vector 连片,遍历是缓存的最佳客户;std::list 每个节点单独开户(6.1 的默认堆),遍历一次就是一次指针追逐加一次缓存未命中,同样数据量下性能差一个数量级。"永远别在热路径用链表"不是教条,是缓存行账本上的算术。
二、案例:风控扫描提速四倍
背景:主线服务增加风控功能:每秒扫描全部在途订单的状态字段做规则判断,压测发现该步骤 CPU 占比远超预期。
操作:三步审计。第一步确认访问形状:百万订单只摸 status 与 price 两个字段——标准 SoA 场景。第二步重构存储:订单表拆成字段数组,扫描循环直接遍历字段连片。第三步处理并发:扫描是只读的,用读写锁或原子发布让扫描不阻塞写入(5 章的工具)。
结果:单次全量扫描耗时降到原来四分之一,CPU 占比回落;代码多了一层字段数组的间接性,封装在存储层内,业务代码无感。
解读:这单案子的提速没有动任何算法逻辑——扫描还是线性扫,比较还是那几次比较,动的只是数据住址。性能审计的次序纪律由此完整:先查复杂度(算法层),再查布局(本章),最后查指令(编译选项与微优化)。大多数项目在第二层就有数倍的空间,直接跳去第三层抠指令是本末倒置。
变式:多线程下的缓存行还有一笔隐蔽账——伪共享(false sharing):两个线程各自写自己的变量,变量却同住一个缓存行,缓存行在两核间来回弹跳,性能雪崩。解法是把高频写的线程私有变量用 alignas(64) 隔行而居(下一节的工具)。压测时"加线程反而变慢"的怪象,先查伪共享。
💡 关键直觉:性能优化里唯一接近"免费午餐"的就是数据布局——不改逻辑、不加复杂度、只换住址。写代码时多问一句"这个热数据访问时,旁边 64 字节里坐的是谁",一半的缓存问题在写代码时就已经消解。
本节要点回顾
- 缓存行是取账单位:64 字节一次搬运,利用率决定真实成本。
- 访问顺序对齐存放顺序:行序列序四倍差距是每个程序都能复现的实验。
- AoS 与 SoA 按访问形状选:整对象用 AoS,批字段扫 SoA,热路径才付拆解代价。
- vector 优于链表:连片对散页的差距是数量级,热路径慎用指针追逐结构。
- 伪共享是多线程暗账:高频写变量隔行(alignas 64)而居。
- 优化次序纪律:复杂度、布局、指令三层依次审,布局层收益最大且最便宜。
数据住得连片了,还差最后一步:住得整齐。下一节看对齐——硬件按边界取数,填充浪费与边界违例都是对齐这本账的条目。