6.3 内存对齐:账本格子不能乱塞
6.3 内存对齐:账本格子不能乱塞
本节摘要:硬件按对齐边界取数,编译器因此在成员之间与结构体尾部插入填充(padding),保证每个字段落在自己类型的边界上。对齐保证访问正确与高效,填充则可能悄悄撑大结构体——成员重排常能省下可观内存。alignas 与 alignof 是这本账的记账工具,超对齐(如 64)还是隔开伪共享的手段。
上一节说数据要连片住,本节补上另一半:还要按边界住。CPU 不是逐字节取数的,它按字长对齐的边界成块取;一个 int 若横跨两个取数边界,硬件要么降速处理要么直接拒绝。对齐是硬件的物理要求,编译器用"自动塞垫片"满足它——垫片就是 padding,账本上那些看不见的空格子。
先看一笔账
把对齐这本账直接打印出来:
#include <cstdio> struct Sloppy { // 乱序成员:塞满垫片 char a; // 1 字节 + 3 填充(int 要 4 边界) int b; // 4 字节 + 0 填充 char c; // 1 字节 + 7 填充(整体要对齐到 8) }; struct Tidy { // 按对齐从大到小排:垫片最少 int b; // 4 字节 char a; // 1 字节 + 1 填充(char 后 short 要 2 边界) short s; // 2 字节 + 0 填充 char c; // 1 字节 + 1 填充(尾部补齐到 4 的倍数) }; struct Padded { // 与 Tidy 同字段、乱序摆放:白白胖胖 char a; short s; char c; int b; }; int main() { std::printf("Sloppy:sizeof=%zu alignof=%zu\n", sizeof(Sloppy), alignof(Sloppy)); std::printf("Tidy :sizeof=%zu alignof=%zu\n", sizeof(Tidy), alignof(Tidy)); std::printf("Padded:sizeof=%zu alignof=%zu\n", sizeof(Padded), alignof(Padded)); std::printf("同一组字段,尺寸差到 %zu 字节\n", sizeof(Sloppy) - sizeof(Tidy)); return 0; }
主流 64 位平台输出:
Sloppy:sizeof=12 alignof=4 Tidy :sizeof=8 alignof=4 Padded:sizeof=12 alignof=8
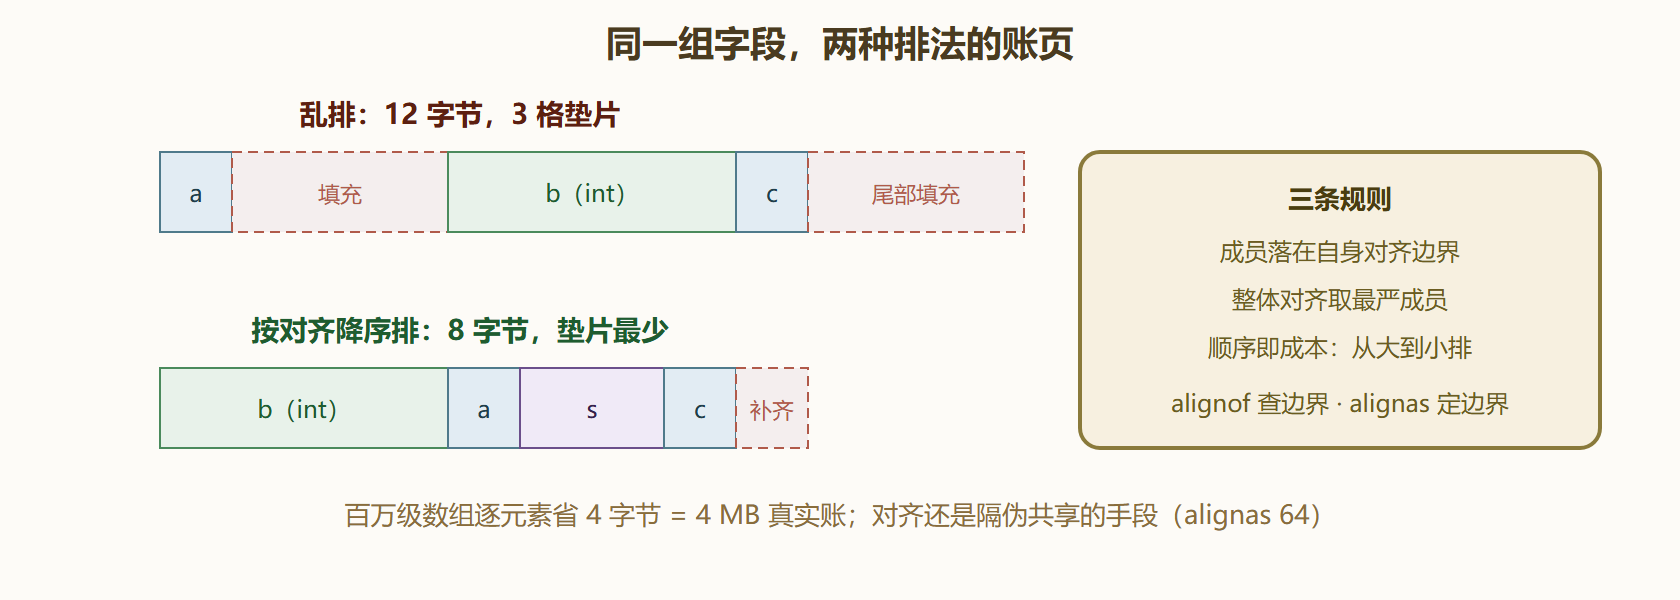
规则拆开看就三条。其一,成员对齐到自身边界:int 放在 4 的倍数地址,short 放 2 的倍数地址,char 随处可放。其二,整体对齐到最严成员:结构体的 alignof 取成员中的最大对齐值,总尺寸凑成它的倍数(尾部填充)。其三,顺序即成本:同样四个字段,从大到小排的 Tidy 8 字节,乱排的 Padded 12 字节——白多一半。成员按对齐从大到小排列是零成本纪律,热路径上的大数组尤其值得执行:百万个元素各省 4 字节,就是 4 MB 的真实账。
图 6-3 填充前后的账页对比
一、alignas:主动定边界
自动对齐保证"正确",主动对齐解决两类进阶需求。需求一是隔伪共享(上一节埋的伏笔):多线程各自高频写的变量若同住一个缓存行,缓存行在核间来回弹跳,用 alignas 把它们隔行而居:
#include <cstdio> struct Counters { alignas(64) long pushed = 0; // 独占一个缓存行 alignas(64) long popped = 0; // 与上一行永不同页 }; int main() { std::printf("Counter 对齐要求 %zu 字节,尺寸 %zu 字节\n", alignof(Counters), sizeof(Counters)); std::printf("pushed 与 popped 不同缓存行,伪共享消除\n"); return 0; }
输出:
Counter 对齐要求 64 字节,尺寸 128 字节
尺寸从 16 字节涨到 128——这就是对齐的账本本质:用空间买正确与速度。隔行是有意为之的浪费,账要算得明白:只在多线程高频写场景付这个钱。
需求二是超对齐数据:SIMD 指令要求 16 或 32 字节边界,硬件直接内存访问要求更严边界。alignas(32) 修饰类型或变量后,编译器保证落点合规,new 出来的对象也按超对齐分配(C++17 起对超对齐类型自动生效)。要注意 alignas 只会加严不会放松:alignas(1) 改不了 int 的天然 4 字节要求,放松对齐是未定义行为,没有这种写法。
二、案例:消息结构体的瘦身审计
背景:主线服务的网关模块要缓存在途订单,单量峰值百万级,内存预算吃紧;订单消息结构体是历史代码,字段按需求出现顺序堆放。
操作:按三步做对齐审计。第一步 print 审计:对结构体逐字段打印偏移(offsetof),画出垫片分布——12 字节结构里有 5 字节垫片。第二步重排:按对齐从大到小手工排序,再复检——尺寸从 24 降到 20;把两个 rarely 用的标志位收进一个 bit field,再降到 20 以下的空间又被尾部对齐吃回,最终定为 20。第三步验证:序列化兼容性测试通过(跨进程传输的消息格式本就有显式字段序,不受内存布局影响)。
结果:百万缓存省下约 4 MB,更重要的是建立了"结构体进门先过对齐审计"的评审项;此后新结构体默认按对齐降序写,静态检查工具加了对应规则。
解读:对齐审计的风险点在序列化与跨平台:布局里含填充时,直接按内存 memcpy 出去的二进制在另一平台可能对不上(对齐规则、字节序都可能不同)。纪律是:对外传输用显式序列化格式,内存布局只对内负责。这单案子省的内存不算巨大,但"每字节都记在账上"的习惯,在嵌入式与大规模缓存场景里就是成本竞争力。
变式:编译器通常提供"重排成员"的优化开关(牺牲标准布局兼容换紧凑),开启前先确认没有依赖内存布局的代码(memcpy 整结构体、跨语言接口、文件格式)。检查手段也现成:static_assert 比对 sizeof,布局一变编译立刻报错——用编译器当账房巡检员。
⚠️ 常见坑:为省内存给字段全上 bit field。位域的跨字节访问与对齐行为实现定义味道浓,跨编译器差异坑过无数序列化代码;只对真正的标志位集合使用,且对外传输一律走显式序列化。
本节要点回顾
- 对齐是硬件要求:字段落在自身边界,访问才正确且快;编译器自动塞垫片。
- 三条规则:成员对齐自身、整体对齐最严成员、顺序即成本。
- 从大到小排成员:零成本纪律,大数组场景收益按元素数放大。
- alignas 主动加严:隔伪共享(64)、SIMD 边界(16 或 32)、DMA 边界;不能放松。
- 尺寸即空间账:padding 是有意浪费,要花在刀刃上(伪共享隔离),别浪费在乱序上。
- 布局不对外负责:跨平台传输用显式序列化,static_assert 看 sizeof 当巡检。
账本摊到硬件上也算完了。收官一节请出第三方审计:sanitizer 在运行期抓坏账现行、静态分析在编译期查守则违例——把前五章的人工审计升级成流水线上的自动防线。