第一章 入线检查:图像如何变成数据
第一章 · 入线检查:图像如何变成数据
本章要回答的三个问题:为什么图像识别比多数人想的难得多?为什么最后胜出的是卷积神经网络而不是更聪明的规则?一张图片在被模型处理之前,要经过哪些"入线手续"变成张量?本章是整条流水线的进料口,后续所有章节都建立在这三个答案之上。
为什么会有这一章
很多教程从卷积公式直接开讲,读者背下了公式却答不上一个更基本的问题:模型拿到的到底是什么。答案是一堆浮点数——形状规整、经过归一化的多维数组。进料口混乱,车间必然混乱:尺寸不对、通道顺序搞反、数值没归一化,这些入线问题贡献了初学者一半以上的报错。
把这一章放在最前面还有一层用意:先看清"识别为什么难",才能体会卷积的两个关键设计(局部连接与权值共享)到底解决了什么。不带着问题读原理,原理就只是条文。
读完能解决什么
对照开篇的三个问题,读完本章你应当能:
- 举出至少三类让传统规则方法崩溃的真实场景(光照、视角、形变),并解释为什么像素级的比对注定失败;
- 说清手工特征(SIFT、HOG)的工作思路与天花板,理解"特征要从数据里学"这一步为什么是分水岭;
- 用参数量账目证明全连接网络处理图像不现实——这个账目在 1.2 有一笔可复算的对照;
- 把任意一张图片按正确的通道数、尺寸与数值范围读成 PyTorch 张量,说出 NCHW 每个字母的含义;
- 独立排查"通道顺序反了""数值范围错了""忘了归一化"这三类最常见的入线事故。
各节怎么分工
| 节号 | 回答的问题 | 关键产出 |
|---|---|---|
| 1.1 图像识别难在哪 | 规则与手工特征为什么走不通 | 识别难题清单与学习时代的入场理由 |
| 1.2 局部连接与权值共享 | 卷积凭什么胜出 | 参数量对照账与两条归纳偏置 |
| 1.3 图像数据基础 | 图片如何变成规范张量 | 一套可复用的入线检查代码 |
本章巡检路线
图 1-1 入线检查区布局
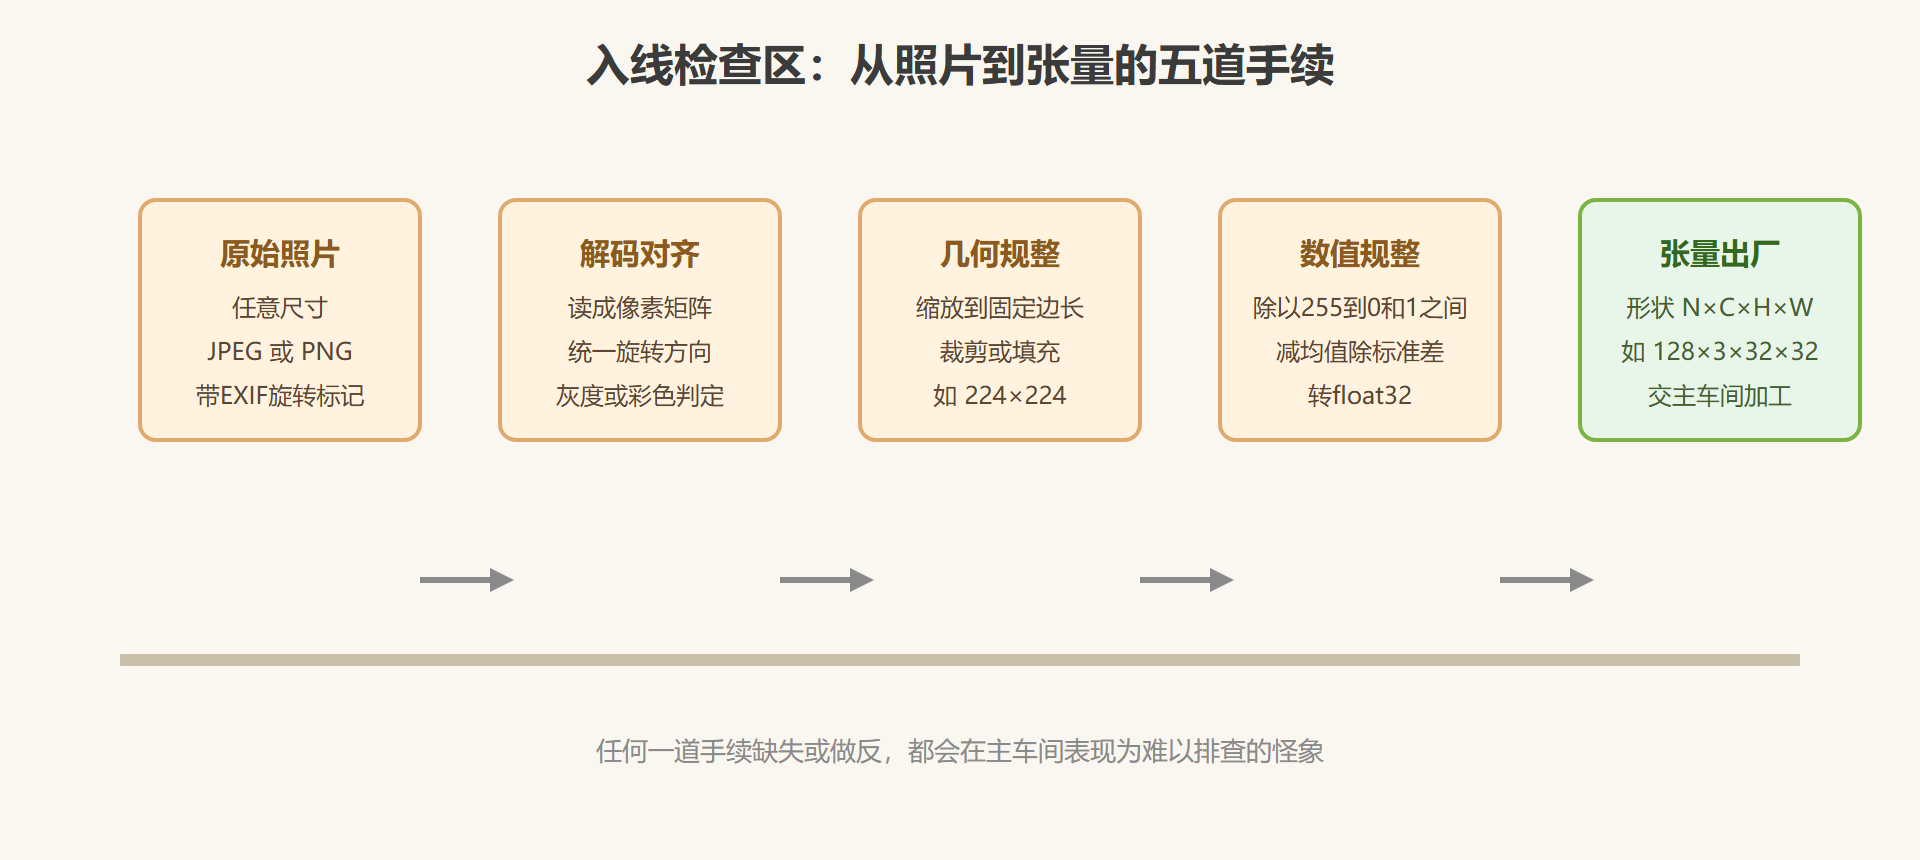
动手前自测
动笔写代码前,先用三道小题确认装备到位。其一:一张 64×64 的灰度图和一张 64×64 的彩色图,张量形状各是多少?答:1×64×64 与 3×64×64,差别只在通道维。其二:128 张 224 分辨率彩图组成一批,仅输入本身占显存约多少?答:128×3×224×224×4 字节约 73.5 MiB,训练时还要乘上激活与梯度的倍数。其三:为什么像素距离不可靠?答:类内变化(平移、光照)可能大于类间差异,1.1 节那个 2.83 对 2.45 的小账就是证据。三题都对,继续往下;卡住了,回到对应小节再读一遍。
本章工具清单
带走三样工具离开进料口。一是形状语言:NCHW 四维的报读方式,全册通用;二是对账公式:显存 = 元素数乘四字节,输入侧的账随时心算;三是排查口诀:形状、通道序、数值范围三查,先于一切调参。工具虽小,1.3 节那两类"不报错只掉分"的事故(通道颠倒、忘除 255)全靠它们提前拦截。工程习惯的差距,往往就是从进料口开始拉开的。
先决条件
- 会用 Python 做基本的数组操作,知道 NumPy 数组的形状概念;
- 装有 PyTorch(本章代码只用最基础的张量与网络层接口);
- 不需要任何深度学习先修知识,需要的数学不超过乘法与取整。
往下走到哪
本章结束的地方,正是第二章主车间的入口:一张 32×32 的彩色图像已变成形状 (1, 3, 32, 32) 的张量。下一章开始,卷积核、激活函数、池化层将在它身上依次作业,你会亲眼看着这个形状在流水线上逐站变形,并学会为每一站登记参数量账目。