2.1 卷积层:特征检测的第一道工序
2.1 卷积层:特征检测的第一道工序
本节摘要:卷积层是主车间的核心工位:一个小小的系数矩阵(卷积核)在输入上滑动,每个位置做加权求和,把"这里有没有某种局部模式"写成特征图上的一个数。本节手把手演算一次 3×3 卷积,给出参数量与乘加次数的通用公式,并用框架验证手工结果——这是全书一切形状与参数对账的原点。
一句行话开场
圈子里聊网络常说"这一层感受野多大""核开 3×3 还是 5×5"。听懂这句行话,就听懂了卷积层的全部:核(kernel)是探测器,感受野(receptive field)是探测器的视野,特征图(feature map)是探测器在全图上打分的成绩单。本节把这三样东西逐一拆开称重。
学习目标
阅读完本节,你应当能够:
- 在纸上完整演算 3×3 卷积核扫过 5×5 输入的九个输出值;
- 写出并使用两条公式:卷积层参数量与乘加次数;
- 解释多通道输入时核为什么是"三维"的,多核为什么堆出新通道;
- 指出深度学习里的"卷积"与数学教科书里"卷积"的差异。
一、卷积在算什么:滑窗与加权求和
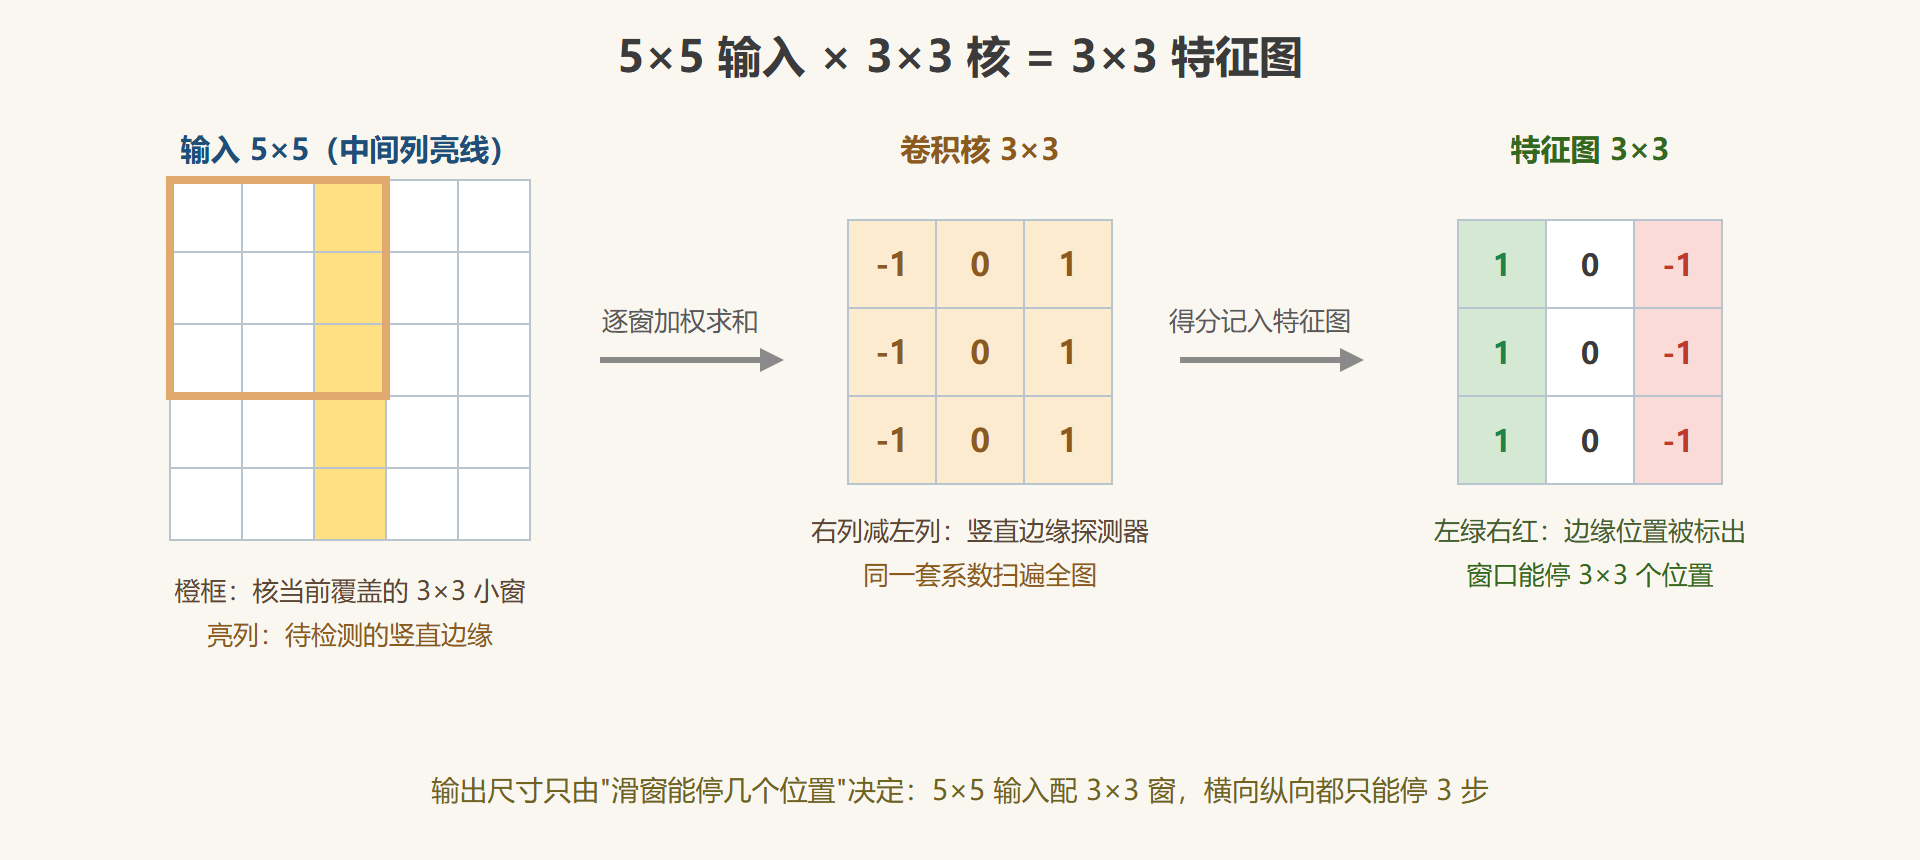
想象一张 5×5 的灰度图,中间一列是亮线。我们想回答的问题是:每个位置附近有没有"左暗右亮"的竖直边缘?做法是拿一个 3×3 的核,比如左列全为 -1、右列全为 1、中列为 0——它计算的正是"右邻减左邻"。核从左上角开始,每次覆盖 3×3 的小窗,把对应位置的数相乘再全部加起来,得到一个数,记在特征图上;然后向右滑一格,重复;扫完一行下滑一行。5×5 的输入、3×3 的窗,横向只能停 3 个位置、纵向也是 3 个,输出就是 3×3 的特征图。
import torch import torch.nn.functional as F x = torch.zeros(1, 1, 5, 5) x[0, 0, :, 2] = 1.0 # 第 2 列一条亮竖线 k = torch.tensor([[[[-1., 0., 1.], [-1., 0., 1.], [-1., 0., 1.]]]]) # 左右取差的竖直边缘核 y = F.conv2d(x, k) print(y[0, 0]) # tensor([[ 1., 0., -1.], # [ 1., 0., -1.], # [ 1., 0., -1.]])
逐格解释这份输出:亮线左边的窗口算出 +1(右邻亮、左邻暗),压着亮线的窗口正负相抵得 0,亮线右边的窗口是 -1(左邻亮、右邻暗)。一正一负夹着一个零,恰好在特征图上标出了边缘的位置与朝向——卷积没有魔法,它只是把一个提问(这里有没有某种模式)变成了一张评分图。真实网络里的核系数不由人手写,由训练学出来,但运算一字不差。
顺带澄清一个名不副实:数学卷积要求先把核旋转 180 度再滑动,深度学习框架里的"卷积"其实省略了翻转(术语叫互相关)。因为核系数是学出来的,翻不翻转只是把学到的系数换了个方向,不影响表达能力——行业里叫惯了,也就不必较真。
图 2-2 卷积核滑窗标注示意
二、多通道与多核:账目怎么算
真实图像是 RGB 三通道,核因此必须有同样的"厚度":3×3 的核在彩色图上其实是 3×3×3,27 个系数同时覆盖三个通道的邻域,求和后输出一个数。这是一条容易忘的账:核的通道数永远等于输入通道数。
而一张特征图只回答一种提问。想知道"有没有竖直边缘、有没有水平边缘、有没有红色斑块",就要多个核各自扫一遍。用 16 个核,得到 16 张特征图,摞起来正好是新一层输入的 16 个通道——输出通道数等于核的个数,这就是特征图厚度逐层变化的来源。
两条公式由此立起来,全册通用:
参数量 = 核高 × 核宽 × 输入通道 × 输出通道 + 输出通道(偏置) 乘加次数 = 输出通道 × 输出高 × 输出宽 × 核高 × 核宽 × 输入通道
import torch import torch.nn as nn conv = nn.Conv2d(3, 16, kernel_size=3) # 输入 3 通道,16 个 3×3 核,不填充 n_params = sum(p.numel() for p in conv.parameters()) print("参数量:", n_params) # 448 = 3×3×3×16 + 16 x = torch.randn(1, 3, 32, 32) out = conv(x) print("输出形状:", tuple(out.shape)) # (1, 16, 30, 30) 32−3+1=30 macs = 16 * 30 * 30 * 3 * 3 * 3 print("乘加次数:", macs) # 388800
给这两条账一个体感:仅这一层,38.9 万次乘加就把一张小图换成了 16 张评分图;层数加深、通道翻倍后,乘加量按核高×核宽×输入通道×输出通道的乘积猛涨——第三章对比 VGG 与 MobileNet 的省算力之争,账本用的正是这条公式。
三、工程要点:核尺寸的选择直觉
- 3×3 是默认答案:同样 27 个系数的预算下,两层 3×3 串联的视野等于一层 5×5,还多了一次非线性;参数还更省(详见 3.3 节 VGG 的账目);
- 大核并未绝迹:输入分辨率很高、目标纹理很大的场景(如遥感、医学影像),首层用 7×7 甚至更大的核反而高效;
- 偏置可省:卷积后若紧跟批归一化(4.5 节),偏置的作用会被归一化吸收,不少实现干脆设 bias=False。
⚠️ 常见坑:手算形状时忘了核的"厚度"。 Conv2d(3, 16, 3) 的单个核是 3×3×3 而不是 3×3,参数量差 3 倍——对账对不上时,第一个该检查的就是通道维。
巡检记录
- 一次卷积 = 一个提问:核是提问的模板,特征图是模板在全图的打分,输出尺寸只由滑窗能停几个位置决定;
- 两条公式:参数量看"一个核多重 × 几个核",乘加次数再乘上"停多少个位置",本节算得 448 参数、38.9 万次乘加;
- 厚度守恒:核通道数 = 输入通道数,输出通道数 = 核个数,层与层之间的形状由此衔接;
- 互相关之辨:框架的"卷积"不做核翻转,这是工程惯例而非数学疏漏。
特征图的尺寸由滑窗决定,而滑窗的节奏有三个旋钮可以调。下一节把核尺寸、步幅、填充拆开,给出那条全书出场率最高的输出尺寸公式。