2.2 卷积的三个旋钮:核尺寸、步幅与填充
2.2 卷积的三个旋钮:核尺寸、步幅与填充
本节摘要:决定卷积输出形状的只有三个量——核尺寸、步幅、填充。输出尺寸公式 floor(输入 + 2×填充 − 核尺寸)÷ 步幅 + 1 是 CNN 工程师用得最多的一条算术。本节用五种典型配置逐一验证公式,再引入感受野的累加算法,让你在搭网络前就能把每一层的形状与视野预算清楚。本节为新增内容,是 2.6 全链路巡检的数学基础。
先看三起事故现场
搭建 CNN 时最常撞上的报错都长一个样:特征图进入全连接层时尺寸和网络定义差了一点;两个分支拼接时宽高对不齐;深层网络的输出莫名缩成了 1×1。三起事故的根子是同一个——没人在动工前算过形状。卷积层的形状不靠试,靠公式。本节的任务就是把公式和它的三个旋钮焊进你的手感。
学习目标
阅读完本节,你应当能够:
- 背出输出尺寸公式,并在心里执行向下取整;
- 说出"same 卷积"(尺寸不变)与"half 卷积"(尺寸减半)的标准旋钮配置;
- 用累加法算出任意深度网络中某神经元能看到的原始输入范围;
- 解释 1×1 卷积存在的意义——它不改变视野,改的是通道。
一、公式与三个旋钮
把滑窗想象成在一条长为 L 的路上每隔 s 步停一次:能停的位置数就是 floor((L - k) / s) + 1,其中 k 是窗宽。图像有高宽两个方向,公式各算一遍;填充 p 先在四周补 p 圈零,把路加长成 L + 2p。于是:
输出尺寸 = floor((输入尺寸 + 2×填充 − 核尺寸) ÷ 步幅) + 1
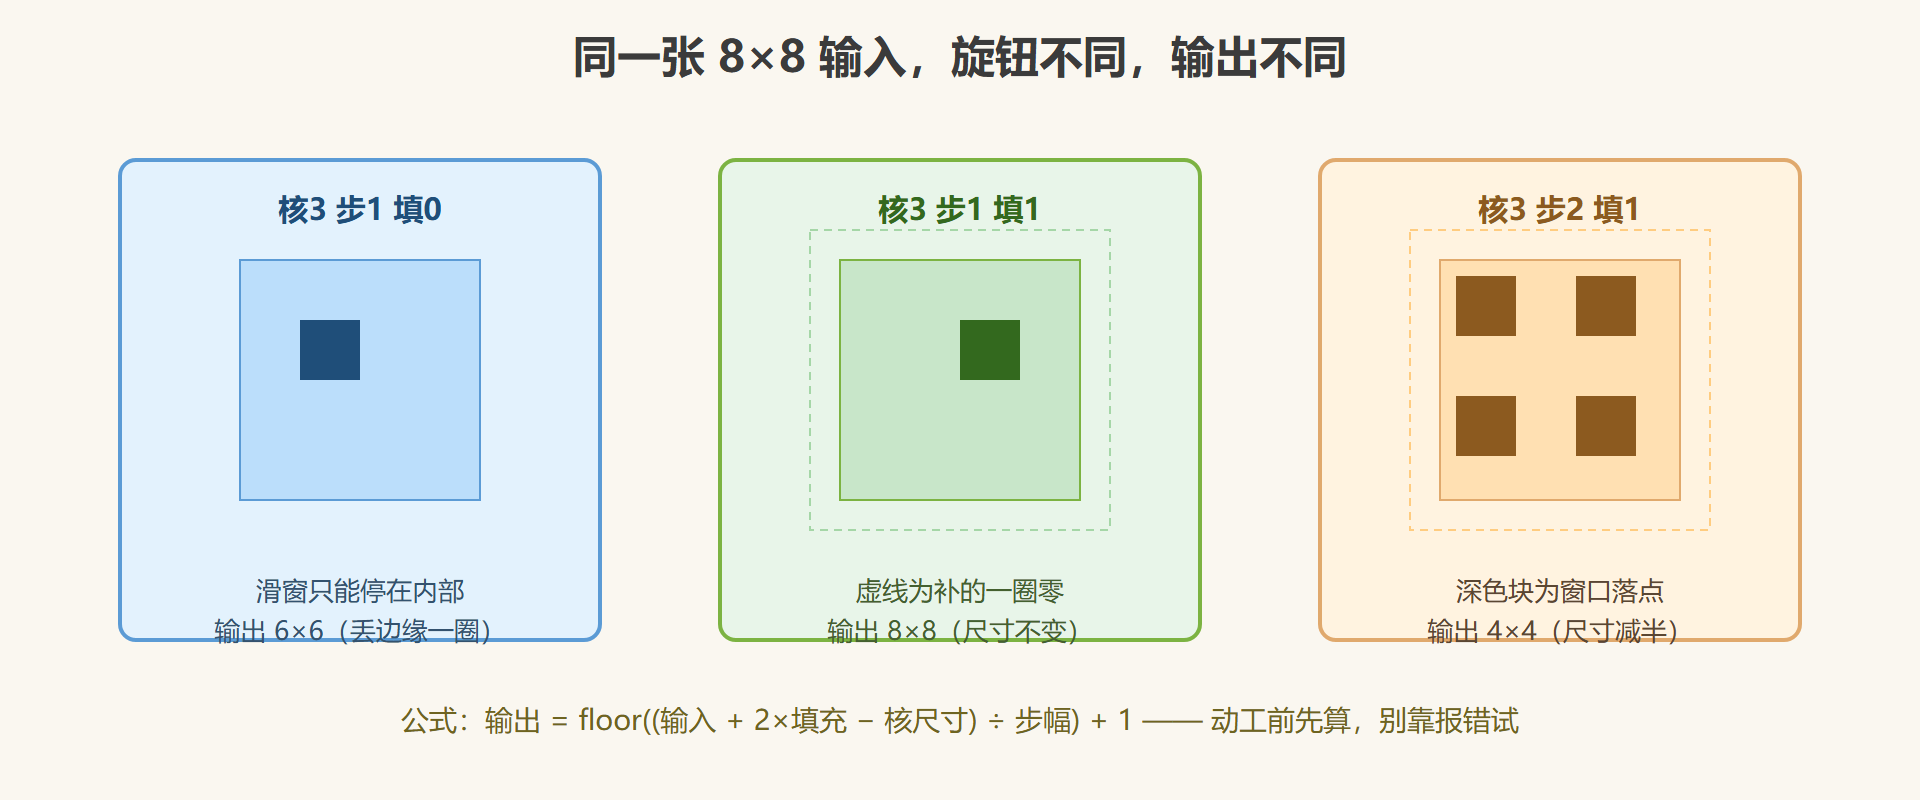
三个旋钮各管一事:核尺寸决定一次看多大、参数多重;步幅决定滑多快、输出缩多少;填充决定边缘信息被牺牲多少、输出保多大。两个高频配置值得背下来:核 3、步幅 1、填充 1 时输入输出同尺寸(same);核 3、步幅 2、填充 1 时尺寸减半(half)——几乎所有现代 CNN 的"下采样卷积"用的就是后者。
import torch import torch.nn as nn x = torch.randn(1, 3, 32, 32) configs = [(3, 1, 0), (3, 1, 1), (3, 2, 1), (5, 1, 2), (7, 2, 3)] for k, s, p in configs: conv = nn.Conv2d(3, 8, kernel_size=k, stride=s, padding=p) out = conv(x) expect = (32 + 2 * p - k) // s + 1 assert out.shape[-1] == expect, "公式与框架不一致!" print(f"核{k}×{k} 步幅{s} 填充{p} → 输出 {tuple(out.shape)},公式值 {expect}")
运行后五行输出与下表逐一对上,公式即可放心上岗:
| 配置(核/步幅/填充) | 32×32 输入的输出 | 用途 |
|---|---|---|
| 3×3 / 1 / 0 | 30×30 | 不保边缘的老式用法 |
| 3×3 / 1 / 1 | 32×32 | same 卷积,特征图不变小 |
| 3×3 / 2 / 1 | 16×16 | half 卷积,代替池化下采样 |
| 5×5 / 1 / 2 | 32×32 | 大视野的 same 卷积 |
| 7×7 / 2 / 3 | 16×16 | 高分辨率输入的首层常用 |
图 2-3 三个旋钮如何改变输出尺寸
二、感受野:视野怎么随深度长大
形状之外,第二个该预算的量是感受野——深层某个神经元倒推回原始输入能"看到"多大区域。累加法两条规则:过一层核 k、步幅 s 的层,视野增量 = (k−1)×当前累积步距,然后累积步距更新为自身乘 s。3×3 步幅 1 的卷积每层让视野加 2,池化层则让后续所有层的"每步视野"翻倍。
layers = [("卷积一", 3, 1), ("卷积二", 3, 1), ("池化", 2, 2), ("卷积三", 3, 1)] r, j = 1, 1 # r 当前感受野,j 累积步距 for name, k, s in layers: r = r + (k - 1) * j j = j * s print(name, "后 感受野 =", r) # 卷积一 后 3;卷积二 后 5;池化 后 6;卷积三 后 10
这张小账目解释了 CNN 分层的全部理由:浅层视野小、只配看见边缘与斑块;池化一压,同样 3×3 的核在原始图上的视野立刻翻番,深层才有资格谈论"耳朵""车轮"这种大结构。想让高层看得更宽,要么加深、要么下采样、要么上大核——三选一的取舍贯穿第三章所有机型。
三、1×1 卷积:不变视野,变通道
把核尺寸压到 1×1、步幅 1、填充 0,输出尺寸与输入完全相同——它不看任何邻域,在每个像素位置上对通道维做一次全连接。听起来无用,其实是主车间里的"阀门工位":把几十个通道压缩或放大的活儿交给它,比用大核便宜得多。3.4 节 GoogLeNet 用它在分支入口"先降维再卷积",参数量立省数倍;3.6 节 MobileNet 的逐点卷积,本质也是 1×1。
设计惯性可以总结成三句话:**想提模式,调核尺寸;想缩图,调步幅;想保边缘,加填充;想省参数,请 1×1 出场。**三个旋钮加上这条口诀,搭任何骨架前都能先在纸上把形状铺满。
补三笔进阶账
第一笔,非对称核:把一个 3×3 拆成 1×3 加 3×1 两层串联,视野仍是 3×3,参数从 9C² 降到 6C²(同宽 C 时),省三分之一——Inception v3 的经典手法,适合参数吃紧的场合。第二笔,空洞卷积:给 3×3 核设膨胀率 2,核的参数一个不增,感受野却按 k+(k−1)×(d−1) 扩到 5,代价是被跳过的像素不参与计算、细纹理可能漏采,分割网络常用它换视野。第三笔,负数尺寸:当 核尺寸 大于 输入加两倍填充 时,公式给出负值、框架直接报错——公式不只管预测,也是配置合法性的检验器。
巡检记录
- 一条公式管所有卷积形状:floor((输入 + 2p − k) ÷ s) + 1,向下取整别忘;
- 两个标准位:3/1/1 保尺寸,3/2/1 减半——现代网络的节奏基本由这两拍构成;
- 感受野累加:增量 (k−1)×累积步距,池化让累积步距翻倍,四层小账算出 3→5→6→10;
- 1×1 卷积:视野不变、通道任捏,是省参数的专用阀门。
形状的账此后再也难不倒你。下一节处理另一个根本问题:流水线上全是线性运算会怎样,为什么非要插一道非线性。