2.3 激活函数:流水线上的非线性阀门
2.3 激活函数:流水线上的非线性阀门
本节摘要:激活函数对特征图逐元素做一次非线性变换——最常用的 ReLU 只做一件事:负数归零、正数放行。它是整条流水线里唯一零参数却不可省的工位:拿掉它,一百层卷积也会塌缩成一次线性变换。本节用实验证明这种塌缩,比较 Sigmoid、tanh、ReLU 三代阀门的脾气,并交代 ReLU 的软肋与后继者的修补思路。
十层线性,塌成一层
先做一个能亲手验证的思想实验:卷积是加权求和,全连接是加权求和,串联一百层,数学上仍然是"输入乘一个大矩阵"——线性运算的复合还是线性运算。网络再深,能表达的也不过是一条直线能表达的映射,深度白给。下面用代码把这句话钉死。
import torch import torch.nn as nn torch.manual_seed(0) x = torch.randn(1, 8) lins = [nn.Linear(8, 8) for _ in range(10)] y = x for lin in lins: # 十层纯线性层直接串联 y = lin(y) W_eff = torch.eye(8) for lin in lins: # 把十层权重乘成一个大矩阵 W_eff = lin.weight @ W_eff print("十层等价于一次线性变换:", torch.allclose(y, x @ W_eff.T, atol=1e-4)) # True —— 不加非线性,深度毫无意义
阀门的存在理由就藏在输出里:每层卷积之后过一次非线性函数,两层之间才产生"弯折",网络才能拼出任意复杂的判别边界。这也是为什么激活工位在图纸上出现频率最高——几乎每个卷积核后面都跟着它。
学习目标
阅读完本节,你应当能够:
- 解释"线性复合仍是线性",说明激活函数不可省的数学原因;
- 画出 Sigmoid、tanh、ReLU 的曲线并指出各自的饱和区;
- 复算 Sigmoid 的最大导数 0.25,说清深层网络梯度消失的来源之一;
- 描述 ReLU 的死亡现象与 Leaky ReLU、GELU 的修补思路。
一、三代阀门的曲线脾气
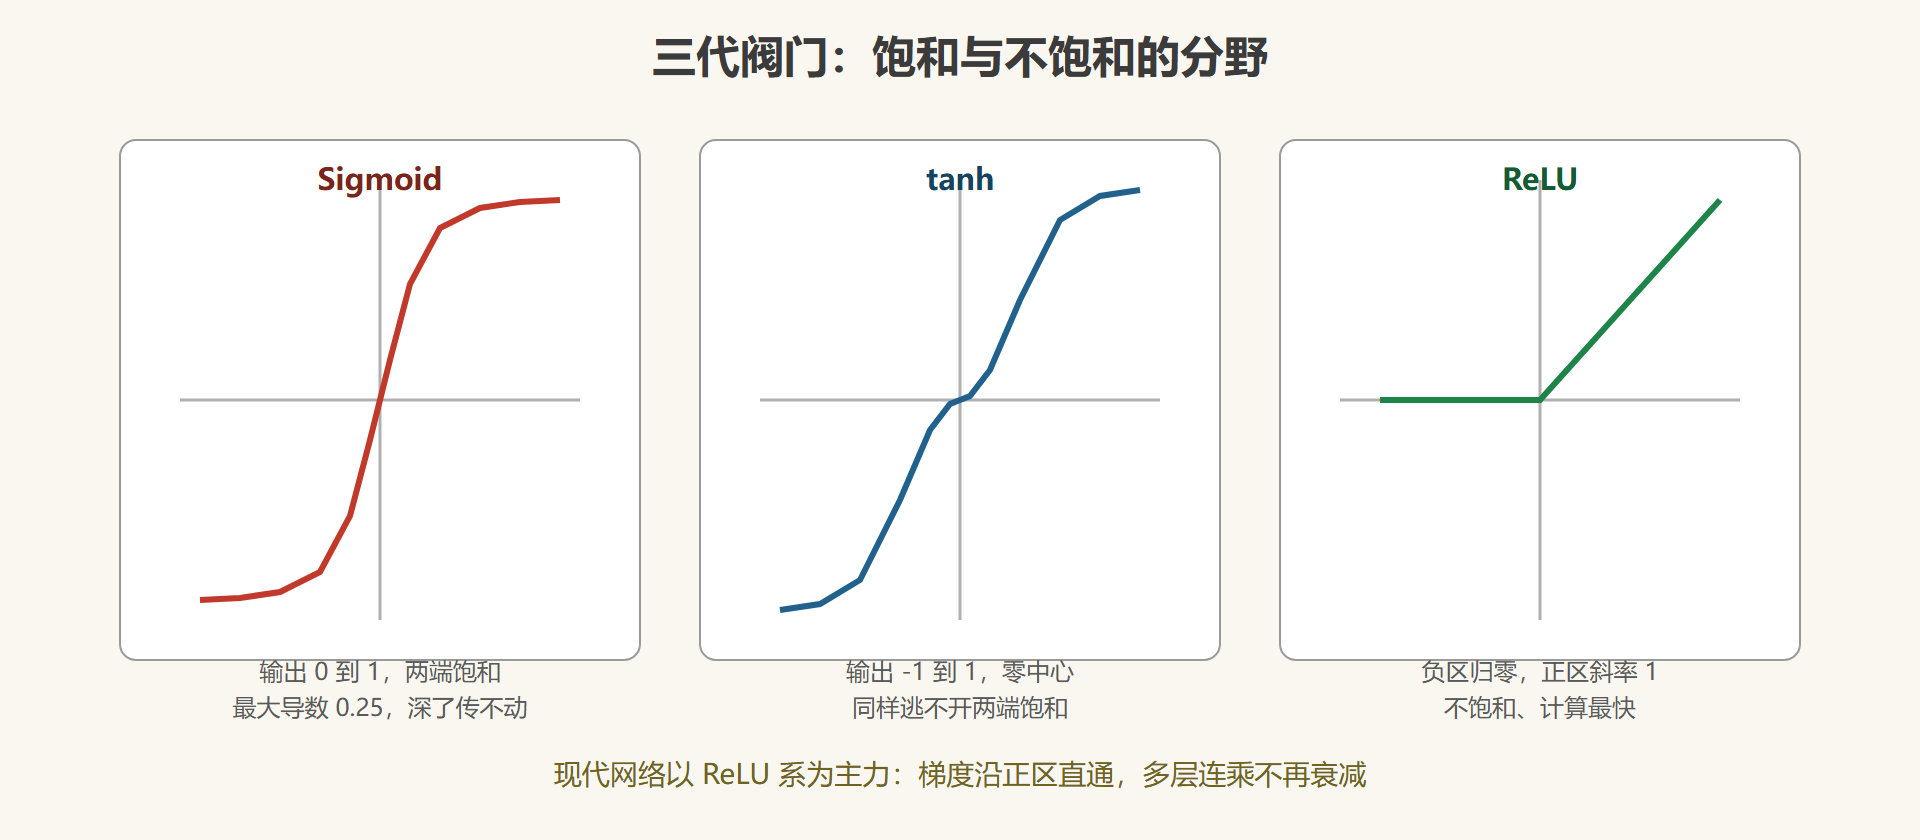
第一代 Sigmoid 把任意实数压进 0 到 1,天然适合表示概率,早年是标配。第二代 tanh 把输出压到 -1 到 1,零中心化让收敛更顺。两代共享同一个软肋:两端平坦。输入一旦落入饱和区,导数趋近于零——第四章会讲到,反向传播靠导数逐层相乘来传递误差,一串小于 1 的数连乘,传到浅层就所剩无几,深层网络于是"训不动"。第三代 ReLU 干脆放弃压缩:正数原样通过,负数归零。正半轴导数恒为 1,梯度畅通无阻;计算只需要一次比较,快得不像话。
import torch z = torch.tensor([-6.0, -1.0, 0.0, 1.0, 6.0]) sig = 1.0 / (1.0 + torch.exp(-z)) relu = torch.relu(z) print("Sigmoid:", [round(v, 4) for v in sig.tolist()]) # [0.0025, 0.2689, 0.5, 0.7311, 0.9975] 两端贴近 0 和 1,进入饱和 print("ReLU: ", relu.tolist()) # [0.0, 0.0, 0.0, 1.0, 6.0] 负数掐断,正数原样放行 s0 = 1.0 / (1.0 + 0.0) # 输入为 0 时的 Sigmoid 值 0.5 print("Sigmoid 在 0 处的导数:", round(s0 * (1 - s0), 4)) # 0.25,这是它的导数上限
最后一行算的是导数上界:Sigmoid 的导数是 s(1−s),在 s=0.5 处取得最大值 0.25。把它放进十层网络想象一下:误差传回浅层时哪怕每层都取到最大值,也只剩 0.25 的十次方——不到百万分之一。饱和区的导数更是趋近于零。梯度消失不是玄学,是能精确算出来的连乘。
图 2-4 三代激活函数曲线对比
二、ReLU 的软肋与修补
ReLU 不是没有代价。负半轴输出恒为零、导数也恒为零,若某个神经元的输入在训练中被推成永远为负,它从此对任何样本都沉默、梯度也永远为零——这叫神经元死亡。成因多半是学习率过大把偏置打进了深负区。修补思路都很直白:给负半轴留一条细缝。Leaky ReLU 让负数乘一个 0.01 的小斜率通过;PReLU 干脆让斜率可学习;ELU 与 GELU 把负半轴修成平滑曲线,后者在现代 Transformer 系里也是常客。CNN 场景下,ReLU 与它的带缝变体足矣。
安插位置也有讲究:惯例是"卷积、激活、池化"三连,激活夹在中间,让池化面对的是已经掐过零的非负响应。残差网络等新机型里顺序会有微调(先激活后卷积的预激活设计),但"每层之间必须有非线性"这条底线从不动摇。
| 阀门 | 输出范围 | 正区导数 | 负区行为 | 典型位置 |
|---|---|---|---|---|
| Sigmoid | 0 到 1 | 最大 0.25 | 饱和趋零 | 二分类输出层、门控 |
| tanh | -1 到 1 | 最大 1 | 饱和趋零 | 早期隐藏层、RNN |
| ReLU | 0 到正无穷 | 恒为 1 | 归零(可死亡) | CNN 隐藏层默认 |
| Leaky ReLU | 负无穷到正无穷 | 恒为 1 | 小斜率 0.01 通过 | 怕死亡的场合 |
你可能会问
问:ReLU 之后紧跟池化,两个"压缩"动作叠着不冲突吗?答:不冲突,掐零丢的是"负的响应",池化丢的是"窗口内的位置细节",一个管数值、一个管空间。问:GELU 是什么,CNN 里能用吗?答:它是 ReLU 的平滑版,用概率积分做"软性掐零",Transformer 系的默认选择;CNN 里换上通常无害,收益看任务再定。问:激活为什么设计成逐元素?答:逐元素才便宜,且不改变形状与通道数——它是流水线上唯一零参数、零形状代价却能改变网络性质的工位。
巡检记录
- 不可省的工位:线性复合仍是线性,十层不加激活等于一层——深度学习的深度,是激活函数买来的;
- 梯度账:Sigmoid 最大导数 0.25,十层连乘不足百万分之一,深层网络的梯度消失可以精确复算;
- ReLU 哲学:不压缩、只截断,正区梯度恒通;代价是负区可能整只神经元死亡,带缝变体负责兜底;
- 安插惯例:卷积后、池化前,逐元素作用,形状永远不变、参数永远是零。
阀门装好,信号全是非负响应了。下一工位做减法:池化层把特征图收小一圈,顺便练出对位置抖动的容忍。