第三章 经典机型巡检档案
第三章 · 经典机型巡检档案
本章要回答的三个问题:卷积、激活、池化这三样工位,是怎么被六代机型一步步排出如今的面貌?每一代机型到底解决了上一代的哪个瓶颈——深度上不去、参数下不来,还是算力吃不消?今天做项目时,凭什么依据挑骨架?本章像翻档案柜:六份机型报告各配结构账目与代码,读完你能把任何 CNN 架构图翻译成第二章的巡检单。
为什么会有这一章
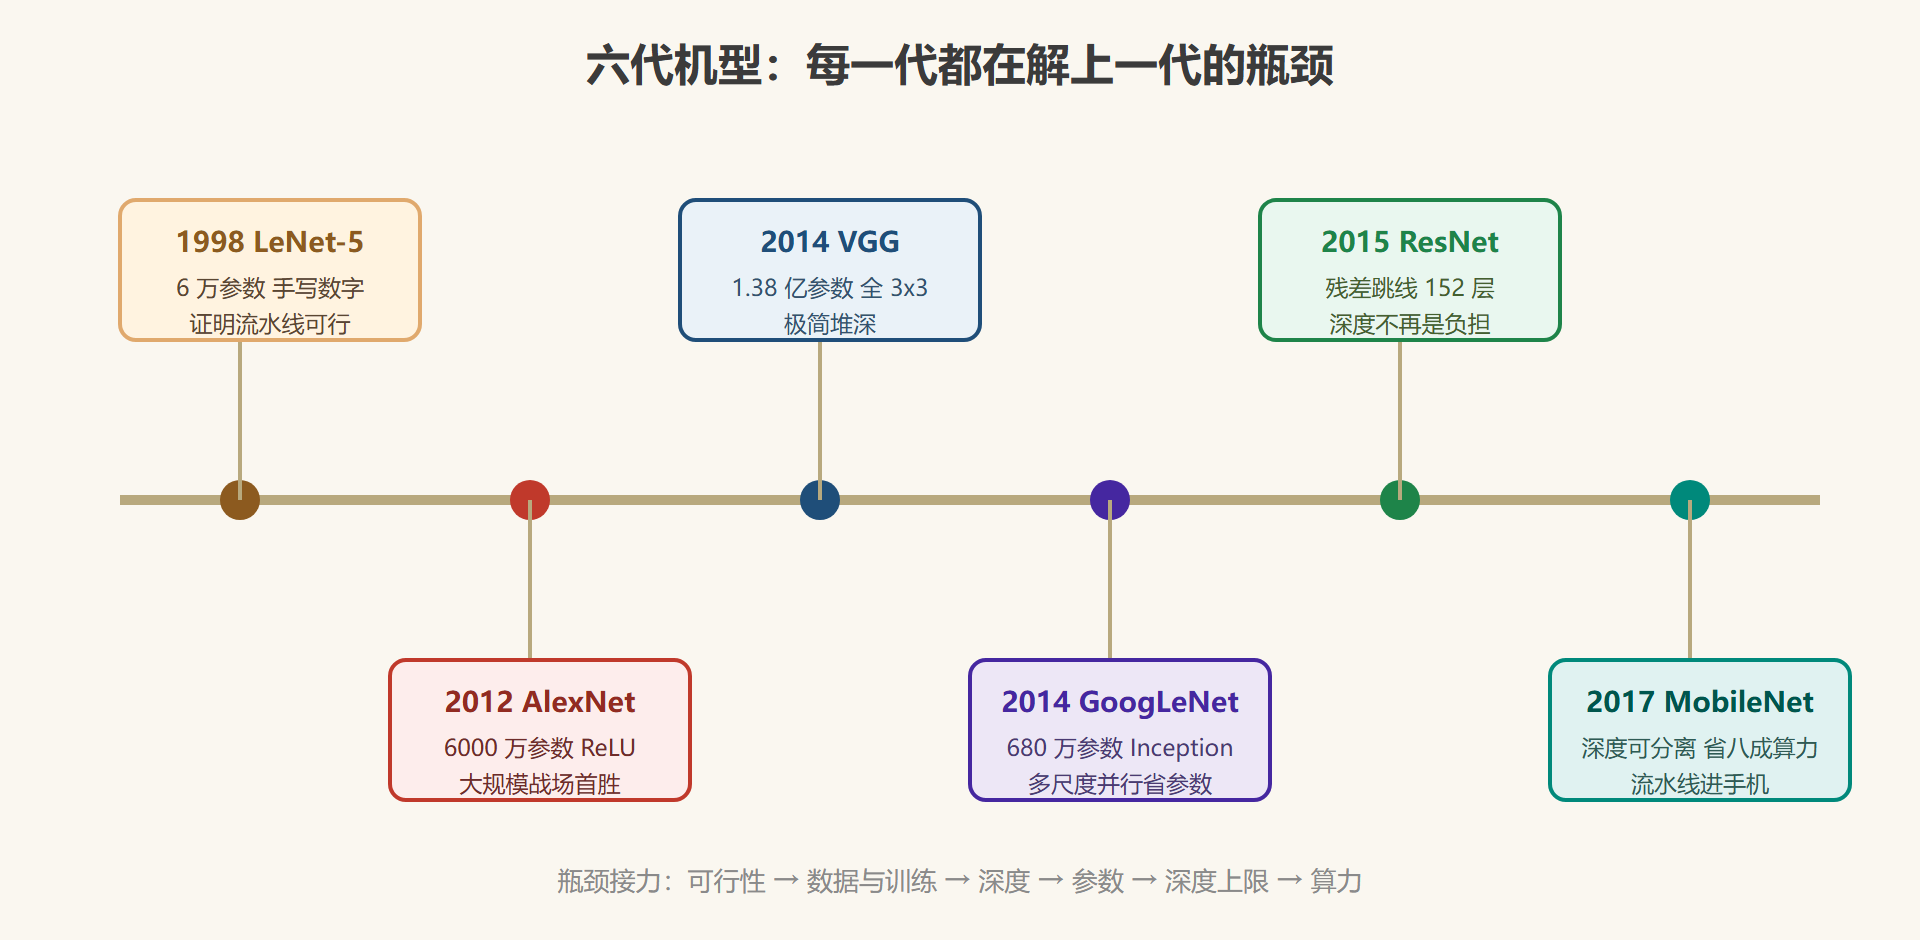
第二章的 TinyCNN 是台完美的教学机,但它只有两层卷积——真实世界的问题很快会逼你回答:为什么不能无限加深?为什么有的网络参数上亿、有的只有几百万?这些问题的答案不在论文的公式里,而在演化史里。每一代经典机型的诞生都对应一个具体瓶颈:LeNet-5 证明了流水线可行,AlexNet 把它推上大规模战场,VGG 用极简主义把深度推高,GoogLeNet 用并行分拣把参数砍掉一个数量级,ResNet 用残差跳线解锁了上百层,MobileNet 一族把整条流水线塞进手机。
按瓶颈读架构,比按年份背名字有效得多。每份机型报告都采用同一套读法:它继承什么、瓶颈是什么、关键改动是什么、参数量怎么变化。读完六份,你看新论文里的结构图时,眼睛会自动去找"它解决的是哪一格瓶颈"。
读完能解决什么
- 手算 LeNet-5 的 61,706 个参数都在哪几层,理解"分类头占大头"的病根从第一代就埋下;
- 说出 AlexNet 的四项关键改动(ReLU、Dropout、GPU 训练、数据增强)各对应什么瓶颈;
- 论证"两层 3×3 等效视野 5×5 还更省参数",并复算 VGG-16 的 1.38 亿参数构成;
- 解释 Inception 的多尺度并行与 1×1 降维,算出一组典型配置省多少参数;
- 实现 ResNet 的残差块,解释恒等捷径为何能让上百层网络正常训练;
- 用乘加账目证明深度可分离卷积约省八成算力,说清 MobileNet 的适用边界。
各节怎么分工
| 节号 | 机型 | 年代坐标 | 关键词 |
|---|---|---|---|
| 3.1 | LeNet-5 | 1998 | 首套完整流水线,手写数字 |
| 3.2 | AlexNet | 2012 | 深度学习引爆点,ReLU 与 Dropout |
| 3.3 | VGG | 2014 | 全 3×3 极简堆深 |
| 3.4 | GoogLeNet | 2014 | Inception 多尺度并行 |
| 3.5 | ResNet | 2015 | 残差跳线,百层可训 |
| 3.6 | MobileNet 一族 | 2017 起 | 深度可分离,端侧部署 |
机型谱系一览
图 3-1 六代机型演化时间线
翻档案前的自测
其一:VGG 的 1.38 亿参数里卷积占多少?答:约一成,大头全在全连接——"重的其实是分类头"是贯穿全章的主判词。其二:GoogLeNet 靠什么把参数压到 VGG 的二十分之一?答:大核支线入口的 1×1 降维加全局平均池化分类头。其三:深层普通网络训练误差反升,是过拟合吗?答:不是,训练误差自己变差说明是优化失灵,这正是残差跳线的靶子。三问三答都对,本章读起来就是六份按图索骥的验收报告;答不上,先回第二章把公式捡起来。
先决条件
- 第二章必须先读:本章所有账目都使用 2.1、2.2 节的参数公式与尺寸公式;
- 知道"过拟合"这个词的大概意思(4.6 节会正式讲),不影响读 3.2 节的 Dropout 段落;
- 不需要读过原始论文,每份机型报告都把动机讲在结构之前。
往下走到哪
档案翻完,你会发现六代机型其实是同一座主车间的六次改扩建:工位没换过,换的是排布方式与省料手法。第四章转向"质检与回炉"——这些流水线当年是怎么被训练到位的,以及你今天该如何复用它们的权重。