2.6 前向形状巡检:一条数据的完整走线与参数量对账
2.6 前向形状巡检:一条数据的完整走线与参数量对账
本节摘要:本章前五节逐一拆了工位,本节把它们连成整线:一张 32×32 的猫图走完"卷积、激活、池化、再卷积、再激活、再池化、展平、全连接"的全程,逐站登记形状、参数量与乘加次数,最后用代码对账。全册的数值锚点在此立桩——后面各章讨论任何机型,都可以回到这张巡检单核对口径。
巡检单怎么填
正式巡检前先定三列账目。第一列形状:每站出口张量的 C×H×W,用 2.2 节公式手算;第二列参数:每站新增的可学习权重数,卷积用"核积乘通道",池化与激活恒为零;第三列乘加:每站为这张图做了多少次乘加运算,衡量算力开销。三列都填完,这条流水线的性格就一目了然——参数花在哪、算力花在哪、瓶颈在哪一站。
学习目标
阅读完本节,你应当能够:
- 给一个小型 CNN 逐层手写形状推演,并解释每一步的公式依据;
- 用框架代码逐层打印形状与参数量,与手算结果对账;
- 心算全网络总参数与总算力,判断训练它需要什么量级的显卡;
- 把这套巡检流程迁移到第三章任何经典机型上。
一、被巡检的流水线:TinyCNN
主角是一个刻意做小的两段式流水线:两轮"3×3 卷积加 ReLU 加 2×2 池化",接全局判决头。它在 CIFAR-10 这类 32×32 小图上训练几分钟就能跑出像样的准确率,是做实验的理想靶机。结构定义如下:
import torch import torch.nn as nn class TinyCNN(nn.Module): def __init__(self): super().__init__() self.conv1 = nn.Conv2d(3, 16, kernel_size=3, padding=1) # 站一 self.conv2 = nn.Conv2d(16, 32, kernel_size=3, padding=1) # 站二 self.pool = nn.MaxPool2d(2, 2) # 池化复用 self.fc = nn.Linear(32 * 8 * 8, 10) # 站三 def forward(self, x): x = self.pool(torch.relu(self.conv1(x))) # 3×32×32 → 16×32×32 → 16×16×16 x = self.pool(torch.relu(self.conv2(x))) # 16×16×16 → 32×16×16 → 32×8×8 x = torch.flatten(x, 1) # 32×8×8 → 2048 return self.fc(x) # 2048 → 10 net = TinyCNN() x = torch.randn(1, 3, 32, 32) print(tuple(net(x).shape)) # (1, 10):一张图进去,十个类别分数出来
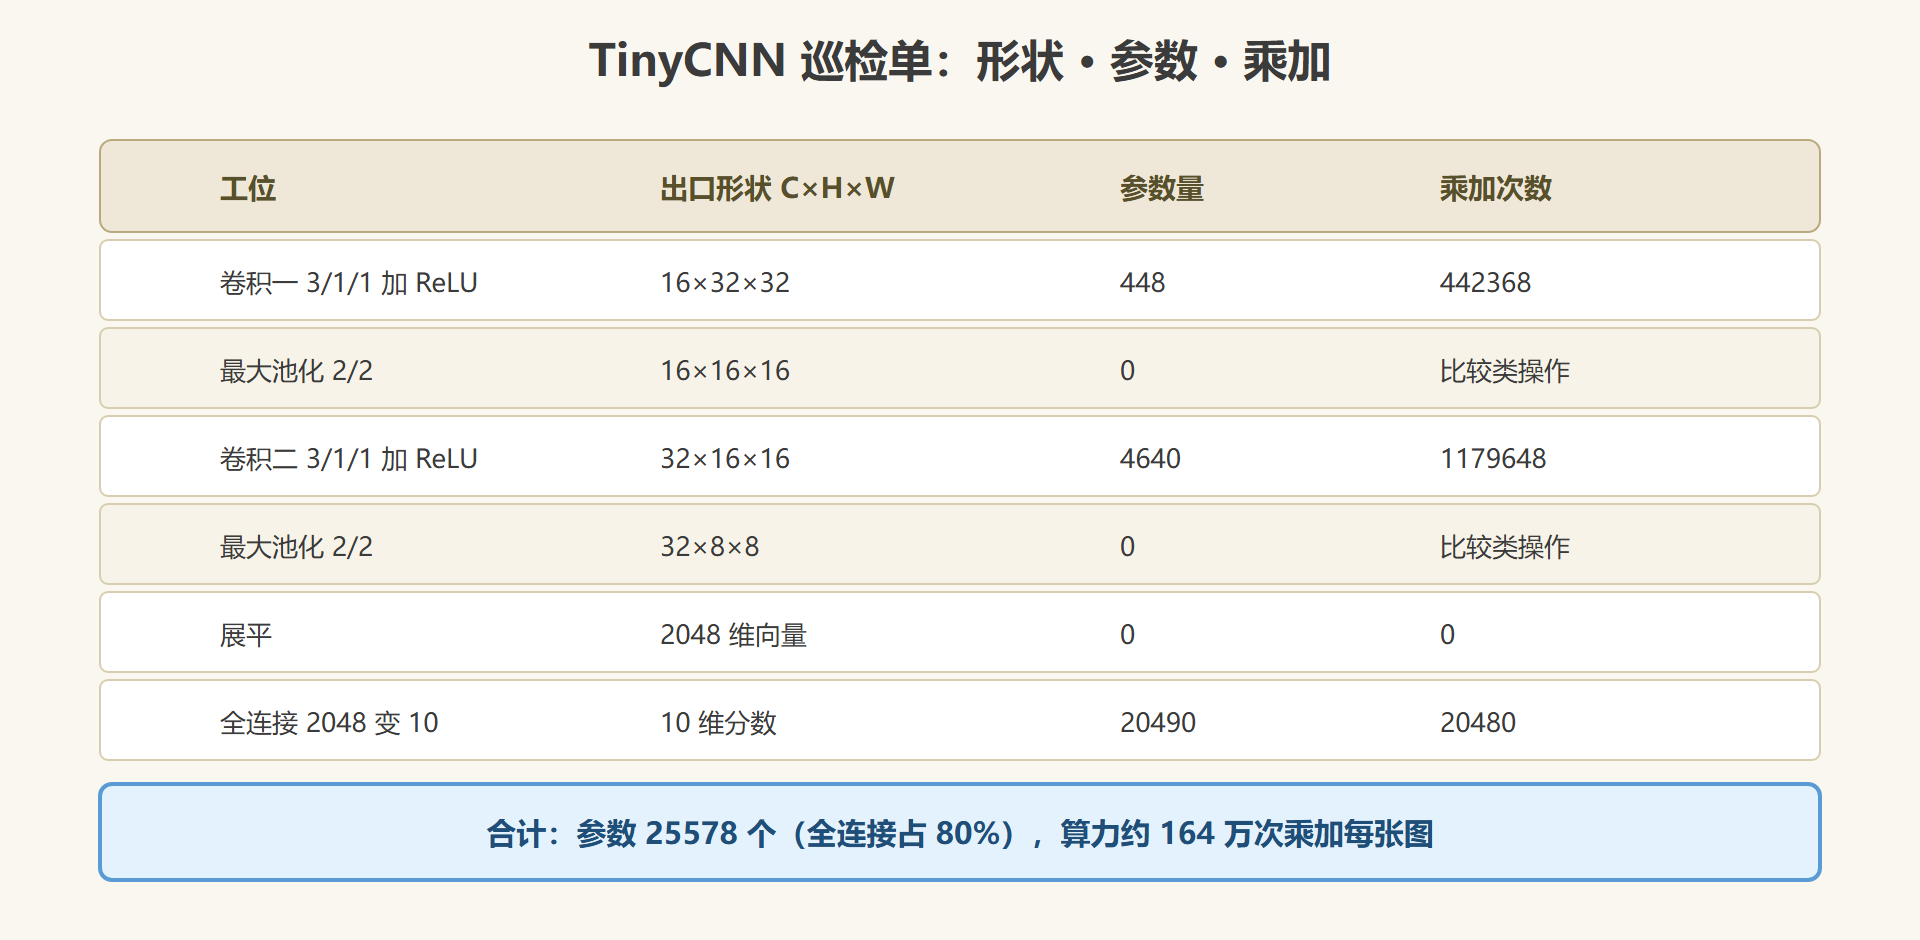
先在纸上把形状走一遍,再对照代码注释逐行验证:两次卷积都用"3/1/1"的 same 配置,尺寸保持;两次池化各减半;展平把 32×8×8 收成 2048 维。全程无一处意外,巡检单第一列即告成立。
二、参数与算力:两列账目
total = 0 for name, p in net.named_parameters(): print(f"{name:14s}{str(tuple(p.shape)):22s}{p.numel():>7d}") total += p.numel() print("总参数量:", total) # conv1.weight (16, 3, 3, 3) 432 # conv1.bias (16,) 16 # conv2.weight (32, 16, 3, 3) 4608 # conv2.bias (32,) 32 # fc.weight (10, 2048) 20480 # fc.bias (10,) 10 # 总参数量: 25578
手算复核一遍:conv1 是 3×3×3×16 加 16 个偏置得 448;conv2 是 3×3×16×32 加 32 得 4,640;fc 是 2048×10 加 10 得 20,490。合计 448+4,640+20,490 = 25,578,与框架输出分毫不差。2.5 节的"全连接是大头"在此再次应验:它凭一层占了八成。
算力账用乘加公式逐站累计:conv1 输出 16×32×32 个位置、每位置 27 次乘加,约 44.2 万;conv2 是 32×16×16 个位置、每位置 144 次,约 118 万;fc 是 2,048×10,约 2 万。合计约 164 万次乘加处理一张图——这个量级任何笔记本 CPU 都能实时跑动,也解释了为什么 TinyCNN 适合当教学靶机。第三章会看到,VGG-16 处理一张 224×224 图要上百亿次乘加,两条流水线的算力体量差着四个数量级。
图 2-5 TinyCNN 全链路对账板
三、把巡检迁移到任何机型
这套三列账是全册的通用工具,第三章每一代机型都会回到它。养成三个动作即可举一反三:见到新结构先问"通道怎么变",套公式;再问"参数在哪几层",数核与全连接;最后问"算力卡在哪站",找乘加最大的那一层。日后你读到论文里的结构表,第一反应应当是把表翻译成这张巡检单——大部分"看起来很神"的结构,对完账后神秘感会自动消退,留下的全是可推演的工程决策。
两道口算热身
动笔前先热身。第一题:输入 64×64,过"核 3、步幅 2、填充 1"的卷积再过 2×2 池化,出口多大?答:卷积后 (64+2−3)÷2+1 = 32,池化再减半得 16。第二题:通道从 16 直接接到 32 的 1×1 卷积,参数量多少?答:16×32+32 = 544,与特征图面积无关——这就是 1×1 做通道阀门便宜的直观依据。两题都对,正式巡检可以开始。
加练一题:改配置,重对账
把 TinyCNN 的卷积一换成 5×5(填充 2)、全连接宽度减半(2048 先降到 1024 维的中间层再接 10 类),参数量变成多少?手算:卷积一 5×5×3×16 加 16 得 1,216;卷积二不动,仍 4,640;新增中间层 2048×1024 加 1024 得 2,098,176——参数大头瞬间从分类头外的卷积跳到了这个中间层。这题的教训:全连接参数对"宽度"极其敏感,宽度翻倍即参数翻倍,动结构前先动笔。
💡 关键直觉:TinyCNN 的账给出了一条基线感知——参数量主要随"通道数 × 全连接宽度"涨,算力主要随"特征图面积 × 通道数"涨。控制模型规模,本质是在这两处做预算。
第二章的流水线到此全线贯通:形状、参数、算力三本账全部可以对到小数点。第三章翻开档案柜,看六代经典机型如何用同样的工位组合出不同的性格。