第四章 质检与回炉:训练如何让流水线学会看
第四章 · 质检与回炉:训练如何让流水线学会看
本章要回答的三个问题:训练到底在优化一个什么东西,它怎么给每次输出打分?一次打分产生的误差,怎么传回网络里几百万个参数并各改各的?数据、正则与学习率怎么配合,才能让训练稳步下降而不是过拟合或原地打转?前三章的流水线只会输出分数,本章教它把分数变对。
为什么会有这一章
把第二、三章的流水线随机初始化后直接用,输出基本是噪音——结构只是容器,能力在参数里,而参数是练出来的。训练环节的名声一向玄学:损失不降、验证集抖动、训练集满分而测试集不及格,每种症状背后都有一组具体的机械原因。本章把这些机械逐一拆开:损失函数是质检的量具,反向传播是误差的回流管道,优化器是拧参数的手艺,数据增强、批归一化、正则化与调度器是四件稳定器,迁移学习则是站在前人流水线上的捷径。
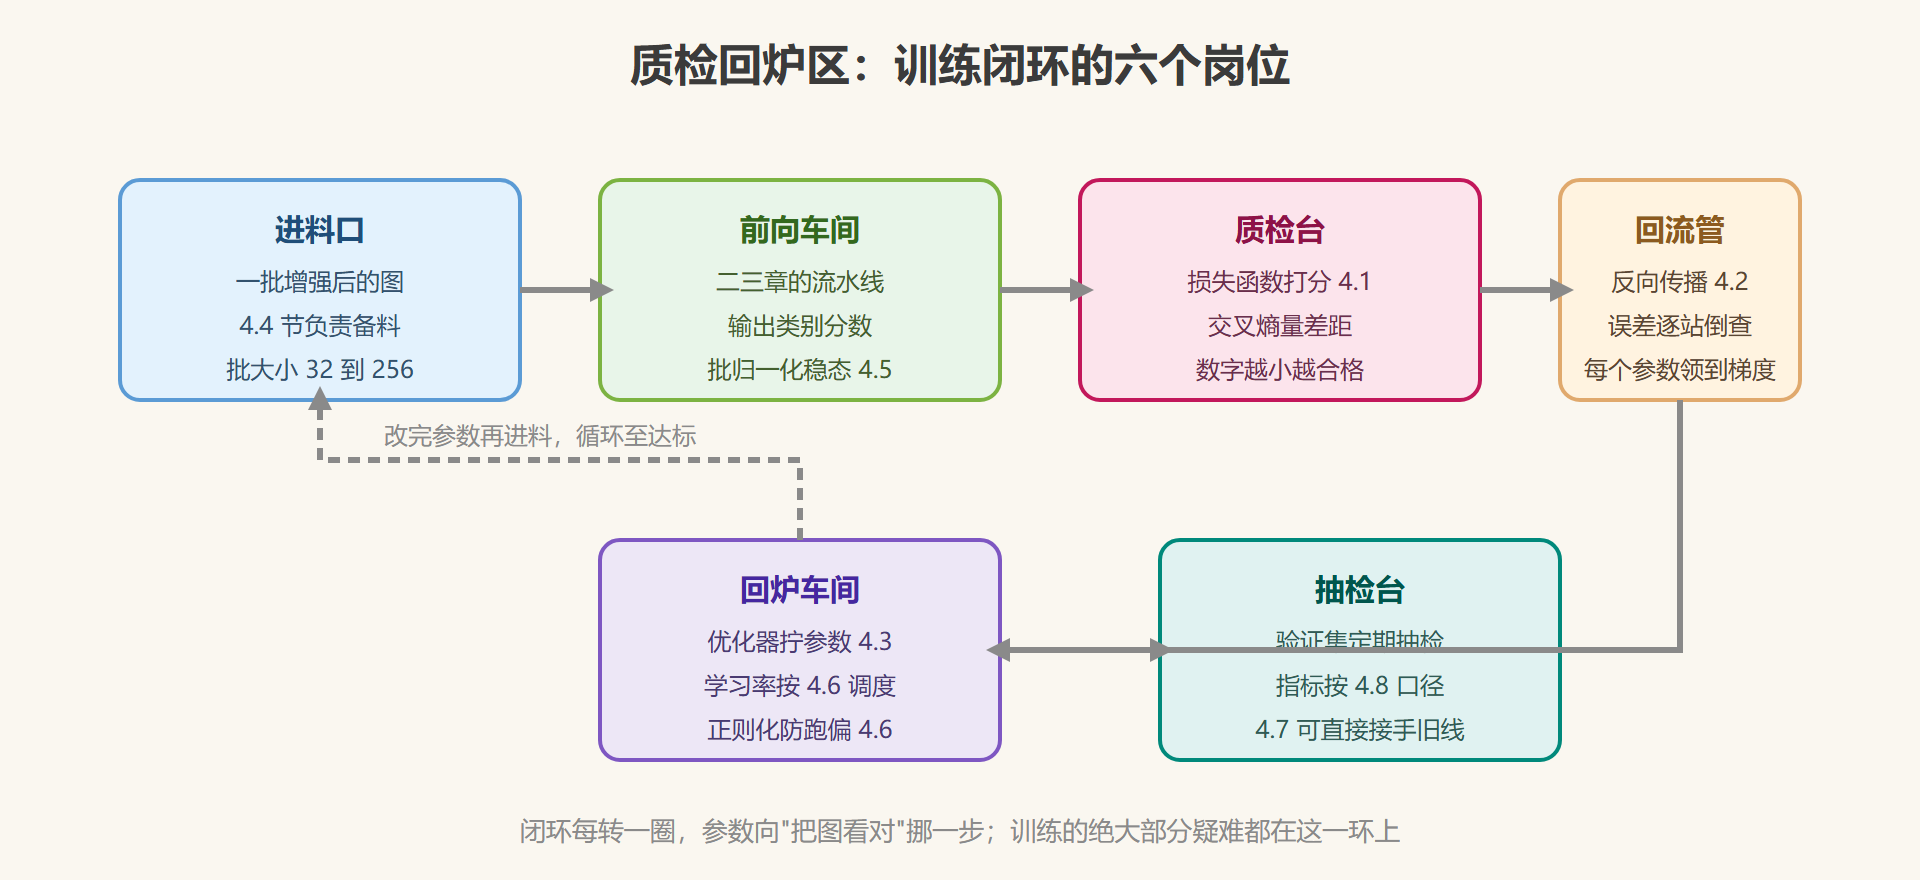
按流水线的语言说:训练就是"质检并回炉"的闭环——产品出厂先打分,误差按工位倒查责任,参数微调,再投产。闭环转上几千圈,流水线就学会了看。
读完能解决什么
- 手算 softmax 与交叉熵的一组完整数值,说清"合格线"如何量化;
- 复算一个两层小模型的反向传播全过程,并能对着自动求导的结果验证;
- 解释 SGD、动量、Adam 的递进关系,给不同任务选对优化器与初始学习率;
- 搭一套标准的数据增强管线,说清 mixup 类标签混合的损失写法;
- 复算批归一化的归一化数值,区分训练态与推理态的行为差异;
- 组合正则化与学习率调度治理过拟合,看懂损失曲线的诊断信号;
- 用冻结主干加换头的流程完成一次迁移学习,算清可训练参数的占比;
- 从混淆矩阵算出精确率、召回率与 F1,为第五章的任务指标打底。
各节怎么分工
| 节号 | 回答的问题 | 关键产出 |
|---|---|---|
| 4.1 损失函数 | 分数与正确答案差多少 | 交叉熵手算与标签平滑 |
| 4.2 反向传播 | 误差怎么找到责任参数 | 链式法则小账与自动求导对账 |
| 4.3 优化器 | 参数按什么节奏改 | 纯 SGD、动量、Adam 递进实验 |
| 4.4 数据增强 | 数据不够怎么造 | 标准管线与 mixup 配方 |
| 4.5 批归一化 | 怎么稳住每层输入 | 手算归一化与双态行为 |
| 4.6 正则化与调度 | 怎么防过拟合 | Dropout 账目与余弦退火 |
| 4.7 迁移学习 | 小数据怎么起步 | 冻结换头流程与参数占比 |
| 4.8 评估指标 | 练完怎么验收 | 混淆矩阵与三指标手算 |
训练闭环全景
图 4-1 质检回炉区布局
训练前自查
开工训练前按五问自查,能拦住八成常见事故。一问量具对不对:分类用交叉熵、入口是原始分数(4.1 节的双重 softmax 陷阱)。二问管道通不通:损失能 backward、梯度非 None,小批量试跑一轮。三问步子稳不稳:学习率取优化器的甜点值,热身开了没有。四问进料匀不匀:类别分布统计过吗,不平衡就上 4.6 节的加权。五问验收口径定没定:主指标、宏平均、早停耐心值,训练前写下来,别边跑边改标准。
先决条件
- 第二、三章的流水线结构(本章的前向部分就是它们);
- 导数的基本概念:知道"导数指方向"即可,4.2 节会从链式法则讲起;
- 不需要矩阵微调的推导能力,所有账目都按标量或小矩阵展开。
往下走到哪
闭环跑通、验收达标,流水线就算出师。第五章带它出厂:同样的骨干接上不同的头,分类流水线如何升级成检测、分割与生成的多面手;4.8 节的混淆矩阵与指标口径,也将在第五章升级为 mAP 与逐像素交并比。
评论区
(0)
U