4.4 数据增强:给进料口扩容
4.4 数据增强:给进料口扩容
本节摘要:数据增强用保持标签不变的随机变换(裁剪、翻转、色彩抖动、随机擦除)把一张图扩成无数张"新图",等价于向模型灌输"分类依据不该随这些变化而变"的先验。它是性价比最高的正则化:几行管线代码,常换来四到六个百分点的验证精度。本节搭一套 CIFAR-10 标准管线,复盘一次完整的增强实验,并交代 mixup 这类标签混合的进阶打法。
从一个过拟合现场说起
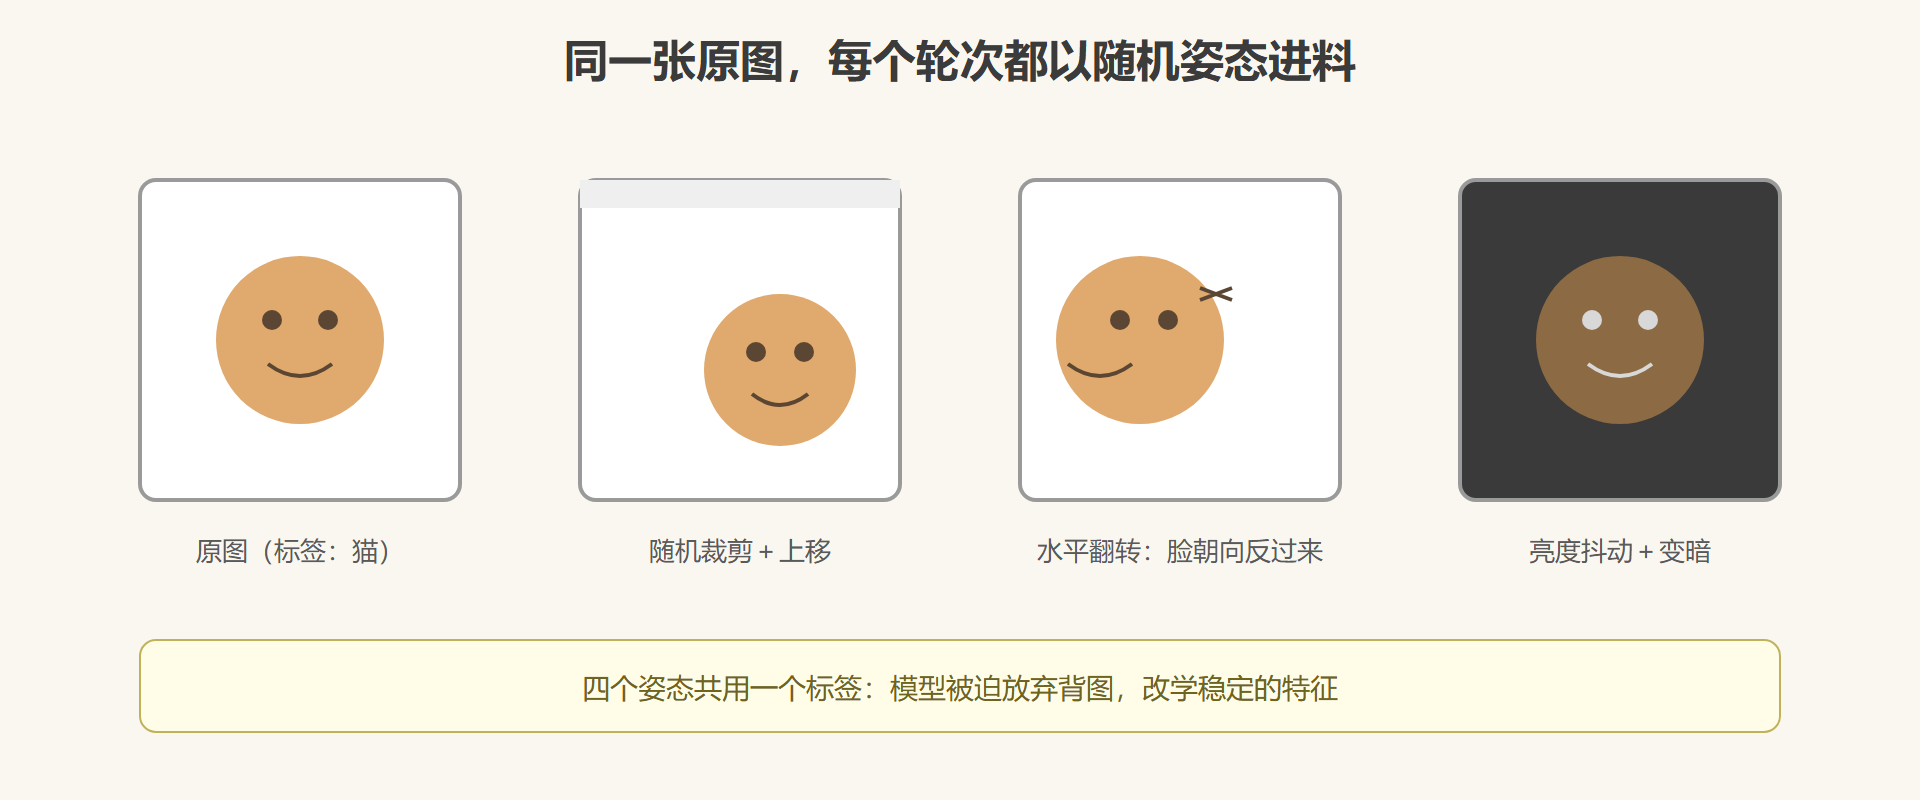
小数据集上从零训练,最常见的一幕是:训练损失一路降到接近零,验证精度停在半山腰甚至开始回落——模型把训练集背了下来,没学到泛化的规律。加数据是最直接的药,但标注费钱。增强的思路是"制造免费的新数据":把猫的图水平翻转,它还是猫;裁掉一角、调暗一点,也还是猫。每一张原图在每个轮次都以随机姿态出现,模型无法依赖"这张图我记得"来交卷,只能去学真正稳定的特征。
学习目标
阅读完本节,你应当能够:
- 搭出"裁剪加翻转加色彩抖动加归一化"的标准图像分类增强管线;
- 区分保持标签与破坏标签的变换,避开为增强而增强的坑;
- 写出 mixup 的混合式与对应损失,说清它增强的是什么不变性;
- 按数据集规模选择增强强度,避免欠拟合式的过度增强。
一、标准管线:训练重、测试轻
增强只在训练时开:测试与推理要用原图做确定性预处理——评估的是模型对真实分布的表现,掺随机性只会让指标抖动。CIFAR-10 的经典训练管线长这样:
from torchvision import transforms CIFAR_MEAN = [0.4914, 0.4822, 0.4465] # 官方统计的通道均值 CIFAR_STD = [0.2470, 0.2435, 0.2616] # 通道标准差 train_tf = transforms.Compose([ transforms.RandomCrop(32, padding=4), # 四边补 4 再随机裁回 32 transforms.RandomHorizontalFlip(), # 一半概率水平翻转 transforms.ColorJitter(brightness=0.2, contrast=0.2), transforms.ToTensor(), transforms.Normalize(CIFAR_MEAN, CIFAR_STD), ]) test_tf = transforms.Compose([ transforms.ToTensor(), transforms.Normalize(CIFAR_MEAN, CIFAR_STD), # 测试只做确定性预处理 ]) print("训练管线步数:", len(train_tf.transforms)) # 5 print("测试管线步数:", len(test_tf.transforms)) # 2
三个随机件的意图各不相同:随机裁剪教模型"目标在画面里挪一点也算同一类",随机翻转消灭左右朝向的偏好,色彩抖动削弱对光照的依赖。它们共享一条底线:变换后标签必须仍然成立。数字 6 垂直翻转会变成 9,交通标志上下颠倒语义反转——这类任务就绝不能用对应的变换。增强不是自助餐,是按任务语义点菜。
图 4-3 增强管线的进料变化
二、案例复盘:一次增强前后的对照
背景:一万两千张工业零件图分五类缺陷,自行搭建的 ResNet 风格网络从零训练,首轮没加增强。
操作:训练集精度、验证精度各记录到第四十个轮次;随后管线补上随机裁剪、翻转与色彩抖动,其余超参一律不动,重跑同套训练。
结果:无增强版在第十二个轮次附近训练精度逼近满分、验证精度停在约 86%;增强版训练精度收敛变慢(同轮次只有约 92%),验证精度爬到约 93% 并保持平稳——七个个百分点的差距全部来自进料端。
解读:训练精度下降而验证精度上升,正是正则化生效的标准画像:增强人为加大了训练难度,堵住了"背图"的捷径,容量被迫花在泛化特征上。若增强后训练精度也上不去(比如只有七成),那就是增强过猛,模型连训练集都学不动了——剂量要随数据规模调节。
变式:数据更少时可以叠加 mixup——把两张图按比例 λ 与 1−λ 像素级混合,标签也按同样比例混合,损失写成两项加权。它灌输了"特征线性叠加对应标签线性叠加"的软边界,在细粒度分类与标签噪声场景收益明显。
import torch x1 = torch.randn(3, 32, 32) x2 = torch.randn(3, 32, 32) y1, y2 = 2, 5 # 两张图各自的类别索引 lam = 0.7 # 实践中从 Beta 分布采样,这里取定值演示 x_mix = lam * x1 + (1 - lam) * x2 print(tuple(x_mix.shape)) # (3, 32, 32):混合图形状不变 # 损失写法:pred 为模型对混合图的输出(未过 softmax 的分数) # loss = lam * F.cross_entropy(pred.unsqueeze(0), torch.tensor([y1])) \ # + (1 - lam) * F.cross_entropy(pred.unsqueeze(0), torch.tensor([y2])) print("标签混合权重:", lam, "与", round(1 - lam, 1)) # 0.7 与 0.3
巡检记录
- 增强即先验:每开一种随机变换,都是在告诉模型"这种变化不影响标签",选变换就是选先验;
- 训练重测试轻:随机件只装在训练管线,测试必须确定性预处理,否则指标自带抖动;
- 剂量判断:训练精度降、验证精度升是见效;两者一起塌是增强过猛,回退强度;
- 进阶标签:mixup 把像素与标签一起线性混合,损失按 λ 加权两项交叉熵,细粒度与噪声标签场景优先尝试。
⚠️ 常见坑:对语义敏感的任务无脑开垂直翻转或大角度旋转。数字 6 翻成 9、方向盘转 90 度意义全变——先问"变换后这个标签还成立吗",答案存疑的变换一律不开。
进料稳住了,训练里还剩一个大抖源:各层输入分布随参数更新而漂移。下一节批归一化专门治它。