4.5 批归一化:稳住每一道工序的物料
4.5 批归一化:稳住每一道工序的物料
本节摘要:批归一化在每层卷积之后、激活之前,把该通道在一个小批次内的取值拉回均值零、方差一,再用两个可学习参数自由缩放平移。它让深层网络敢用大学习率、收敛更快,几乎是一切现代 CNN 的标配。本节手算一遍归一化数值,分清训练态与推理态的两副面孔,并交代批大小太小时的替代品。
一个漂移的车间会怎样
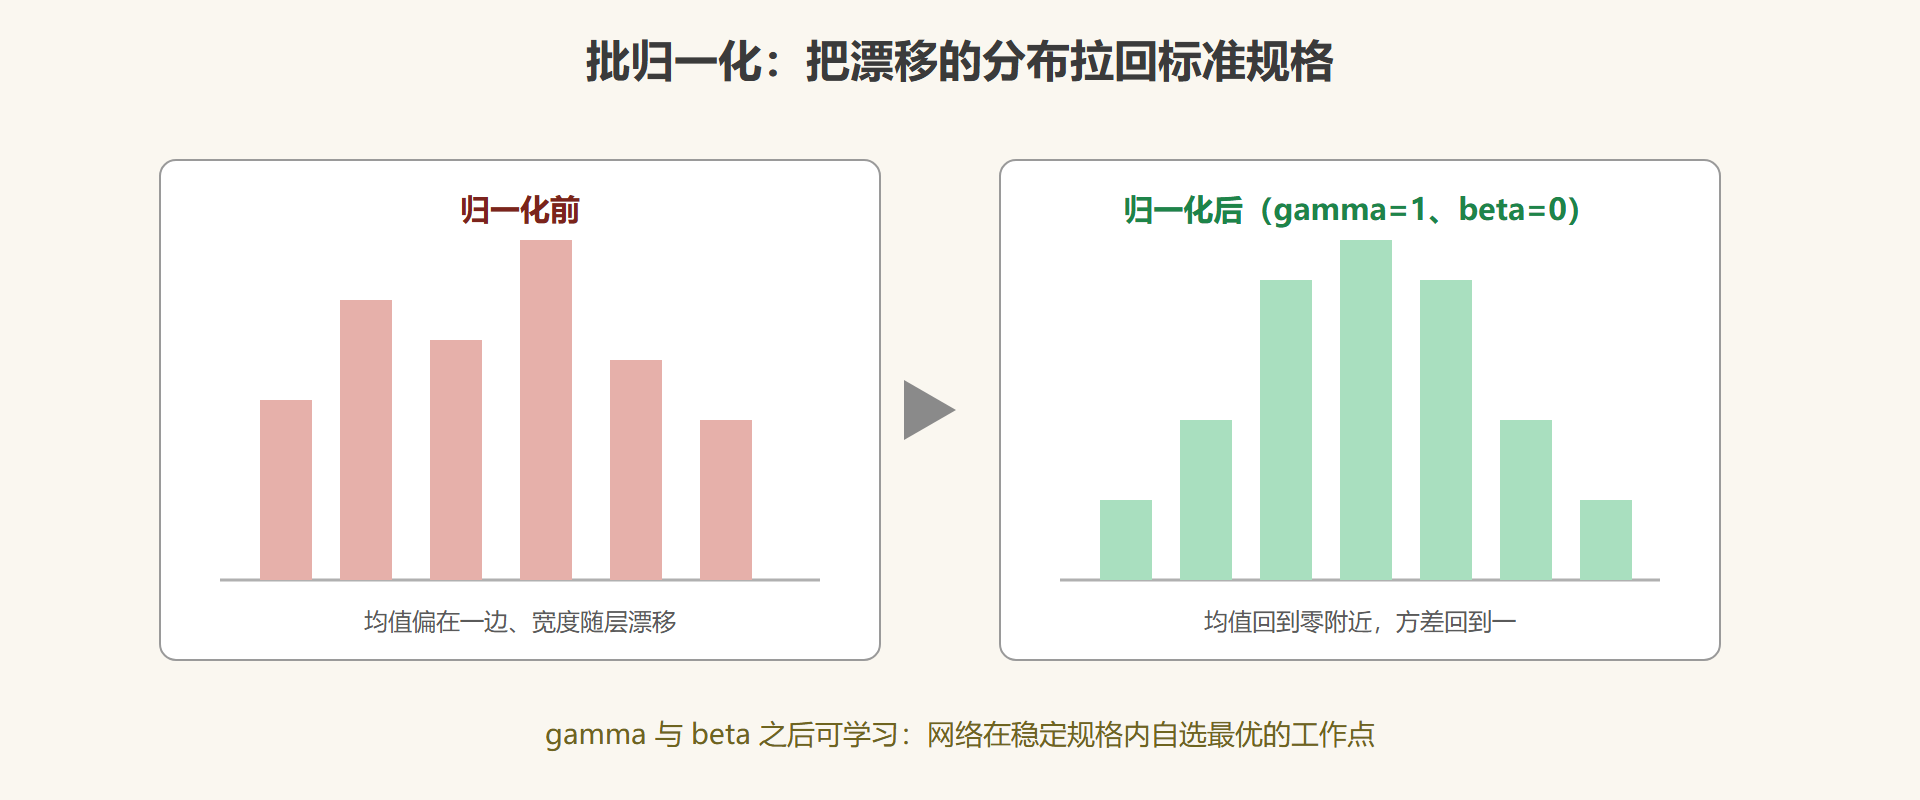
流水线有个隐含前提:上游工位送来的物料规格稳定。训练恰恰破坏这个前提——每更新一次参数,上一层的输出分布就挪一动,下一层永远在追一个移动靶:刚调好的参数,下一批数据来了输入分布又变了,学得慢、抖得狠,深网络里尤其明显。批归一化的思路直白:既然每层输入分布会漂,就在每层入口装一台"调直机",无论上游怎么漂,先把这批数据拉回均值零、方差一的标准规格,层与层之间从此交的是标准件。
学习目标
阅读完本节,你应当能够:
- 手算一个通道五个数值的归一化结果,写出完整公式;
- 解释 gamma 与 beta 的作用——调直之后为什么还要允许调回去;
- 区分训练态(批统计)与推理态(滑动统计)的行为差异;
- 说出批大小与归一化的关系,以及小组批次的替代方案。
一、公式与一笔手算
对某通道在一个批次内的全部取值 x:先算批均值与批方差,再归一化,最后做可学习的缩放与平移——
y = gamma × (x − 批均值) ÷ 根号(批方差 + 1e-5) + beta
代入具体数字验证手感。某通道里五个样本的取值是 1、2、3、4、5:均值 3,方差 2(各项偏离平方 4、1、0、1、4 取平均),标准差约 1.414。归一化后分别是 -1.414、-0.707、0、0.707、1.414——标准正态的模样。
import torch import torch.nn as nn x = torch.tensor([[1., 2., 3., 4., 5.]]).T # 一个通道、5 个样本 mu = x.mean(dim=0, keepdim=True) var = x.var(dim=0, unbiased=False) # 除以 N 的批方差 xn = (x - mu) / torch.sqrt(var + 1e-5) print([round(v, 3) for v in xn.squeeze(1).tolist()]) # [-1.414, -0.707, 0.0, 0.707, 1.414] bn = nn.BatchNorm1d(1) print([round(v, 3) for v in bn(x).squeeze(1).tolist()]) # 框架输出一致:初始 gamma=1、beta=0,只做归一化
调直之后为什么还允许 gamma 缩放、beta 平移?因为"均值零方差一"未必是该层的最优工作点,网络可能需要更陡或更偏的分布。归一化负责稳定,gamma 与 beta 负责在稳定的前提下把最终形态交给训练决定——约束与自由各占一半,这正是该设计的高明处。
图 4-4 归一化前后的分布对比
二、两副面孔与工程细节
训练态与推理态的行为完全不同,这是批归一化最常踩的开关。训练态用当前批的统计量做归一化,同时用滑动平均悄悄记录全局统计;推理态(eval 模式)不再看批——哪怕只有一张图,也用训练期间攒下的滑动统计,保证同一张图两次推理结果一致。
bn = nn.BatchNorm2d(8) bn.train() for _ in range(100): bn(torch.randn(32, 8, 16, 16)) # 训练态:批统计归一化 + 更新滑动量 bn.eval() x = torch.randn(1, 8, 16, 16) print(torch.equal(bn(x), bn(x))) # True:推理态结果确定 print("滑动均值形状:", tuple(bn.running_mean.shape)) # (8,) print("可学习参数量:", sum(p.numel() for p in bn.parameters())) # 16:8 个 gamma + 8 个 beta
工程细节归档:位置惯例在卷积后、激活前(卷积是线性层,先归一化再过非线性收益最大);卷积层配 BN 时偏置可省(2.1 节的伏笔——偏置会被减均值的动作抵消);它带来轻度的样本间耦合,顺带有微弱正则效果;批大小太小(比如 8 以下)时批统计噪声大,换成组归一化等按通道分组的方案更稳。
一笔缩放偏移账
gamma 与 beta 生效后的样子,接第一节的手算往下走:归一化后的五个数是 -1.414、-0.707、0、0.707、1.414,若训练学得 gamma=2、beta=1,输出就是各数乘二加一——依次 -1.83、-0.41、1.00、2.41、3.83。分布的中心与宽度动了,但"间距两两成比例"的规格没散。这就是该设计的全貌:先无条件调直,再由训练在 gamma 与 beta 两个维度上自选最终形态,稳定与自由各得其所。
xn = torch.tensor([-1.414, -0.707, 0.0, 0.707, 1.414]) print([round(v, 2) for v in (2 * xn + 1).tolist()]) # [-1.83, -0.41, 1.0, 2.41, 3.83]:gamma=2、beta=1 的最终输出
追问三则
问:BN 为什么放在激活之前?答:主流做法是"卷积、BN、激活"——先给线性输出调直再过非线性,非线性区间的输入分布最稳定;也有人试过激活后 BN,效果不分伯仲的场景也有,但默认位仍是激活前。问:BN 和 Dropout 能一起用吗?答:能但要小心——Dropout 在训练态随机掐活、推理态全开,会改变送入 BN 统计的数值范围,产生"方差偏移";现代 CNN 配方里通常是增强加 BN 就够,Dropout 留给全连接头。问:批大小 4 也能硬上 BN 吗?答:能跑但统计噪声大,精度常吃亏;批实在小,换组归一化(按通道分组算均值方差)更稳,检测与分割的小批场景是它的主场。
巡检记录
- 治的病:层间输入分布随训练漂移,调直机让每层交付标准件,深层网络收敛显著提速;
- 一笔手算:1 到 5 五个数归一化后是 -1.414、-0.707、0、0.707、1.414,公式只有减均值除标准差加缩放平移;
- 双态纪律:训练用批统计并维护滑动量,推理只用滑动量——忘切 eval 是"推理结果每次不一样"的头号原因;
- 边界条件:批太小换组归一化,序列任务换层归一化,卷积配 BN 可去偏置。
⚠️ 常见坑:微调时冻结了主干却忘把 BN 切到 eval——滑动统计继续被新数据改写,训练损失抖得莫名其妙。冻结主干请同时冻结其 BN 统计。
分布稳住了,下一节处理另一类失稳:模型对训练集记得太牢。正则化与学习率调度是两道互补的闸门。