第六章 巡检收尾:工具、风险与趋势
第六章 · 巡检收尾:工具、风险与趋势
本章要回答的三个问题:把模型从笔记本变成可交付的服务,工具链与算力怎么选?这个能认猫认狗的系统会怎么被骗,又该怎么向人解释它的判断?数据集工程与注意力时代的浪潮,会给 CNN 的位置带来什么变化?全册巡检的最后一站,把这门口手艺安全地送出门。
为什么会有这一章
前五章解决的是"会做",这一章解决"敢交付"。能跑通的模型和能上线的系统之间隔着几道现实关卡:训练要算力,部署要框架与量化;模型会在你看不见的地方被骗——一张贴纸就能让停车标志被判成限速;数据集本身可能有毒——训练测试混进同一张图,指标再漂亮也是自欺;而行业风向已转向注意力架构,你得知道 CNN 还剩哪些无可替代的阵地。
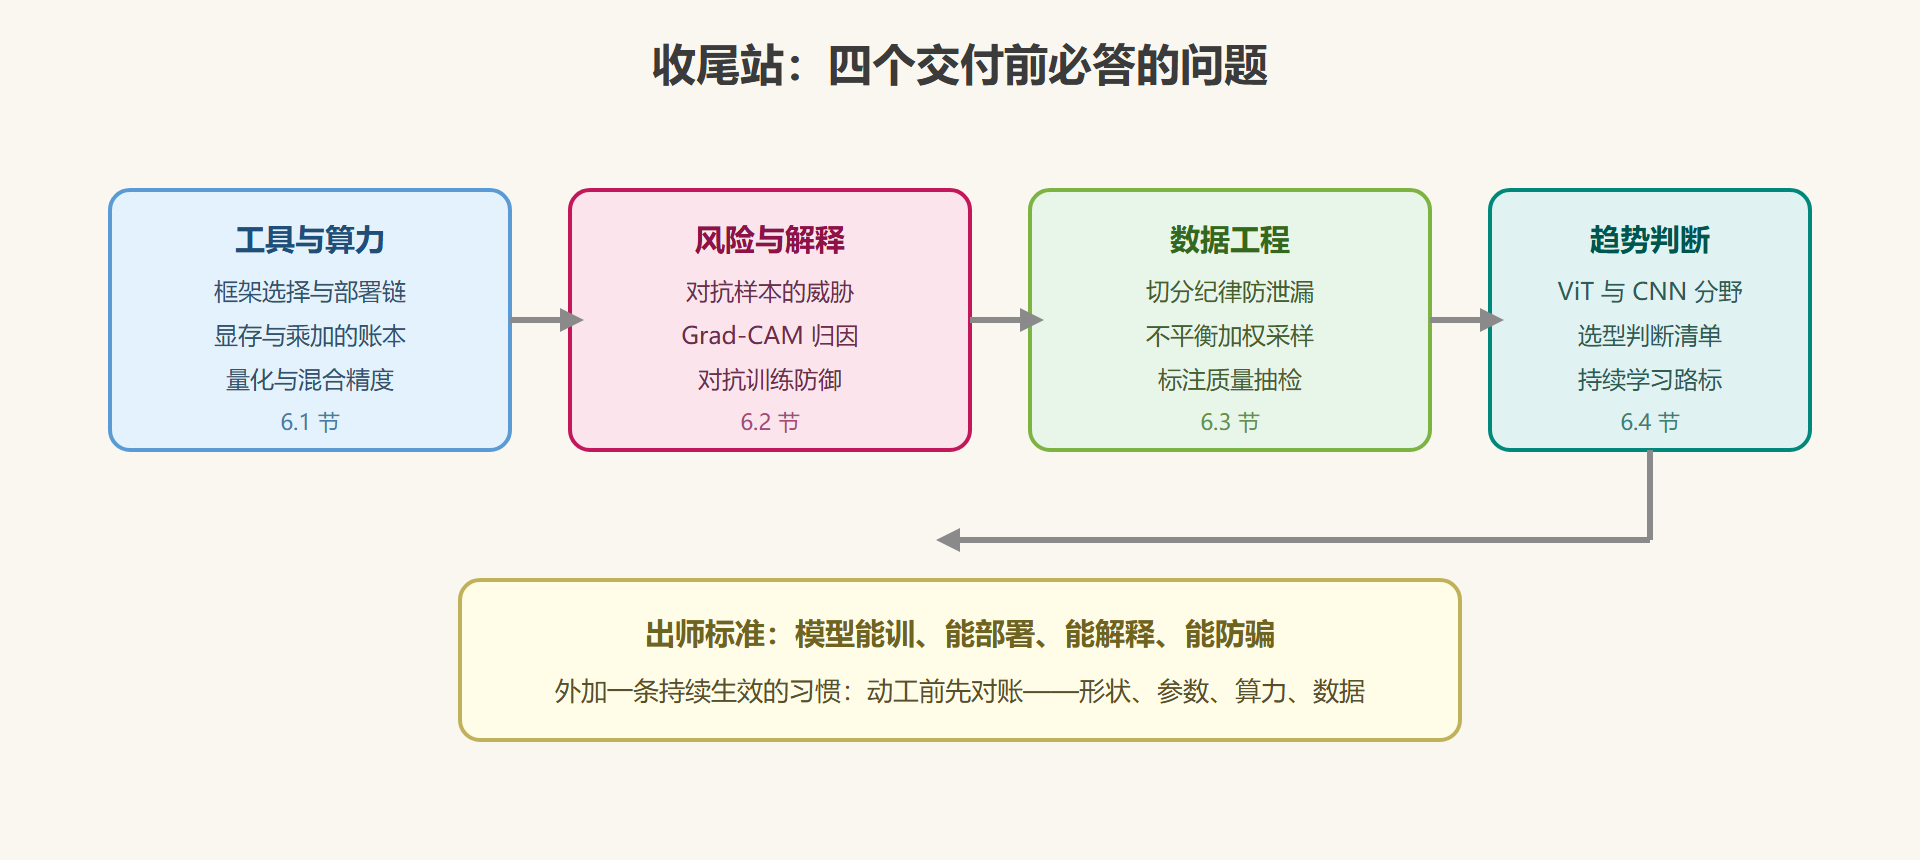
这些问题不解决,前面八章的功夫就只能停在演示项目里。收尾站的四节按"工具与算力、风险与解释、数据工程、趋势判断"展开,每一节都尽量给出可操作的判断标准而非泛泛而谈。
读完能解决什么
- 为自己的项目选对框架与部署路径(本地训练、量化、端侧推理的分工);
- 复算一批数据的显存占用与模型乘加量,给算力预算立账;
- 演示一次 FGSM 对抗攻击的最小可行样例,说出对抗训练的防御思路;
- 区分 Grad-CAM 与显著图的解释口径,知道"哪里看"与"看什么"的差异;
- 建立防泄漏的数据集切分纪律,用分层抽样与加权采样处理不平衡;
- 说清 ViT 与 CNN 的分水岭(全局感受野对局部先验),判断什么任务仍该用 CNN。
各节怎么分工
| 节号 | 回答的问题 | 关键产出 |
|---|---|---|
| 6.1 框架与算力 | 用什么造、用什么跑 | 算力账本与部署路径 |
| 6.2 可解释性与对抗样本 | 会被怎么骗、怎么解释 | FGSM 最小样例 |
| 6.3 数据集构建与管理 | 原料质量怎么保证 | 切分纪律与不平衡处方 |
| 6.4 CNN 之后 | 注意力时代的位置 | 选型判断清单 |
收尾站全景
图 6-1 收尾站:从演示到交付的路标
本章与其他章的接口
收尾站不是孤岛,四节各自回接着前文的地基。6.1 的算力账本是 1.3 节显存公式与 2.1 节乘加公式的直接应用;6.2 的对抗攻击用的是 4.2 节的梯度,归因用的也是梯度——攻防同源;6.3 的加权采样公式与 4.4 节的增强一脉相承,切分纪律是 4.8 节验收纪律的上游;6.4 的感受野对比直接调用 2.2 节的累加算法。换句话说,本章没有引入新机器,只是把已有的零件对准了交付视角——读的时候多留意回指,等于把全册免费复习一遍。
交付前清单
对照四问做交付前的最后巡检。算力问:显存与乘加的账算过吗,训练时长有没有按 6.1 节的口径估算?风险问:模型最坏会在哪被骗,置信度阈值与人工兜底设了没有?数据问:切分指纹、类别分布、标注抽检记录齐不齐?趋势问:当前选型在 CNN 与注意力之间的判断依据,能写出一条备忘吗?四问都有书面答案,这套系统才算真正出了收尾站。
先决条件
- 前五章的流水线、训练与任务知识(本章反复回指);
- 4.6 节的学习率直觉(6.1 节谈混合精度时会用到);
- 对"部署"有模糊的焦虑即可——本章正好把它拆解成清单。
往下走到哪
教程到此合拢,但巡检的习惯不该合拢:形状对账、参数对账、算力对账、数据对账——这套肌肉记忆会跟着你进入任何新框架、新架构。若继续进阶,注意力与多模态是顺理成章的下一站;而无论架构怎么变,第二章那两条公式依然是你读任何结构图的第一把钥匙。