2.1 人工智能与机器学习开源项目
2.1 人工智能与机器学习开源项目
本节摘要:AI/ML 是 2026 年 GitHub 上项目数量最多、增速最快的领域。本节按"训练 → 推理 → 应用 → 安全"四层结构,梳理各层最具代表性的开源项目,分析其技术定位、核心特性和适用场景,帮你在 AI 开源的汪洋中建立导航坐标。
核心问题
阅读完本节,你应当能够:
- 说出 AI/ML 开源生态的四层结构及每层的代表项目
- 区分训练框架(PyTorch/JAX)和模型仓库(Hugging Face)的不同定位
- 理解 MLOps 工具链在 AI 项目工程化中的角色
- 识别 AI 安全与治理类开源项目的发展趋势
一、问题与直觉
2023 年之前,一个 AI 工程师的工作流大概是:数据清洗 → PyTorch 训练 → Flask 包个 API → 上线。简单粗暴,但够用。
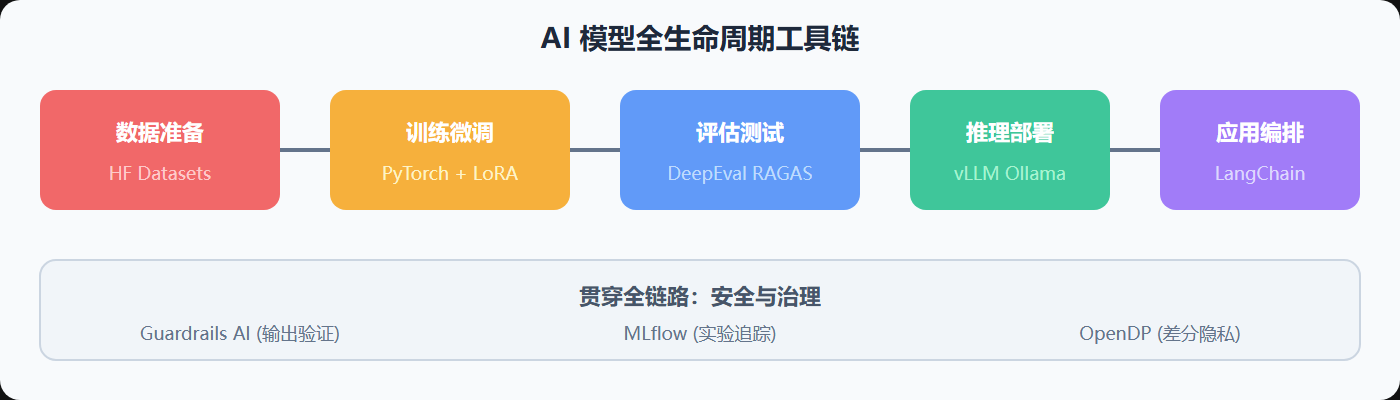
2026 年的工作流复杂了十倍:模型选型(Hugging Face 上百万个模型)→ 微调(LoRA/QLoRA/全参数)→ 评估(DeepEval/RAGAS)→ 推理优化(量化/蒸馏/投机解码)→ 部署(vLLM/TGI/Ollama)→ 应用编排(LangChain/CrewAI)→ 安全护栏(Guardrails AI)→ 监控(Phoenix/LangSmith)。
每个环节都有对应的开源项目。本节按四层结构帮你建立全景认知。
二、核心原理:四层生态图谱
第一层:训练基础设施
这一层是 AI 开源的"地基",项目成熟度高、社区庞大。
| 项目 | 定位 | 核心特性 | 适用场景 |
|---|---|---|---|
| PyTorch | 深度学习框架 | 动态图、Pythonic API、生态最丰富 | 研究和生产通用 |
| JAX | 函数式计算框架 | XLA 编译、自动微分、TPU 原生支持 | 大规模训练、科研 |
| Hugging Face | 模型仓库 + 工具链 | Transformers/Diffusers/Datasets 全家桶 | 模型获取、微调、分享 |
| DeepSpeed | 分布式训练 | ZeRO 优化、混合精度、超大模型训练 | 十亿级以上模型 |
| LLaMA-Factory | 微调平台 | 一站式微调界面、支持 100+ 模型 | 快速微调实验 |
💡 关键直觉:PyTorch 和 JAX 的关系不是"二选一",而是"默认 PyTorch,追求极致性能用 JAX"。Hugging Face 不是框架,而是"AI 领域的 npm"——它不教你怎么写代码,但给你现成的轮子。
第二层:推理与部署
这一层在 2025-2026 年创新最密集,因为"让模型跑起来"的需求远大于"训练新模型"。
| 项目 | 定位 | 核心特性 | 适用场景 |
|---|---|---|---|
| llama.cpp | 本地推理引擎 | C/C++ 实现、CPU 可跑、GGUF 格式 | 个人设备、边缘部署 |
| vLLM | 高吞吐推理服务 | PagedAttention、连续批处理 | 生产 API 服务 |
| Ollama | 一键本地部署 | 类 Docker 体验、模型库管理 | 开发者本地使用 |
| TGI | HF 官方推理服务 | 与 Transformers 无缝集成 | HF 生态用户 |
| ONNX Runtime | 跨平台推理 | 模型格式转换、硬件适配 | 跨平台部署需求 |
第三层:应用开发框架
这一层让 AI 从"模型"变成"产品"。
| 项目 | 定位 | 核心特性 | 适用场景 |
|---|---|---|---|
| LangChain | LLM 应用框架 | 链式调用、工具集成、Agent 支持 | 通用 LLM 应用 |
| LlamaIndex | 数据索引框架 | 文档解析、向量检索、RAG 管线 | 知识问答、文档理解 |
| CrewAI | 多 Agent 框架 | 角色定义、任务编排、协作机制 | 复杂工作流自动化 |
| AutoGen | 多 Agent 对话 | 可定制 Agent、群聊模式、代码执行 | 研究和原型 |
第四层:安全与治理
这一层在 2026 年从"可选项"变成了"必选项"。
| 项目 | 定位 | 核心特性 | 适用场景 |
|---|---|---|---|
| Guardrails AI | 输出验证 | 结构化输出校验、自动重试 | 生产环境输出安全 |
| DeepEval | LLM 评估 | 14+ 评估指标、回归测试 | 模型迭代质量保障 |
| RAGAS | RAG 评估 | 忠实度、相关性、上下文精度 | RAG 系统优化 |
| OpenDP | 差分隐私 | 统计分析隐私保护 | 数据合规 |
图:AI 模型全生命周期工具链
三、工程实践要点
选型决策树
面对这么多项目,怎么快速决策?
| 你的需求 | 推荐组合 |
|---|---|
| 快速微调一个开源模型 | Hugging Face + LLaMA-Factory |
| 在笔记本上跑 LLM | Ollama + 任意开源模型 |
| 构建 RAG 知识问答 | LlamaIndex + vLLM + RAGAS |
| 搭建多 Agent 工作流 | CrewAI 或 AutoGen |
| 生产环境部署推理服务 | vLLM + Guardrails AI |
| 评估模型迭代质量 | DeepEval |
⚠️ 常见坑:LangChain 和 LlamaIndex 有功能重叠。简单 RAG 用 LlamaIndex 就够了;需要复杂工具调用和多步推理才上 LangChain。两个都用会增加维护成本。
项目活跃度判断
AI 领域项目迭代极快,选型时特别注意:
- 看最近 30 天的 commit 频率,而不是总 Star 数
- 检查是否支持最新模型架构(如 MoE、长上下文)
- 看 Issue 区是否有"支持 xxx 模型"的请求和维护者响应
训练与微调的真实成本
很多人把"微调"想得太轻。一张消费级显卡确实能跑 LoRA,但完整流程包含数据清洗、标注、超参搜索、评估、上线回滚,人力成本远高于算力成本。LLaMA-Factory 这类一站式工具把界面做得很友好,但"能点按钮"不等于"能做出好模型"。实际项目里,80% 的时间花在数据上:重复样本会放大偏见,标签错误会直接传导到下游,评估集如果和训练集同源,指标再漂亮也没有说服力。
微调之前先问三个问题:基座模型是否已经满足需求(很多场景提示词工程就够)、微调目标是否可量化(准确率还是格式)、数据规模是否值得(几千条高质量数据往往比几万条脏数据有效)。想清楚这些再开卡,能省一大笔预算。
模型许可证:最容易忽略的坑
AI 项目的许可证比普通代码复杂得多。权重许可证和代码许可证是两套体系:同一个模型,代码可能用宽松许可证,权重却附带商用限制。所谓"开源模型"经常是"开放权重",训练数据未必公开,商用条款各有差异。选型时把模型权重、代码、训练数据三者的条款分别查一遍,再对照自己的商用场景。这条和第一章的许可证评估是同一套逻辑,只是 AI 领域更隐蔽,很多团队栽过跟头。
向量数据库与 RAG 工具
RAG 是 2026 年落地最多的 AI 应用形态,支撑它的向量检索层同样值得关注。Milvus 面向大规模生产检索,Chroma 面向原型快速迭代,pgvector 则让 Postgres 用户不引入新组件。选择依据不是"哪个更快",而是数据规模、团队熟悉度和部署约束:十万级向量用 pgvector 足够,千万级且对延迟敏感再上独立向量库。RAG 的难点通常不在检索而在"切分"——文档怎么切块、块和块怎么重叠、元数据怎么保留,这些工程细节决定问答质量。
从零搭一条最小 AI 管线
把四层生态串成一条实际可跑的管线,比零散看项目更有用。一个最小方案是:从 Hugging Face 拉一个开源模型,用 LLaMA-Factory 做 LoRA 微调,评估用 DeepEval 跑回归,部署用 vLLM 起服务,业务侧用 LlamaIndex 接文档做 RAG,最后用 Guardrails AI 约束输出格式。整条链路全部开源、全部能在单机跑通,成本可控,值得作为团队的入门练手项目。
本章回顾
- 四层结构:训练基础设施 → 推理部署 → 应用框架 → 安全治理,每层都有明确的代表项目
- 推理层创新最密集:llama.cpp/vLLM/Ollama 解决了"让模型跑起来"的核心痛点
- 应用框架分化明显:LangChain 做通用编排,LlamaIndex 专注数据检索,CrewAI 做多 Agent
- 安全层从可选变必选:Guardrails AI 和 DeepEval 是生产环境的标配
- 选型看活跃度不看 Star:AI 领域半年一代际,最近 30 天的 commit 比总 Star 更有参考价值
了解了全景之后,下一节我们深入推理优化——这是让 AI 从"实验室产物"变成"生产工具"的关键环节。