2.2 AI推理优化与本地部署
2.2 AI推理优化与本地部署
本节摘要:训练一个大模型可能需要数百万美元,但让它在你的笔记本上流畅运行,只需要选对工具和量化策略。本节深入推理优化的四条技术路线——量化、KV Cache 管理、投机解码、模型蒸馏——以及 llama.cpp、vLLM、Ollama 三大本地部署工具的实际选型。
本节地图
阅读完本节,你应当能够:
- 解释 INT4/INT8 量化的原理及对精度的影响
- 理解 PagedAttention 如何解决显存碎片化问题
- 对比 llama.cpp、vLLM、Ollama 的定位差异
- 根据硬件条件选择合适的推理方案
一、问题与直觉
一个 7B 参数的模型,FP16 精度下需要约 14GB 显存。一张 RTX 4090 有 24GB 显存——勉强能装下模型,但留给 KV Cache 的空间所剩无几,并发几个请求就 OOM 了。
这就是推理优化的核心矛盾:模型越来越大,硬件显存有限,怎么在有限的硬件上跑出可接受的速度和并发量?
2025-2026 年,开源社区在四条技术路线上取得了突破性进展。
二、核心原理:四条技术路线
路线一:量化(Quantization)
把模型权重从高精度(FP16/FP32)压缩到低精度(INT8/INT4),用空间换速度。
| 量化方案 | 精度 | 7B 模型大小 | 质量损失 | 代表工具 |
|---|---|---|---|---|
| FP16 | 16位 | ~14GB | 无(基准) | PyTorch 原生 |
| INT8 | 8位 | ~7GB | 极小 | bitsandbytes |
| INT4 (GPTQ) | 4位 | ~4GB | 较小 | AutoGPTQ |
| INT4 (GGUF Q4) | 4位 | ~4GB | 较小 | llama.cpp |
| INT4 (AWQ) | 4位 | ~4GB | 较小 | AWQ |
| INT2 | 2位 | ~2GB | 明显 | llama.cpp |
💡 关键直觉:INT4 量化是当前性价比最高的选择——模型体积缩小到原来的 1/4,质量损失在大多数任务上几乎不可感知。INT2 以下就不推荐了,输出质量会明显下降。
路线二:KV Cache 管理
大模型推理时,每个 token 生成都需要缓存之前所有 token 的 Key 和 Value 向量。上下文越长,KV Cache 占的显存越多,而且会产生大量碎片。
vLLM 的 PagedAttention 是 2025 年最重要的推理优化之一。它借鉴了操作系统虚拟内存的分页思想:把 KV Cache 分成固定大小的"页",按需分配,不浪费。效果是同样的显存可以处理更多并发请求,吞吐量提升 2-4 倍。
路线三:投机解码(Speculative Decoding)
用一个小模型(草稿模型)快速生成多个候选 token,再让大模型一次性验证。如果猜对了,相当于一次推理生成了多个 token;猜错了也只浪费一次验证的计算。
这个方法在文本生成任务上可以加速 1.5-3 倍,而且不改变输出质量(因为最终是大模型验证的)。
路线四:模型蒸馏(Distillation)
用大模型的输出作为训练信号,训练一个小模型来模仿大模型的行为。Phi 系列(微软)和 Gemma 系列(Google)就是蒸馏路线的产物——用大模型的知识"灌"进小模型,让小模型在特定任务上接近大模型的表现。
三、工程实践要点:三大部署工具选型
| 维度 | llama.cpp | vLLM | Ollama |
|---|---|---|---|
| 定位 | 底层推理引擎 | 高吞吐推理服务 | 一键本地部署 |
| 语言 | C/C++ | Python (CUDA) | Go |
| 硬件需求 | CPU 即可,GPU 更快 | 需要 GPU | CPU/GPU 均可 |
| 量化支持 | GGUF 格式,Q2-Q8 | GPTQ/AWQ/FP8 | 基于 llama.cpp |
| 并发能力 | 单实例多请求 | 高并发(PagedAttention) | 单用户为主 |
| 适用场景 | 边缘设备、嵌入式 | 生产 API 服务 | 开发者本地使用 |
| 上手难度 | 中等(需编译) | 中等(需 GPU 环境) | 极低(一行命令) |
⚠️ 常见坑:Ollama 底层用的是 llama.cpp,所以两者的模型格式(GGUF)是兼容的。但 Ollama 不提供 vLLM 的高并发能力——如果你的场景需要同时服务 50+ 用户,直接上 vLLM。
本地部署实操建议
个人开发者日常使用:装 Ollama,一行命令拉模型。
ollama run llama3
生产环境 API 服务:用 vLLM,搭配 Docker 部署,配置 PagedAttention 和连续批处理。
边缘设备 / 嵌入式:编译 llama.cpp,选择 Q4_K_M 量化,在目标硬件上跑基准测试。
显存估算:部署前的第一道数学题
动手之前先算一笔账,能避免大量"起了服务立刻 OOM"的尴尬。经验公式分两部分:模型权重占用的显存约等于参数量乘以每参数字节数,7B 模型 FP16 大约 14GB,INT4 大约 4GB;KV Cache 的占用则随上下文长度线性增长,粗略估计每百万 token 上下文在 7B 模型上需要额外 1GB 量级。两者相加就是静态占用量,再乘以并发预留系数,才是你需要的显存。8GB 显存跑 7B 模型不是不行,但要么量化到 INT4,要么限制上下文长度,两者都做才能留出并发余量。
量化不是免费的午餐
INT4 让模型体积缩到四分之一,但代价藏在细节里:量化会放大长尾分布误差,代码、数学这类对精确符号敏感的任务最容易先崩;不同量化算法对"哪些层值得保留高精度"的处理不一样,GPTQ 偏静态校准,AWQ 按激活分布加权,GGUF 的 Q4_K_M 则是对不同张量混合取位宽。同一个模型换一种量化方案,效果可能差一个档次。选型不要只看宣传,要在你的任务集上跑一遍对比,尤其关注生成长度拉满时的质量衰减。
常见的翻车现场
本地推理的故障大多是配置问题而不是硬件问题。典型的有三种:一是没关掉默认的贪婪采样,输出重复但定位半天才发现是采样参数;二是预热不足,第一个请求把加载时间算进了响应时间,压测结果失真;三是并发设置超过显存余量,服务在高峰时段频繁 OOM 重启。建议上线前做三件事:固定随机种子做回归对比、留足预热请求、压测时监控显存峰值而不是平均值。
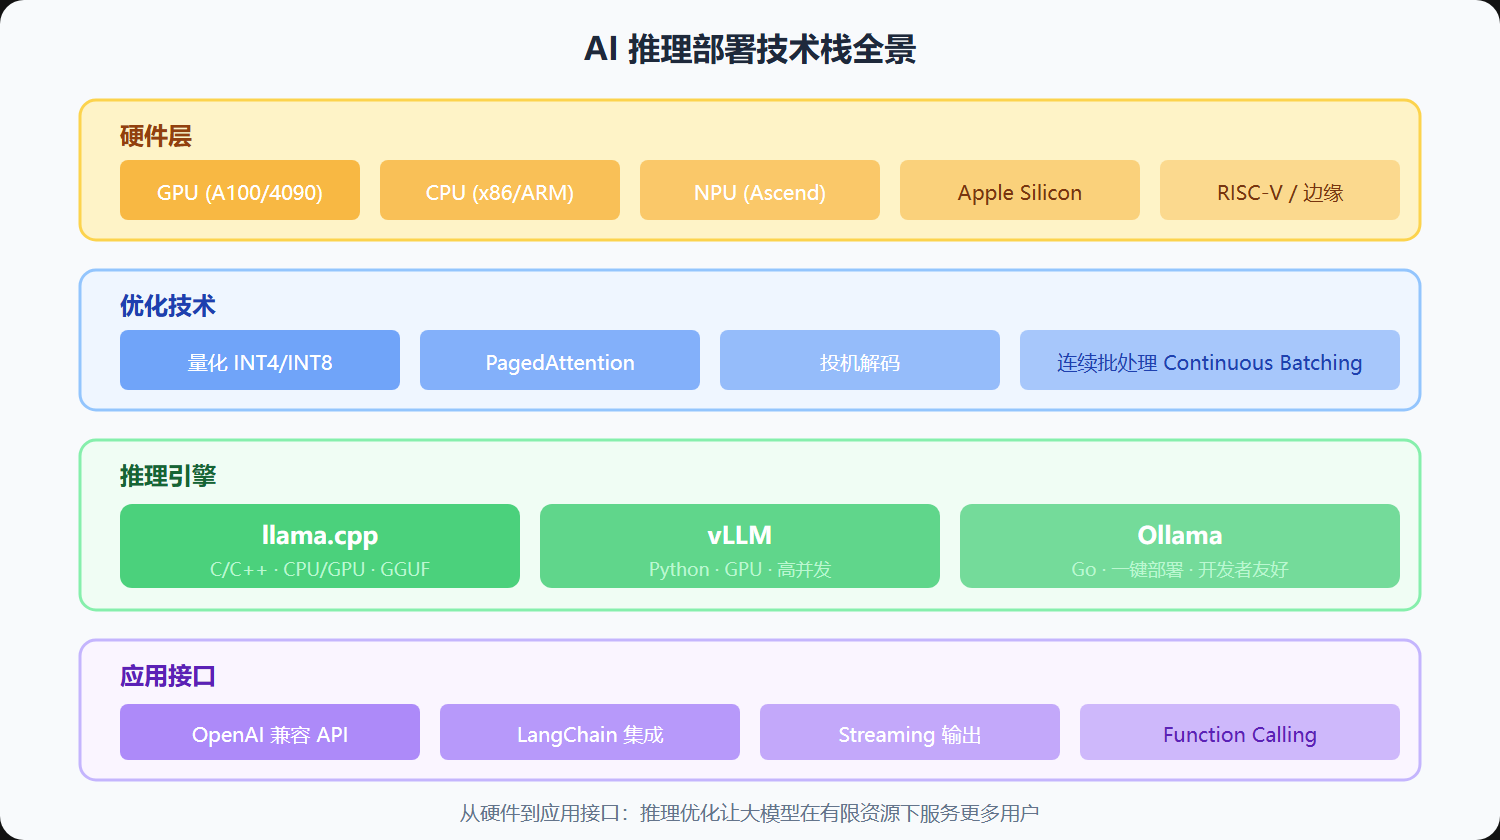
图:AI推理部署技术栈对比
要点串联
- 量化是性价比之王:INT4 量化把 7B 模型从 14GB 压到 4GB,质量损失几乎不可感知
- PagedAttention 解决并发瓶颈:vLLM 的分页 KV Cache 让同样显存服务 2-4 倍并发
- 投机解码免费加速:用小模型猜、大模型验,速度提升 1.5-3 倍且不影响质量
- 三工具各有定位:Ollama 给开发者本地用,vLLM 给生产环境高并发,llama.cpp 给边缘设备
- 选型先看硬件:有 GPU 上 vLLM,只有 CPU 用 llama.cpp,想省事装 Ollama
模型能跑起来了,下一节我们看怎么让它"干活"——Agent 框架如何把 LLM 从聊天工具变成工作流引擎。