4.1 常见并发模式:排班表经典款
4.1 常见并发模式:排班表经典款
本节摘要:工作池、扇入扇出、信号量、流水线,是并发编程里反复出现的四款结构。它们不是新语法,而是第 3 章原语的成熟组合方式。本节给出每款的完整实现、适用负载与失效场景,配一张拓扑图总览。掌握之后,多数并发需求都能对号入座。
上一章集齐了零件,本章教装配。行业里聊并发结构有一套行话:坑位(并发度)、扇出(一人分活给多人)、扇入(多人结果汇一路)、背压(下游消化不了就顶住上游)。这些词背后各有一款标准结构,本节按出场频率依次讲。挑选模式的关键始终是负载特征:CPU 密集看核数,IO 密集看下游吞吐,突发流量看缓冲策略。
工作池:并发度的闸门
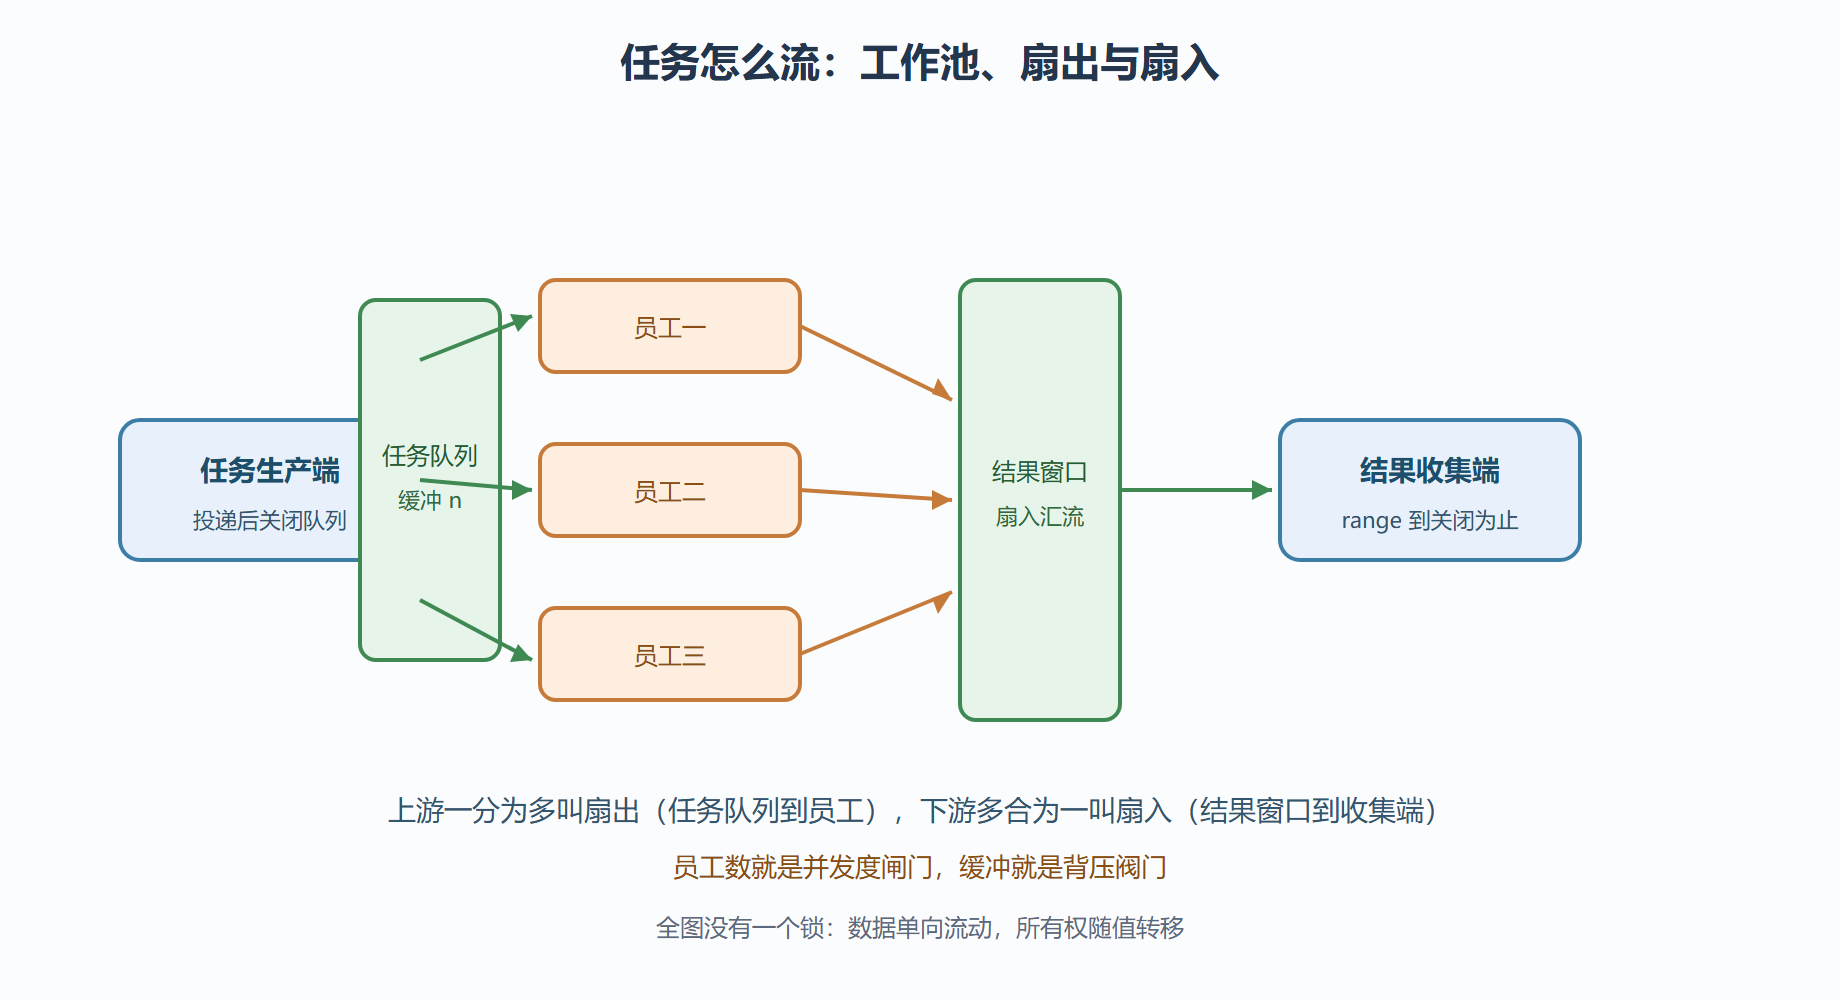
"每个任务开一个 goroutine"在任务量小时最简单,任务量大时就是灾难——十万个任务就是十万个 goroutine 同时抢内存、抢句柄、抢下游。工作池的思路是固定 N 个员工循环领活,任务在队列里排队:
package main import ( "fmt" "sync" ) func worker(id int, jobs <-chan int, results chan<- string, wg *sync.WaitGroup) { defer wg.Done() for j := range jobs { // 队列关了,员工自然下班 results <- fmt.Sprintf("员工%d 处理任务%d", id, j) } } func main() { jobs := make(chan int, 20) results := make(chan string, 20) var wg sync.WaitGroup for w := 1; w <= 3; w++ { // 固定三名员工 wg.Add(1) go worker(w, jobs, results, &wg) } for j := 1; j <= 9; j++ { jobs <- j } close(jobs) // 发完任务关队列 go func() { // 结果收集员:等全员收工后关结果队列 wg.Wait() close(results) }() for r := range results { fmt.Println(r) } } // 运行输出(员工编号随调度变化,任务编号齐全即可): // 员工1 处理任务1 // 员工3 处理任务2 // 员工2 处理任务3 // ... 共九行 ...
这个结构有三个可调参数:员工数 N、任务缓冲、结果缓冲。N 是并发度的闸门——CPU 密集取核数附近,IO 密集取决于下游容量(数据库连接池大小、第三方接口限流额度)。缓冲决定突发流量的容忍度,也是背压的体现:缓冲满,投递端阻塞,压力被挡在门外而不是砸垮池内。
图 4-1:工作池与扇入扇出拓扑
扇入:把多路结果汇成一路
工作池天然是扇出扇入的组合体,但"扇入"还有更轻量的形态——把若干同型窗口汇合成一路。合并函数是标准库没有、社区人人手写一份的经典:
package main import ( "fmt" "sync" ) // merge 把多个同型窗口汇成一路;任一入路关闭不影响其他路 func merge(ins ...<-chan int) <-chan int { out := make(chan int) var wg sync.WaitGroup for _, in := range ins { wg.Add(1) go func(c <-chan int) { // 每路一个转发员 defer wg.Done() for v := range c { out <- v } }(in) } go func() { // 全部转发完才关总出口 wg.Wait() close(out) }() return out } func main() { a := make(chan int, 2) b := make(chan int, 2) a <- 1 a <- 2 close(a) b <- 10 b <- 20 close(b) for v := range merge(a, b) { // 收齐四值即结束,顺序随调度 fmt.Println(v) } } // 运行输出(顺序可能交错): // 1 // 10 // 2 // 20
merge 的要点在收尾:转发员各自 Done,汇总 goroutine 在 Wait 后关闭总出口——3.3 的关闭纪律与 3.5 的签到板在十行内完成配合。调用方拿到的依然是一个普通窗口,可以继续接流水线、继续 merge,组合性是这套模式的灵魂。
信号量:不用池也能限流
有些资源天然带配额(数据库连接数、第三方限流额度),但又不想搭完整工作池。带缓冲窗口当信号量是最短的解法——缓冲里剩几个空位,就允许几个任务同时在跑:
package main import ( "fmt" "sync" "time" ) func main() { sem := make(chan struct{}, 2) // 并发度上限 2 var wg sync.WaitGroup for i := 1; i <= 5; i++ { wg.Add(1) go func(n int) { defer wg.Done() sem <- struct{}{} // 占一个空位,满了就等 defer func() { <-sem }() // 干完归还 fmt.Println("任务", n, "开始", time.Now().Format("15:04:05.000")) time.Sleep(50 * time.Millisecond) }(i) } wg.Wait() } // 运行输出:五个任务最多两个并行,总耗时约三批乘 50ms
空结构体占零字节,信号量不携带数据只占名额,这是它与传话窗口的本质区别。对比选型:需要任务排队与结果收集,用工作池;只需要限流、任务各自为战,用信号量。
流水线:分阶段吞吐
把处理过程拆成串行阶段,阶段之间用窗口衔接,就是流水线。它的价值在于各阶段并行推进:解析第 n 个元素时,校验在处理第 n-1 个,落库在第 n-2 个,总吞吐接近最慢阶段的速率而非各阶段之和。典型分法是生成、加工、消费三段,每段一个或多个 goroutine,段间 channel 单向流动。上一节 merge 的输出可以直接接进流水线下游,两套模式无缝拼装。
流水线的死亡陷阱是阶段失衡:某阶段慢于其他阶段,缓冲会持续堆积直到背压顶住全链。所以流水线设计的第一问永远是"最慢的一段是谁",优化永远从它开始——4.3 的性能观测就是干这个的。
完整案例:批量文件压缩工作池
背景:交接班要打包归档几百份日志,逐个压缩耗时太长;全量并发又怕磁盘 IO 打满影响线上。
操作:搭一个工作池,员工数压到 4;任务队列缓冲 16 平滑投递;结果窗口收集每个文件的压缩结果;WaitGroup 收口后统计成败。
package main import ( "fmt" "sync" "time" ) func compress(name string) (string, error) { time.Sleep(30 * time.Millisecond) // 模拟压缩耗时 if name == "bad.log" { return "", fmt.Errorf("文件损坏: %s", name) } return name + ".gz", nil } func main() { files := []string{"a.log", "b.log", "bad.log", "c.log", "d.log", "e.log"} jobs := make(chan string, 16) type result struct { src string dst string err error } results := make(chan result, 16) var wg sync.WaitGroup for w := 1; w <= 4; w++ { wg.Add(1) go func() { defer wg.Done() for f := range jobs { dst, err := compress(f) results <- result{f, dst, err} } }() } go func() { for _, f := range files { jobs <- f } close(jobs) }() go func() { wg.Wait() close(results) }() ok, fail := 0, 0 for r := range results { if r.err != nil { fail++ fmt.Println("失败:", r.err) continue } ok++ fmt.Println("完成:", r.dst) } fmt.Println("汇总: 成功", ok, "失败", fail) } // 运行输出: // 完成: a.log.gz // 失败: 文件损坏: bad.log // 完成: b.log.gz // 完成: c.log.gz // 完成: d.log.gz // 完成: e.log.gz // 汇总: 成功 5 失败 1
结果:六份文件按四个员工的节奏压缩完毕,坏文件被单点标记,成功失败泾渭分明,总耗时约两轮压缩时长。
解读:错误也走结果窗口而不走 panic 或日志——批量任务里"单点失败不拖垮批次"是硬要求,错误作为普通值随结果流动,汇总端统一裁决。员工闭包直接 range jobs,连员工编号都省了:并发度由池大小表达,与编号无关。
变式:给压缩加每文件超时——包一层 3.6 的超时模板,把超时也作为一种 result 写入。改完你会发现:模式的骨架一毫米没动,只是任务函数内部多了一层 select。这就是模式的意义:变化被隔离在插件位,骨架稳定可审计。
收班要点
- 工作池用固定员工循环领活,员工数是并发度闸门,缓冲是背压阀门。
- 扇入 merge 的收口三件套:每路转发员、WaitGroup、Wait 后关总出口。
- 信号量用空结构体缓冲窗口,只占名额不传数据,限流首选。
- 流水线吞吐等于最慢阶段,优化从瓶颈段开始。
- 错误作为值随结果流动,批量任务的失败要可统计、不传染。
结构搭对了,下一节处理那个最阴险的问题:为什么代码"偶尔"会算错——竞态条件调查。