4.2 竞态条件与并发安全:夜班事故调查
4.2 竞态条件与并发安全:夜班事故调查
本节摘要:数据竞争是两个 goroutine 在没有同步的情况下访问同一内存且至少一方在写,后果是结果依赖时序、随时漂移。本节用一次真实复盘展示竞态的隐蔽性,教你看懂竞态检测器的报告,并给出缩小共享与加锁两条修复路线。竞态不可根除,但可以流程化地消灭。
模式搭对了还偶尔出错?多数时候凶手是数据竞争。它是并发事故里的头号惯犯:复现难(十次里错一次)、定位难(代码看起来毫无问题)、危害大(脏数据静默入库)。本节按事故调查的标准流程走:还原现场、仪器取证、给出修复、总结预防。
还原现场:一段"看起来没问题"的代码
package main import ( "fmt" "sync" ) func main() { var clicks int var wg sync.WaitGroup for i := 0; i < 1000; i++ { wg.Add(1) go func() { defer wg.Done() clicks++ // 事故点:非原子的读改写 }() } wg.Wait() fmt.Println("点击量:", clicks) } // 预期输出 1000,实际输出在 940 到 1000 之间漂移, // 且每次运行不同——这就是"偶尔算错"的全部真相
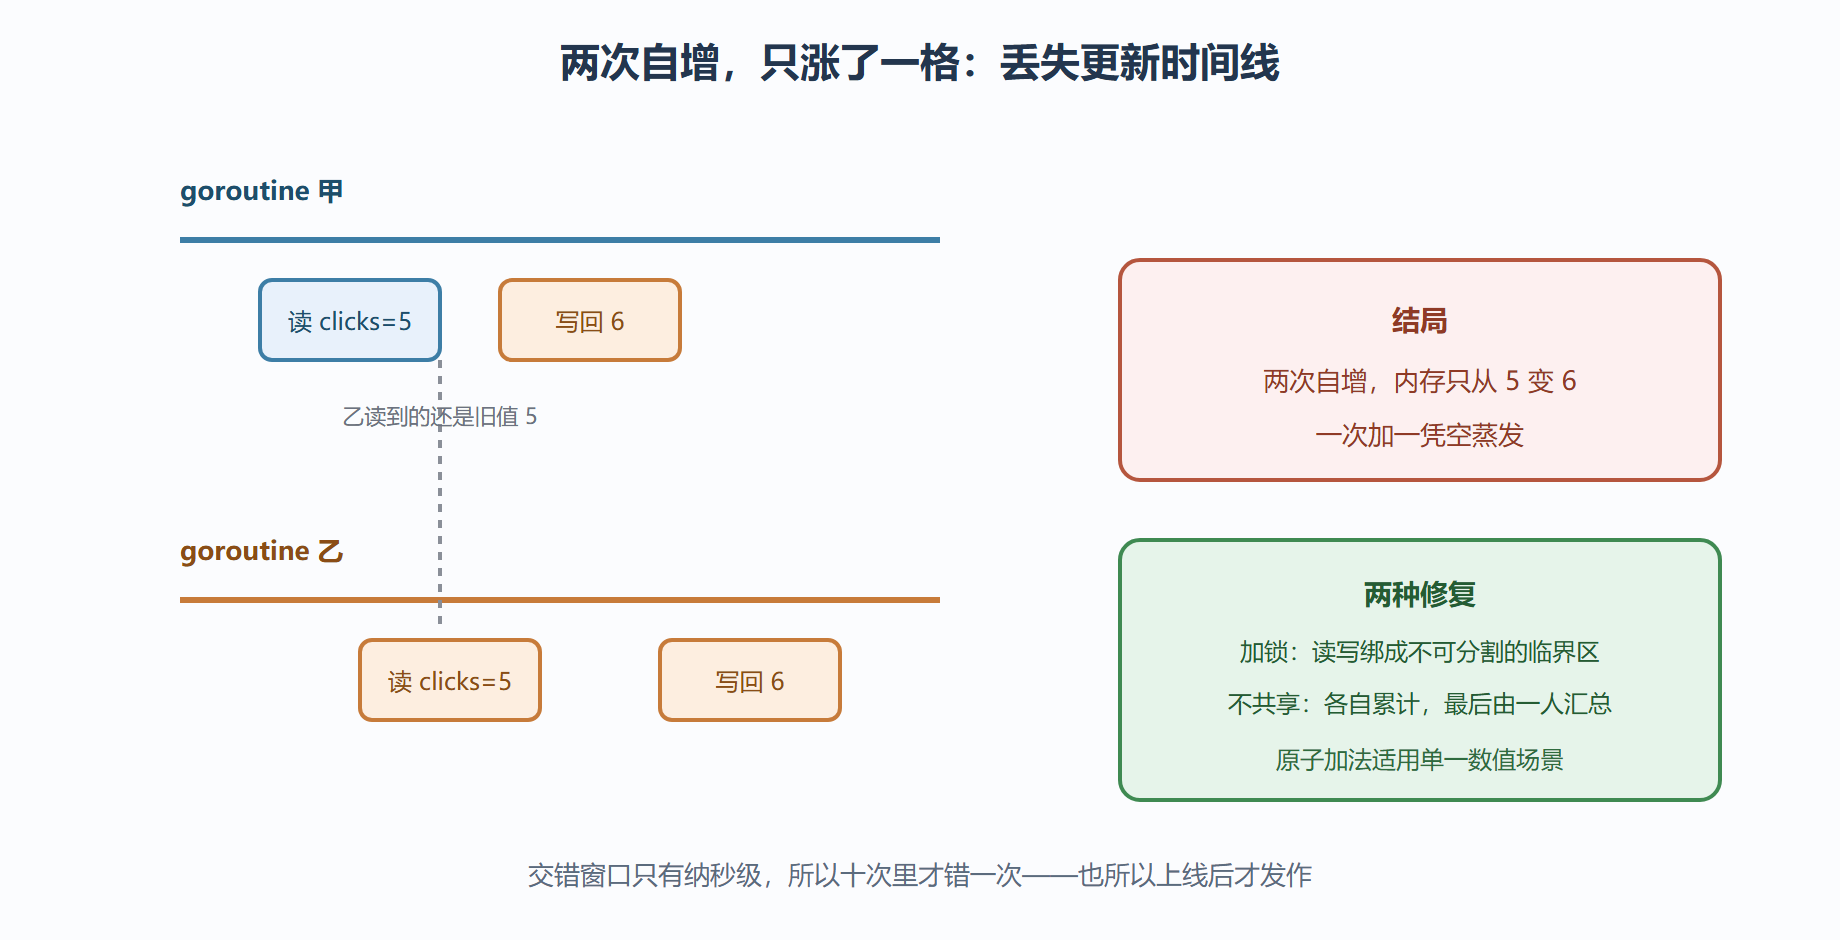
clicks++ 在机器层面是三步:从内存读入寄存器、寄存器加一、写回内存。两个 goroutine 同时读、先后写,后写者覆盖前写者,一次加一就凭空蒸发了。复盘时请抛弃"是不是哪里逻辑写错了"的思路——每一行逻辑都对,错的是两行逻辑之间的时序。
图 4-2:丢失更新是怎么发生的
仪器取证:竞态检测器
肉眼推演纳秒级交错不现实,Go 自带竞态检测器:它在运行时记录每次内存访问的同步关系,发现"无同步的并发读写"立即报警。代价是内存涨五到十倍、速度慢两到二十倍,所以它属于测试与 CI 阶段的仪器,不进生产:
$ go run -race main.go ================== WARNING: DATA RACE Write at 0x00c000014098 by goroutine 8: main.main.func1() main.go:14 +0x3a Previous write at 0x00c000014098 by goroutine 7: main.main.func1() main.go:14 +0x50 Goroutine 8 (running) created at: main.go:12 ================== 点击量: 983 Found 1 data race(s) exit status 66
读报告抓三点:冲突地址(同一内存)、读写双方(两个 func1,都写在同一行)、两个 goroutine 的出生地(同一处 go 语句)。三条线一连,结论就是 clicks 的无锁并发自增。检测器的原理基于先行发生关系:它不要求你复现错误时序,只要证明"存在无同步的并发读写"就报警——宁可误报不可漏报,所以它是 CI 里的必跑项,也是评审的延伸眼。
修复路线一:缩小共享面
首选修复不是上锁,而是问一句"这个共享有必要吗"。让每个 goroutine 各自累计、最后由主 goroutine 汇总,竞争在结构上就不存在了:
func countByChannel(n int) int { perGo := make(chan int, n) // 每人交自己的小计 split := 10 for g := 0; g < split; g++ { go func() { local := 0 for i := 0; i < n/split; i++ { local++ // 只碰自己的局部变量,零竞争 } perGo <- local }() } total := 0 for g := 0; g < split; g++ { total += <-perGo } return total } // 输出恒为 n:局部累计把写冲突摊平成单点汇总
这是 3.1 哲学的实操版:能靠"一个时刻一个主人"解决的,别引入锁。
修复路线二:锁与原子操作
共享确实不可免(缓存、配置热更新),那就把读写绑进临界区。单一数值的自增场景还有更轻的兵器——原子操作,它把读改写做成不可分割的机器指令:
package main import ( "fmt" "sync" "sync/atomic" ) func main() { var clicks int64 var wg sync.WaitGroup for i := 0; i < 1000; i++ { wg.Add(1) go func() { defer wg.Done() atomic.AddInt64(&clicks, 1) // 硬件级原子加法 }() } wg.Wait() fmt.Println("点击量:", atomic.LoadInt64(&clicks)) } // 输出恒为 1000
两种武器的分界:单一数值的独立读写用原子操作,指针、标志位同理;多个变量组成的不变量(先改 A 必须同时改 B)必须用锁——原子操作护不住跨变量的逻辑一致性,强行混用只会把竞态挪到更高的抽象层。
完整案例:投票统计的三版演进
背景:值班评分系统要统计各选项票数,写入来自多个受理 goroutine,读端是网页展示。
操作:三版实现依次对比——无保护、全局锁、分片聚合。
// 版本 A:无保护。map 并发读写会直接 panic: // fatal error: concurrent map writes // 这是 Go 运行时少数"宁可崩也不脏"的防线 // 版本 B:全局锁。正确但写吞吐受限 type Votes struct { mu sync.Mutex m map[string]int } func (v *Votes) Vote(choice string) { v.mu.Lock() defer v.mu.Unlock() v.m[choice]++ } // 版本 C:分片聚合。写入按选项落到不同分片,分片间无锁并行 type Sharded struct { parts []map[string]int // 每个分片自带小锁 locks []sync.Mutex } func NewSharded(n int) *Sharded { return &Sharded{ parts: make([]map[string]int, n), locks: make([]sync.Mutex, n), } } func (s *Sharded) Vote(choice string) { idx := int(choice[0]) % len(s.parts) // 简化的分片路由 s.locks[idx].Lock() s.parts[idx][choice]++ s.locks[idx].Unlock() } func (s *Sharded) Count(choice string) int { idx := int(choice[0]) % len(s.parts) s.locks[idx].Lock() defer s.locks[idx].Unlock() return s.parts[idx][choice] }
结果:A 直接崩(好过静默错);B 正确但压测下写延迟随并发线性涨;C 在八个选项、上万并发的压测里写吞吐接近线性扩展。
解读:A 的 crash 其实是 Go 的仁慈——map 并发写被运行时检测到就立即终止进程,绝不带病运行;生产上"偶尔崩溃"的采集服务,第一嫌疑就是并发 map。B 到 C 的演进体现负载特征决定结构:投票写多读少且键集固定,分片收益明显;若键集随机漂移,分片反而摊薄缓存命中率。
变式:把版本 B 的 Mutex 换成 RWMutex 并用 RLock 读——展示环节读多写少时吞吐回升;再把压测改成写多读少,收益消失。做完这组对比实验,"锁的粒度要跟着负载特征走"就不再是口号。
预防清单
- CI 必跑 -race:go test 与 go build 的竞态开关在测试阶段拦截,成本最低。
- 共享可变状态封装进结构体,锁或窗口跟随数据私有,外部只见到方法。
- 能用局部变量就不共享,能按 goroutine 划分就不用锁。
- map 并发读写一律上锁或换并发安全结构,侥幸心理的尽头是凌晨崩溃。
收班要点
- 竞态的本质是无同步的并发读写,逻辑全对也会错——修时序不修逻辑。
- 竞态检测器按先行发生关系报警,不需要复现交错,报告抓冲突地址、读写双方、出生地三点。
- 修复首选缩小共享面,其次锁;单一数值可用原子操作,跨变量不变量必须锁。
- 并发 map 写入运行时直接 fatal,遇到即按本节流程调查。
- 预防靠流程:CI 开竞态检测、共享状态封装、评审对照守则。
竞态解决了"偶尔错",下一节解决"越来越慢"——给并发程序装上监控大屏与性能剖析仪器。