6.1 传送带:流的概念与字节字符流
6.1 传送带:流的概念与字节字符流
本节摘要:流是数据在源与目的地之间的传送通道,按内容分字节流(搬原始字节,图片音视频)与字符流(带编码翻译,文本专用),按方向分输入与输出。四个基类构成四象限,文件实现类是最常用的传送带。字节流读中文会撞上多字节编码问题,字符流按指定编码翻译。本节立起四象限图、写出两套读写骨架代码,并解释流用完必须关的原因。
数据是怎么"流"进程序的
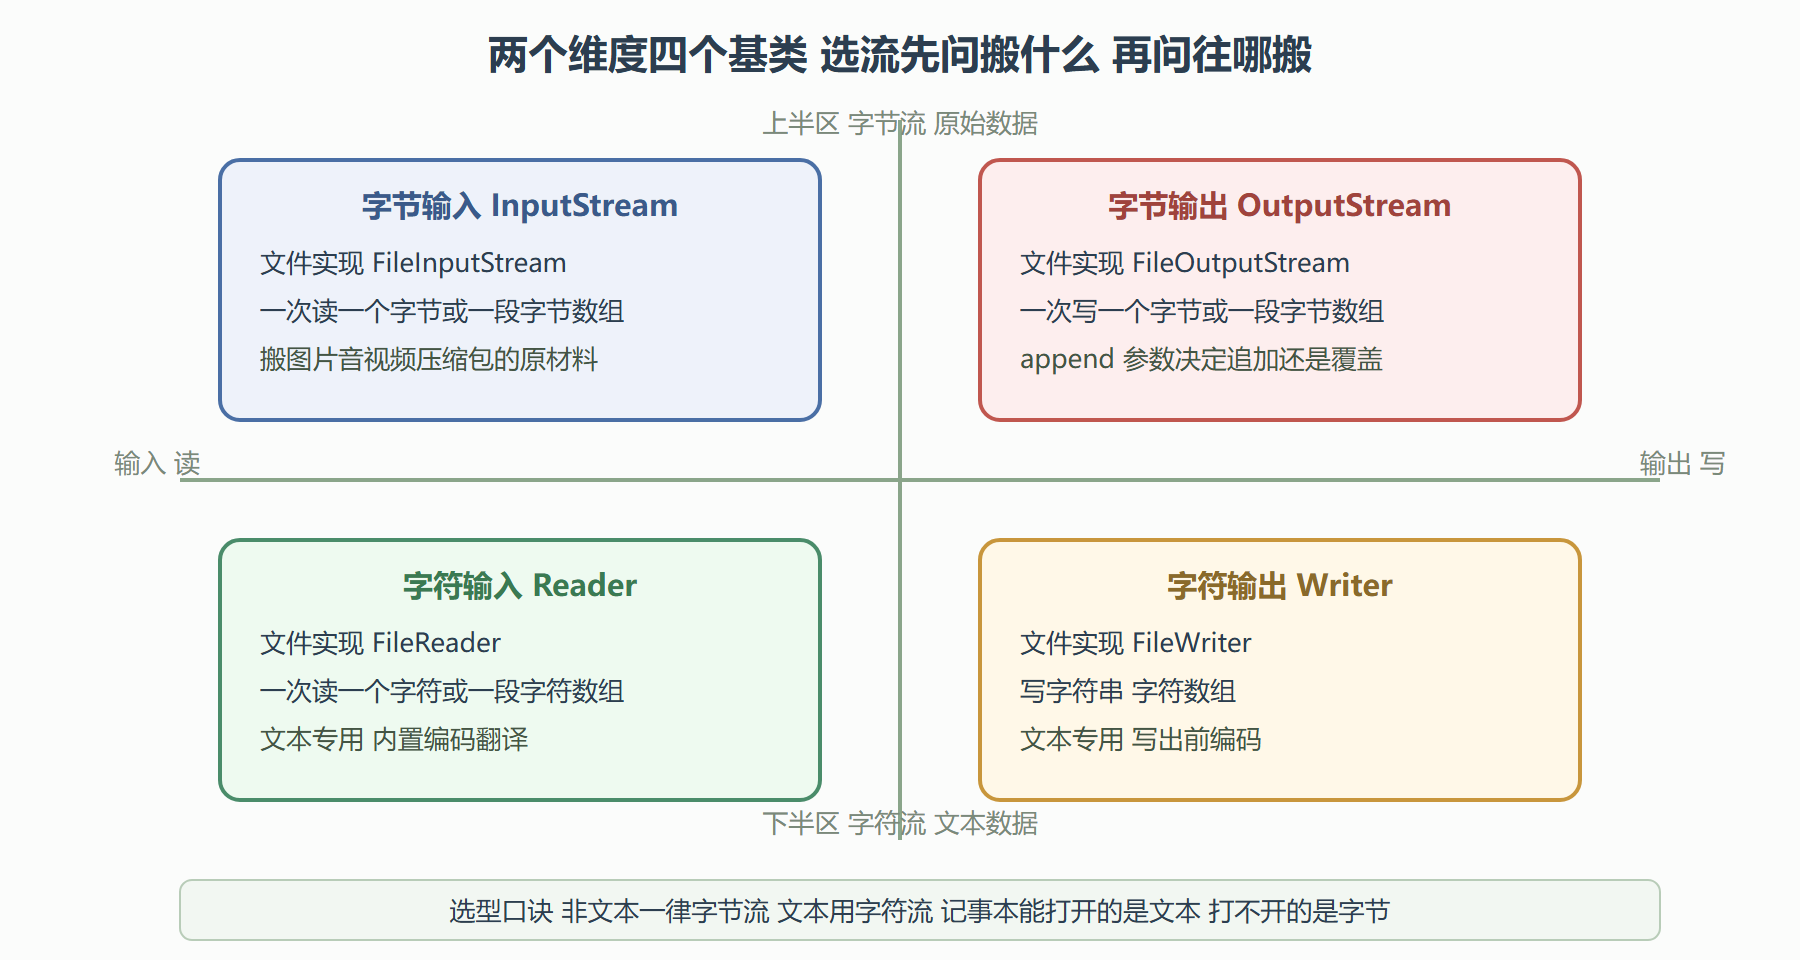
内存里的集合再大,程序一关就清零;要让数据活过进程的生死,必须让它们在内存与外部(文件、网络、别的进程)之间移动。Java 的模型是流(Stream):一条单向传送带,数据像包裹一样从一端流向另一端。两个正交的分类维度拼出四种基本流:
按内容:字节流搬运原始字节,不理解也不需要理解包裹里是什么——图片、音频、压缩包、一切数据通用;字符流是"带翻译员的传送带",专门处理文本,按字符编码在字节与字符之间转换。按方向:输入流从源读进程序、输出流从程序写向目的地。
图 6-1 流家族四象限与常用实现
两套骨架代码
字节流的读写骨架——单字节读的循环、read 返回负一表示流到头:
import java.io.FileInputStream; import java.io.FileOutputStream; import java.io.IOException; public class ByteStreamDemo { public static void main(String[] args) throws IOException { // 先造一段字节文件(模拟已有的图片或数据文件) try (FileOutputStream out = new FileOutputStream("demo.dat")) { out.write("户籍科登记数据".getBytes("UTF-8")); // 字符串转字节写出 } // 逐字节读:read 返回 0 到 255 的整数 流尽返回 -1 try (FileInputStream in = new FileInputStream("demo.dat")) { int b, count = 0; while ((b = in.read()) != -1) { // 惯用写法:读并判断一步完成 count++; } System.out.println("共读字节数:" + count); // 输出:共读字节数:21(UTF-8 下七字中文) } // 批量读:字节数组当托盘 一次搬一批 try (FileInputStream in = new FileInputStream("demo.dat")) { byte[] buf = new byte[8]; int n = in.read(buf); // 返回实际读到的个数 System.out.println("本次读到:" + n + " 字节"); // 输出:本次读到:8 字节 } } }
try 后跟圆括号的写法叫"自动关闭资源",6.2 节之前先当固定骨架用,第 7 章 7.2 节会拆开讲它替你省了什么。字符流的骨架与之同构,只是单位从字节换成字符:
import java.io.FileWriter; import java.io.FileReader; import java.io.IOException; public class CharStreamDemo { public static void main(String[] args) throws IOException { try (FileWriter w = new FileWriter("note.txt")) { w.write("第一行:登记窗口开放\n"); w.write("第二行:变更窗口开放\n"); } try (FileReader r = new FileReader("note.txt")) { int ch; while ((ch = r.read()) != -1) { System.out.print((char) ch); // 逐字符读 中文不乱 } // 输出两行完整中文 每个汉字作为一个字符读出 } } }
同样的中文内容,字节流逐"字节"读会得到一堆碎块——一个汉字在 UTF-8 下占三个字节,按单字节读出来再转字符必然乱码;字符流逐"字符"读,翻译员把三个字节拼成一个汉字再交给你。这就是两条传送带的选择标准:内容是文本就用字符流,别的(图片、音频、压缩包、序列化数据)一律字节流。
流为什么必须关
骨架里每段都包在自动关闭的 try 里,原因直说:流握着操作系统的资源句柄——文件句柄、网络连接,这些不是 Java 堆里的对象,垃圾回收器管不到它们。不关流的后果有两层:数据可能丢(输出流关闭前会把缓冲区冲刷到目的地,4.2 节说过的缓冲问题在流上同样存在);句柄泄漏(程序不退出时文件一直被占用,Windows 上表现为"文件被另一进程占用,无法删除")。
完整案例:复制一个文件
背景:把一个数据文件复制一份到新文件。操作:字节流加托盘批量读写——复制不能逐字节(慢),要用字节数组分批搬:
import java.io.FileInputStream; import java.io.FileOutputStream; import java.io.IOException; public class CopyCase { public static void main(String[] args) throws IOException { try (FileInputStream in = new FileInputStream("demo.dat"); FileOutputStream out = new FileOutputStream("demo-copy.dat")) { // 两个资源同管 byte[] tray = new byte[1024]; // 一千零二十四字节的托盘 int n; while ((n = in.read(tray)) != -1) { out.write(tray, 0, n); // 只写实际读到的 n 个 防止把托盘尾部旧数据写出 } } try (FileInputStream in = new FileInputStream("demo-copy.dat")) { System.out.println("副本字节数:" + in.available()); // 输出:副本字节数:21 与原文件一致 } } }
结果:副本与原文件字节数一致。解读:两个关键细节——write 时必须带"从零写到 n",因为最后一批通常装不满托盘,整托盘写出会把托盘里残留的旧字节一起写进去;两个流声明在同一个 try 括号里,关闭顺序与声明顺序相反(先关 out 再关 in,第 7 章展开规则)。变式:复制大文件时把托盘加大能再提速,但真正的提速来自缓冲流——下一节的主角;文本文件复制仍建议用字节流原样搬,翻译员(字符流)反而可能在编码转换时画蛇添足。
本节要点回顾
- 流是单向传送带:按内容分字节与字符、按方向分输入与输出,四象限对应四个基类,选型先问搬什么再问往哪搬
- 非文本一律字节流:图片音频压缩包不理解内容照搬;文本用字符流,翻译员保证汉字按字符处理不碎裂
- read 返回负一即流尽:逐字节与托盘批量两种读法,惯用写法"读并判断一步完成"
- write 要写实际读到的个数:托盘最后一批不满,整托盘写出会夹带旧数据
- 流必须关:句柄不是堆对象、垃圾回收管不到;自动关闭的 try 是标准骨架,细节第 7 章拆
裸传送带每次搬运都要穿越到文件系统,速度受限。下一节加装缓冲托盘与编码翻译窗:缓冲流为什么能提速一个量级,转换流怎么指定编码救回乱码。