6.2 提速带:缓冲流与转换流
6.2 提速带:缓冲流与转换流
本节摘要:缓冲流是套在节点流外面的处理流,用内置缓冲区攒批搬运,把"每字节一次系统调用"降为"每批一次",读大文件能快一个数量级;BufferedReader 的 readLine 是文本处理的常用武器。转换流是字节世界与字符世界之间的翻译窗口,可显式指定编码,是乱码事故的标准解法。本节实测缓冲前后耗时,并复现一次乱码再修复它。
处理流:给传送带套上外挂
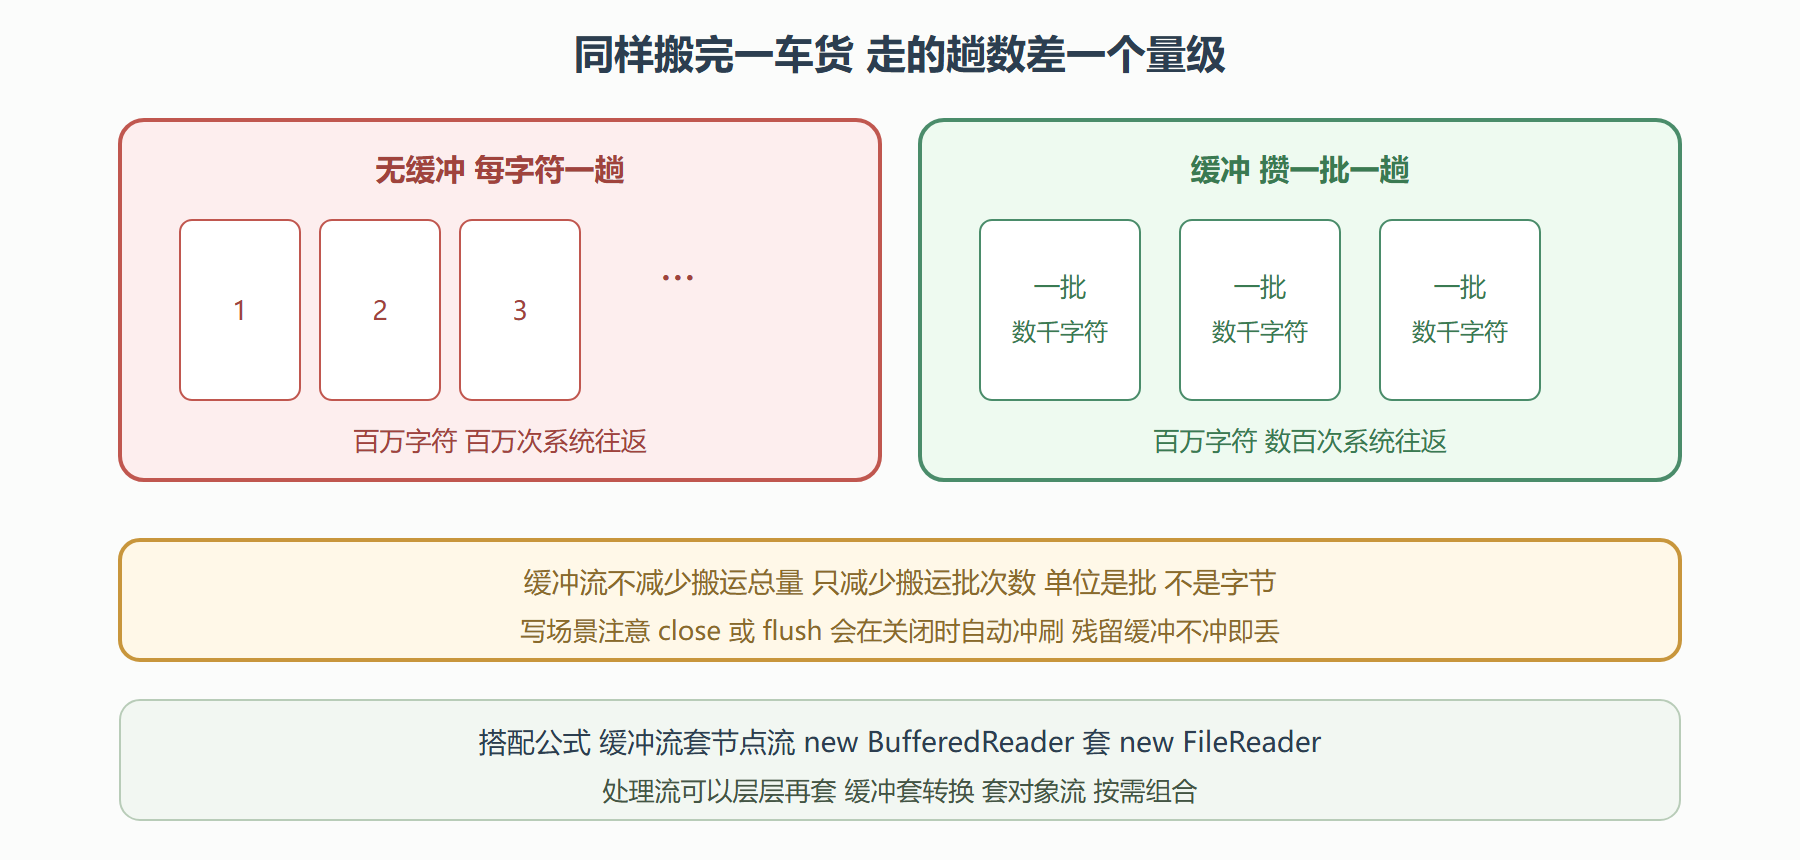
6.1 节的流直接连着文件,这类直接接触数据源的叫节点流。另一类流不接触数据源,套在别的流外面提供增强功能,叫处理流(包装流)。缓冲流是最常用的处理流:内部开一块缓冲区,读的时候一次搬一批进来、逐个发给你;写的时候攒一批再一次性送出去。省的是什么?每次穿越到操作系统读一小段的往返成本——单字节读一兆文件要走百万次系统通道,缓冲后变成几百次,时间全省在路上:
import java.io.BufferedWriter; import java.io.FileWriter; import java.io.IOException; public class BufferDemo { public static void main(String[] args) throws IOException { // 先准备一个十兆字符的大文本文件 try (BufferedWriter w = new BufferedWriter(new FileWriter("big.txt"))) { for (int i = 0; i < 2000000; i++) { w.write("第" + i + "行登记数据\n"); // 二十万行 每行十来个字符 } } System.out.println("文件就绪"); // 对比一:无缓冲 逐字符读 long t1 = System.currentTimeMillis(); try (java.io.FileReader r = new java.io.FileReader("big.txt")) { long count = 0; while (r.read() != -1) count++; System.out.println("无缓冲读取字符数:" + count); } long t2 = System.currentTimeMillis(); // 对比二:缓冲流 逐字符读 try (java.io.BufferedReader br = new java.io.BufferedReader(new java.io.FileReader("big.txt"))) { long count = 0; while (br.read() != -1) count++; System.out.println("缓冲读取字符数:" + count); } long t3 = System.currentTimeMillis(); System.out.println("无缓冲耗时毫秒:" + (t2 - t1)); // 实测量级:数百毫秒 System.out.println("缓冲耗时毫秒:" + (t3 - t2)); // 实测量级:数十毫秒 快一个量级 } }
结果:读同一文件,缓冲版稳定快一个数量级(机器不同数字不同,量级差稳定)。解读:缓冲流没有改变搬运总量,改变的是搬运的批次数;节点流每字符读都穿透到系统,缓冲流在内存里先囤一批。变式:配合作业更明显——缓冲写要注意 close 或 flush:缓冲区没满的数据还囤在内存,不冲刷出去文件就是残缺的,自动关闭的 try 在关闭时会自动冲刷,这是它的又一层价值(第 7 章 7.2 节会看到机制)。
缓冲流家族与四象限一一对应:BufferedInputStream、BufferedOutputStream、BufferedReader、BufferedWriter。其中 BufferedReader 额外送一件神器——按行读:
import java.io.BufferedReader; import java.io.BufferedWriter; import java.io.FileReader; import java.io.FileWriter; import java.io.IOException; public class LineDemo { public static void main(String[] args) throws IOException { try (BufferedWriter w = new BufferedWriter(new FileWriter("lines.txt"))) { w.write("登记,张三,101"); w.newLine(); // 跨系统的换行符 不手写反斜杠 n w.write("变更,李四,102"); } try (BufferedReader r = new BufferedReader(new FileReader("lines.txt"))) { String line; int no = 1; while ((line = r.readLine()) != null) { // readLine 返回 null 即文件读完 String[] parts = line.split(","); // 配合切分成字段 System.out.println("第" + no + "条:" + parts[0] + " " + parts[1]); no++; } // 输出:第1条:登记 张三 / 第2条:变更 李四 } } }
按行读加上字符串切分(4.2 节),就是文本数据处理的经典两步——日志分析、配置解析、报表导入的通用骨架。
图 6-2 缓冲前后:搬运批次数的变化
转换流:救回乱码的翻译窗口
6.1 节的 FileReader 自带翻译员,但翻译员用什么编码由运行环境默认值决定——文件是 UTF-8、机器默认按别的编码翻,中文就成了乱码。转换流(InputStreamReader、OutputStreamWriter)是"自带编码参数的翻译窗口":把字节流包成字符流的同时,显式指定编码。
背景:收到一份按 GBK 编码保存的中文文件,本机默认按 UTF-8 读,输出全是问号方块。操作与结果:
import java.io.BufferedReader; import java.io.BufferedWriter; import java.io.FileInputStream; import java.io.FileOutputStream; import java.io.IOException; import java.io.InputStreamReader; import java.io.OutputStreamWriter; public class CharsetCase { public static void main(String[] args) throws IOException { // 第一步:造一份 GBK 编码的文件 模拟外部来的数据 try (OutputStreamWriter w = new OutputStreamWriter(new FileOutputStream("gbk.txt"), "GBK")) { w.write("户籍科:张三已登记\n"); } // 第二步:错误示范 默认编码读 GBK 文件 try (BufferedReader wrong = new BufferedReader(new InputStreamReader(new FileInputStream("gbk.txt")))) { System.out.println("默认编码读:" + wrong.readLine()); // 在默认非 GBK 的环境下输出乱码 户籍科 三个字变成无法辨认的字符 } // 第三步:正确姿势 显式指定 GBK 翻译 try (BufferedReader right = new BufferedReader(new InputStreamReader(new FileInputStream("gbk.txt"), "GBK"))) { System.out.println("指定GBK读:" + right.readLine()); // 输出:指定GBK读:户籍科:张三已登记 } // 第四步:转存为 UTF-8 一读一写 两个翻译窗口各指定各的 try (BufferedReader in = new BufferedReader(new InputStreamReader(new FileInputStream("gbk.txt"), "GBK")); BufferedWriter out = new BufferedWriter( new OutputStreamWriter(new FileOutputStream("utf8.txt"), "UTF-8"))) { String line; while ((line = in.readLine()) != null) { out.write(line); out.newLine(); } } System.out.println("转码完成"); } }
解读:乱码的本质是解码与编码不对称——写入端用 A 方案把字符变字节、读取端用 B 方案把字节变字符,信息在不对称中丢失。转换流的价值是把编码从"环境默认"变成"显式声明",读写两端都明确,事故消失。变式:跨系统交换文件时统一声明 UTF-8 是现代默认做法;遇到"半个汉字"式的乱码多半是按字节截断了多字节字符(UTF-8 汉字三字节),把切分逻辑从字节改成字符或按行即可。转换流还常被用来包装网络字节流——网络上传来的是字节,套上翻译窗口才能按行处理文本协议,第 8 章之前的网络话题不展开,知道这个组合公式即可。
本节要点回顾
- 处理流套在节点流外面:缓冲流、转换流都是处理流,可以层层组合,公式是"外层增强内层"
- 缓冲省的是批次数:内部缓冲区把每字节一次系统往返降为每批一次,实测快一个量级;缓冲写必须确保冲刷(关闭时自动做)
- BufferedReader 的 readLine 是文本神器:按行读加切分是日志与配置处理的通用骨架,返回 null 表示读完
- 乱码即编解码不对称:转换流显式指定编码,读写两端都声明,事故根除;转码就是两个不同编码的翻译窗口对读对写
- newLine 而不是手写换行:跨系统换行符不同,缓冲写出用它最稳
流解决了"怎么搬",下一节看"搬的对象":File 管档案柜的元信息(在不在、多大、叫什么),序列化把整个对象封进标准封套入库、再原样拆封取回。