2.1 控制平面:播种总站的四个科室
2.1 控制平面:播种总站的四个科室
本节摘要:控制平面是集群的大脑,由 API Server、etcd、调度器、控制器管理器四个科室组成。API Server 是唯一对外柜台,etcd 是唯一的事实台账,调度器只为"还没落地的种子"选地,控制器管理器里坐着一群以调和为业的园丁。理解四者的分工与"互不直连、只走柜台"的协作纪律,是看懂一切集群行为的钥匙。
从一个错误直觉说起
很多人第一次用 kubectl 时的想象是:这个工具连上了某台"主服务器",然后由它逐台登录各机器把容器拉起来。若真这样设计,集群会脆弱得可怜——主服务器得保存每台机器的登录凭据,还得操心命令执行到一半断网怎么办。实际上 Kubernetes 走了完全不同的路:没有任何组件直接命令另一个组件。所有人只做两件事:往 API Server 读 写状态,各自盯着自己关心的那部分变化然后行动。
这条纪律带来的健壮性是惊人的。组件之间互不知道彼此的存在与生死,任何一环短暂失灵,恢复后接着盯台账就行,不存在"半个命令"的烂摊子。把这套纪律对应到农事:总站里每个科室都只对台账负责,从不隔着柜台互相喊话。
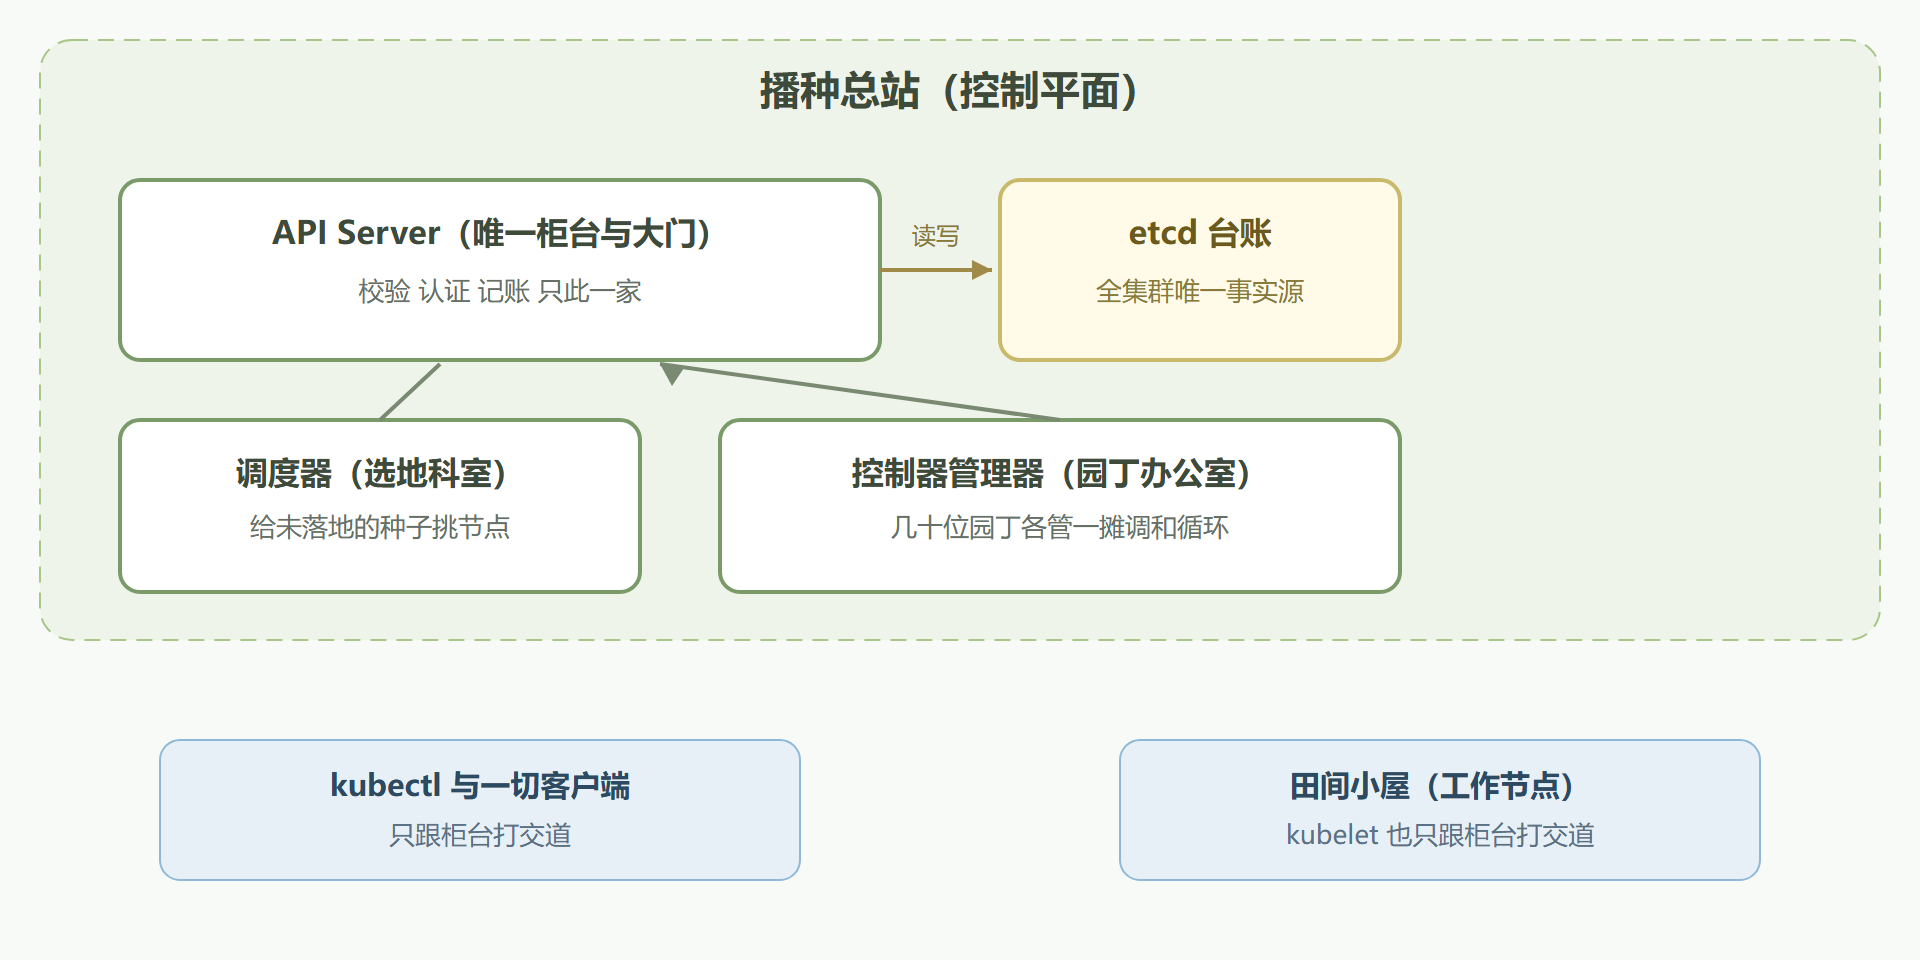
图:播种总站平面布置图
四个科室分别管什么
API Server:唯一柜台。 所有读写请求的必经之路:认证你是谁、鉴权你能动哪些田、校验单子格式合不合规,然后记进台账。它自己不种地、不决策,是个一丝不苟的柜员。正因唯一,它坏了全集群失联(但田里的苗还活着,这是重要的生存设计)。
etcd:田亩台账。 一个分布式键值库,存着全集群的期望状态与实际状态。注意它的地位:唯一事实源。任何组件想知道真相,不去问别的组件,只读台账。台账有多重要?多数集群的灾备演练,核心科目就是备份 etcd 的数据快照。
调度器:选地科室。 它只关心一件事:台账里出现了"没有归属地"的新种子(Pod)。给每粒种子跑一遍打分:哪块田肥力够(资源充足)、有没有忌讳(亲和性规则)、有没有禁地(污点)。打完分,把"种子该去某号田"写回台账,然后这粒种子就跟它没关系了。调度器不做第二次决定,落不落得住是别人的事。
控制器管理器:园丁办公室。 里面坐着一队园丁,每位只盯一种作物:Deployment 园丁管播种计划、节点园丁管田块生死、副本园丁管株数。每位园丁的工作循环一模一样:读台账里的期望,看田里的实际,缺了补、多了减。没有谁指挥他们,他们都自发地循环,这正是上一章"控制循环"的具体执行者。
去总站里看一眼
文字说完了,找点证据。下面这些命令在任何能连上集群的机器都可以敲(暂无集群的读者看注释即可):
# 问柜台:你的服务是否健康(readyz 是柜台的"在岗"自检) kubectl get --raw='/readyz?verbose' # 输出节选: # [+]ping ok # [+]log ok # [+]etcd ok # [+]poststarthook/start-kube-apiserver-identity-plugins ok # ... # readyz check passed
# 看园丁办公室的"值班表":控制器们靠租约选出唯一在岗者,避免双头指挥 kubectl get leases -n kube-system # NAME HOLDER AGE # kube-scheduler cluster-1_9f2c... 120d # kube-controller-manager cluster-1_51ab... 120d # 输出解读:每个科室只有一个 HOLDER 在岗,其余副本待命,这就是"选主"
第一条输出里的 etcd ok 告诉你柜台背后连着台账;第二条输出则是调度器和控制器管理器存在的直接证据。一个看不到的部件不等于不存在,学会找这类"存在证据"是集群工人的基本素养。
科室协作的一次排练
把四者串起来走一遍微缩剧情,为 2.3 的完整时序做铺垫:你交上一份"三株网页"的单子,柜台验单记账;Deployment 园丁看到账上多了新计划,造出三条"待落地的种子"记录;调度器发现三粒种子无地可去,打分后把三号田写给它们;三号田的 kubelet(下一节主角)看到有活儿派给自己,这才去造盆种苗。全程没有谁给谁打电话,所有人只看台账、各干各的。
⚠️ 常见误解:把调度器当成"启动容器的人"。它只写一行"该去哪",真正动手的是节点上的 kubelet。分工如此,功劳才好边界清晰。
总站的高可用:一柜多岗
四个科室里,API Server 是无状态的(数据都记在 etcd),所以可以多开几个副本顶在负载均衡器后面——一个坏掉,其余接单。etcd 是有状态的,靠自身的分布式共识协议保持多副本一致,通常三台或五台成群,容忍少数派失联。调度器与控制器管理器则用本节开头看到的"选主"机制:多副本都在跑,但同一时刻只有主岗干活,主岗失联,从岗立刻顶上。
这套安排的结果值得体会:总站的每个科室都有替补,单点故障不停业。生产集群的控制平面通常就长这样;第九章的桌面试验田则用"一台节点身兼数职"做了学习化简——机制相同,规模不同。
一道容易混淆的分工题
新手常把调度器与控制器管理器的活记混,来一道区分题。以下三件事分别归谁?
- 新 Pod 出现在台账,无归属节点,需要挑一块田:调度器
- Deployment 期望三株,现在只剩两株,需要补种:控制器管理器里的数苗园丁
- 三号田许久没上报心跳,需要标记并善后:节点园丁,同样在控制器管理器里
口诀:选地归调度器,调和归园丁。调度器一辈子只做"给无主种子派地"一件事;园丁千千万,每人只盯一种期望。
观察科室协作的另一个窗口
集群事件流相当于总站的大事记:谁创建了什么、谁调度到了哪、谁又为什么失败,按时间铺开。
kubectl get events -n greenlib-prod --sort-by=.lastTimestamp | head -n 8 # LAST SEEN TYPE REASON OBJECT MESSAGE # 3m Normal Scheduled pod/greenlib-api-... Successfully assigned to node-2 # 3m Normal Pulling pod/greenlib-api-... Pulling image "greenlib/api:2.0.0" # 2m Normal Started pod/greenlib-api-... Started container api # 大事记把各科室的动作按时间串成一条线
前面用 readyz 与 leases 看的是"科室在不在岗",事件流看的是"科室在怎么干活"——两样合起来,黑盒就成了玻璃盒。排错时它常比逐个 describe 更快锁定时间线。顺带一句:控制平面组件与 kubelet 的小版本允许有差,集群因此能逐个科室滚动升级而不用整体停机,可独立更新是分科室设计的又一笔红利。
本节要点回顾
- 纪律高于机能:组件互不直连,一切经由 API Server 读写台账
- etcd 是唯一事实源,备份集群约等于备份台账
- 调度器只选地一次,不跟踪后续;控制器们永远在调和,构成集群心跳
- API Server 宕机田里苗不死,只是没人能改账、看不到新变化
- 下一节下到田间小屋,看 kubelet 如何把种子真正种进土里