2.2 工作节点:kubelet与落地生根
2.2 工作节点:kubelet 与落地生根
本节摘要:工作节点是种子真正生长的田块,其三大件为 kubelet、kube-proxy 与容器运行时。kubelet 是每台机器上的"种植员":它从 API Server 认领派给本节点的种子清单,指挥容器运行时造盆种苗,并持续上报苗情;kube-proxy 负责维护本机的水路规则;容器运行时才是真正启动容器进程的车间。本节拆解三者的日常,并解释 Pod 为什么会被 kubelet 当成"最终交付物"。
节点解剖:一间田间小屋
控制平面再聪明,苗终究长在田里。每台工作节点就是一间田间小屋,屋里住着三位常驻居民:
图:工作节点内部解剖
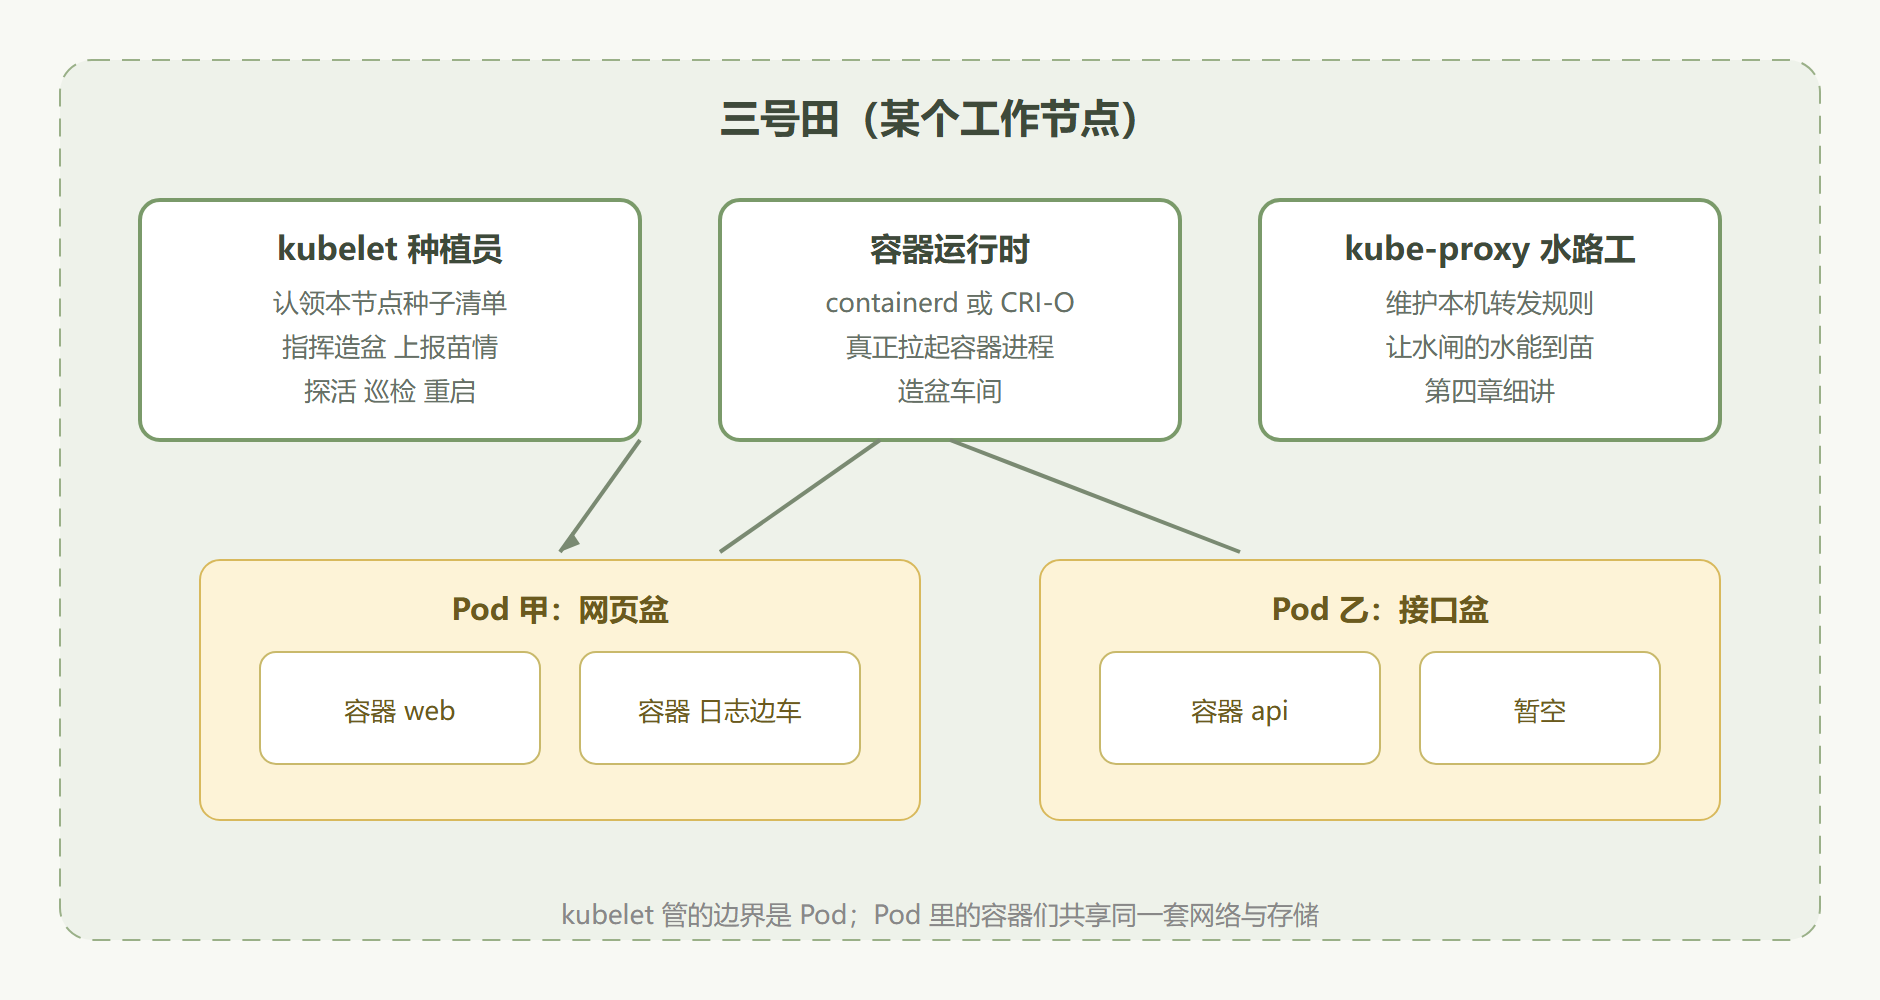
三位居民里,kubelet 名气最大、担子最重。它不是保姆胜似保姆:苗死了要扶(按策略重启)、苗情要报(节点状态与 Pod 状态)、单子变了要执行(更新镜像、改配置)。它也是集群里唯一"知道机器长什么样"的角色——CPU 几核、内存几兆、盘挂哪了,都由它上报进台账,调度器的选地打分用的正是这份土壤报告。
kubelet 的日常:认领与交付
kubelet 对 API Server 只有一个姿态:"把派给本节点的 Pod 清单给我,我来保证它们活着。"它反复对比两份东西:台账里"本节点应有的种子"与本地"实际长着的苗"。对不上就动手:少了让运行时造盆,多了把多余的停掉,坏了按重启策略处置。注意它的视角——它管的单位是 Pod,不是容器。Pod 是下一章的主角,这里先给一个够用的定义:一组绑在一起种的容器,它们共享同一个网络地址和同一块临时田面。kubelet 的世界里没有"单独的容器"这种交付物。
在节点上能看到 kubelet 工作的痕迹(需要登录节点或通过调试容器,此处看输出即可):
# 容器运行时的原生命令:列出本节点所有盆(Pod 里的每个容器都在) crictl ps # CONTAINER IMAGE STATE NAME POD ID # 7c1e55a9d0b3c greenlib-web-0.9.1 Running web 3a91... # 88d2c17b4e0f fluent-bit-2.1 Running log-sidecar 3a91... # b39f0a2c5d71e greenlib-api-0.7.0 Running api c07d... # 观察点:前两行同属一个 Pod ID,它们是一根藤上的两个盆
# 站在集群侧看某块田的土壤报告与苗情汇总 kubectl describe node node-3 # 输出节选: # Capacity: # cpu: 8 # memory: 32766Mi # pods: 110 # Allocated resources: # CPU Requests: 3100m (38%) # Memory Requests: 11264Mi (34%) # Conditions: # MemoryPressure False # DiskPressure False # 解读:Capacity 是 kubelet 上报的家底;Allocated 是已分出去的水肥额度
第二条输出值得多看两眼:Capacity 与 Allocated 的差额,就是调度器下次选地时可动的"余粮"。你在第七章会给每个容器声明额度,那份数据最终就汇流到这里。
kube-proxy 与容器运行时
kube-proxy 这位水路工平时低调。第四章会讲 Service(水闸)如何用一个固定地址挡住"苗地址总在变"的问题,而让流量从水闸真正流到具体某株苗的,正是每台节点上 kube-proxy 维护的转发规则。它不转发应用层内容,只管在网络层把路修通,可以理解成埋在地下的管网。
容器运行时是造盆车间。Kubernetes 通过 CRI(容器运行时接口)这个标准化的"车间对接规范"与车间打交道,所以车间可以换:containerd、CRI-O 都行,早年直接用 Docker 引擎,如今主流是 containerd。对应用来说车间是谁毫无感知,这层标准化保证了生态不被单一实现锁死——这也是它成为"事实标准"的又一处细节证据。
三个角色凑成的生存设计
回看一间小屋的容错逻辑,处处是"各扫门前雪"的智慧:kubelet 短暂失联,苗照常生长,恢复后补报苗情;运行时挂了,只影响本节点,调度器把新种子派往别处;kube-proxy 重启,规则重建,水流恢复。没有任何单点能一次弄死整片田——控制平面坏了苗还活着(上节说的),田里乱了总站还能重派。这套设计哲学有个我很喜欢的说法:集群不是不会坏,而是坏得起。
💡 一个面试常考也实践常用的区分:kubelet 管"苗该不该活",调度器管"种子该去哪",控制器管"田里该有几株"。三个"该"字读三遍,集群的角色分工就再也不会混。
水路工的三种修管方式
kube-proxy 维护转发规则有三种模式,名字与思路都值得认一眼:
| 模式 | 思路 | 特点 |
|---|---|---|
| iptables | 在内核防火墙规则表里写转发链 | 传统默认,规则一多性能下降 |
| ipvs | 用内核的虚拟服务模块做转发 | 规则多时性能稳,大集群首选 |
| userspace | 用户态进程亲自搬运流量 | 老模式,早已退场 |
入门阶段不必深究切换方法,但要建立一个认知:水闸的分流动作实际发生在每台节点的内核里,kube-proxy 只是把名单翻译成本地规则。这也解释了一个现象——水闸背后名单的更新有几秒延迟:从台账变化到各节点规则生效,中间隔着一次分发。
节点失联时会发生什么
田块与小屋失联(网络分区或宕机)是一类特殊故障,处理逻辑体现机制自卫:控制平面连续一段时间收不到节点心跳,节点园丁把该田标记为 NotReady;再过一段宽限期,田上的苗被判定失联。数苗园丁此时面临抉择——苗可能还活着,网络恢复后会回来,所以默认等宽限期走完才在别处补种。集群对"不确定的坏"宁可多等,也不制造双份,这个脾气在数据库场景里是能救命的。
收工检查单
- kubelet:节点上的种植员,认领 Pod 清单、指挥运行时、上报苗情与家底
- kube-proxy:本机水路工,维护通往 Service 的转发规则
- 容器运行时:造盆车间,经 CRI 标准接口可替换
- Pod 是 kubelet 的交付单位,容器只是 Pod 里的成员
- 节点的 Capacity 与 Allocated 来自 kubelet 上报,是调度选地的依据
- 下一节回到大门,把一次 apply 的完整旅程走通