8.2 监控与日志:田间气象站
8.2 监控与日志:田间气象站
本节摘要:监控回答"现在怎么样、和昨天比怎么样",指标管道由 cAdvisor 采集、metrics-server 汇聚成 kubectl top,完整方案常配 Prometheus 与告警;日志回答"当时发生了什么",苗的日志用 kubectl logs 取,集中方案由 DaemonSet 采集器统一收走。本节用两套工具各复盘一次真实故障,并给出"先看什么再看什么"的固定顺序。
气象站与田间记录的分工
第七章用过 kubectl top,但没问过数字从哪来;也用过 kubectl logs,但苗一多就力不从心——逐株翻日志像挨个问田里每株苗"你昨天几点蔫的"。这一节把两件事的体系补全。
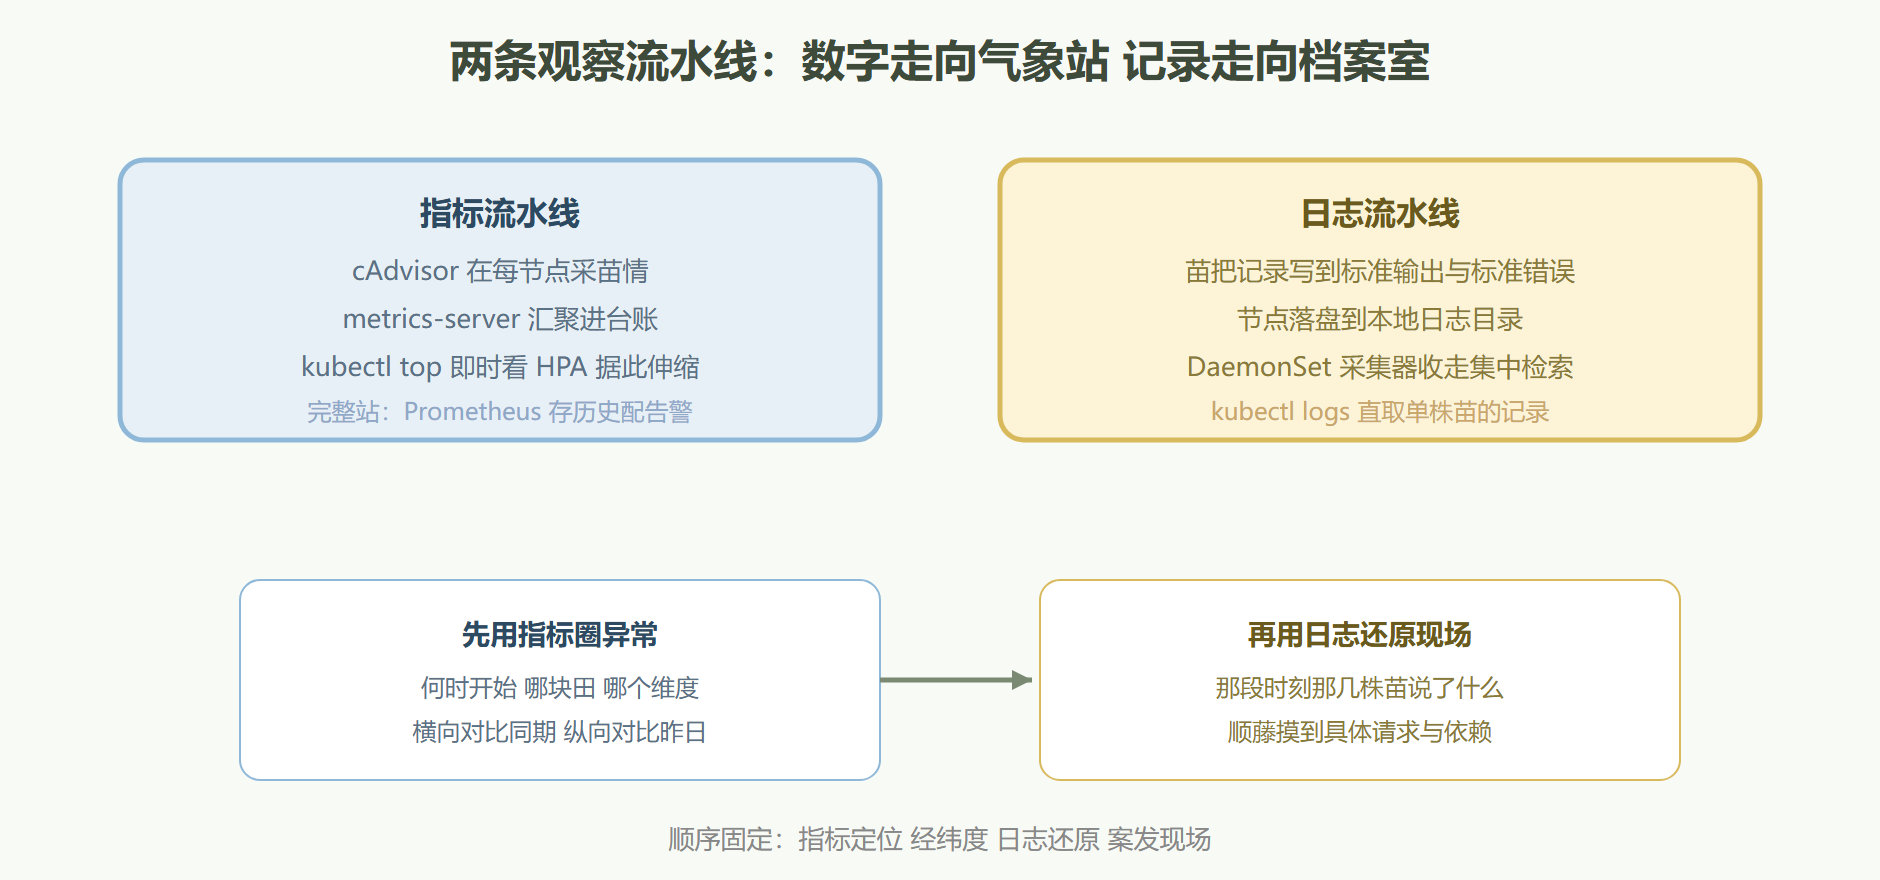
**监控(指标)**是气象站:定时采样、只存数字、看趋势。它回答"水情如何、哪块田偏旱、比昨天同时段高多少"。日志是田间记录:按时间记事、详略由应用决定、看细节。它回答"那一次失败请求,前后都发生了什么"。排障时两者配合:先用指标圈定"何时、何地、哪个维度异常",再用日志还原"具体怎么异常"。
图:指标与日志的两条流水线
复盘一:服务变慢(指标主场)
傍晚有读者反馈书屋"翻页慢"。先看气象:
# 田级水情 kubectl top nodes # NAME CPU(cores) CPU% MEMORY(bytes) MEMORY% # node-3 1920m 48% 11234Mi 68% # 疑点田里的苗级水情 kubectl top pods -n greenlib-prod --containers | sort -k 3 -h -r | head -n 4 # POD(INTERFACE) CPU(cores) MEMORY(bytes) # shelf-db-0 1870m 1902Mi 内存比昨天同时段高出六百多兆 # greenlib-api-... 210m 402Mi
数据库苗的内存曲线异常抬升,圈定嫌疑。再看它的实时记录(日志客场):
kubectl logs -n greenlib-prod shelf-db-0 --tail=20 | grep -i slow # 20:12:41 slow query 2.4s SELECT ... JOIN borrow_records ... # 20:13:02 slow query 3.1s SELECT ... JOIN borrow_records ...
慢查询定位到具体语句,接下来是数据库调优的事了(加索引),监控与日志的接力到此完成。kubectl top 看的是当下;要看"比昨天高多少"的趋势与触发告警,生产标配是 Prometheus 一类的时序库加告警规则,超出入门册动手范围,但认知框架一致:指标存历史,阈值触发通知。
复盘二:苗反复重启(日志主场)
另一天,采集苗每几分钟重启一次,指标只显示"重启计数在涨",真相在日志里:
# 当前世的日志 kubectl logs -n kube-system log-collector-k2p8v --tail=5 # [error] failed to connect output: connection refused # [ info] retrying in 5s # [error] failed to connect output: connection refused # 采集器连不上下游管道 反复崩溃重启 # 配合档案看处置历史 kubectl describe pod -n kube-system log-collector-k2p8v | grep -A 4 "Last State" # Last State: Terminated # Reason: Error Exit Code: 1 # 结合 8.1 的知识:DaemonSet 模板里没配存活探针 退避重启靠的是容器策略
日志直接指认了病灶(下游管道未起),修复方向随之确定:先把管道服务种回来,再看采集器的退避是否收敛。这里也补一个此前埋着的机制说明:苗的日志必须写标准输出与标准错误,kubelet 才能落盘接管;写到容器内随机文件里的日志,苗一收就没了,采集器也看不见(回顾 6.3 稻草人挂载的节点日志目录,正是这套体系的地基)。
集中化的下一步
逐株 kubectl logs 在小田够用,田一大就要集中检索(按时间、按标签、按关键字横扫全田)。业界常见组合是采集侧用第六章种过的 DaemonSet 采集器,存储检索侧用 Loki 或 Elastic 一族,展示用 Grafana。它们全都长在 Kubernetes 上——监控体系自己也是一片苗,这个认知闭环颇有意味:气象站本身站在田里。
💡 一个容易被忽视的顺序问题:出事时人总爱一头扎进日志海。先花一分钟看指标把"何时、何地、哪个维度"圈出来,日志检索的范围就能从全田缩到几株苗的几分钟——这在事故现场是十倍效率的差距。
日志的两条纪律
写对地方:应用日志一律走标准输出与标准错误,kubelet 负责落盘与轮转(默认单文件约十兆、保留若干份)。写进容器里随机路径的日志等于写了就丢——采集器看不见,kubectl logs 也读不着。书屋早期有条日志写进了应用目录,排查时怎么都找不到,改到标准输出后世界清净了。
带上身份:多苗同名同姓,日志行里若没有足够上下文(请求标识、租户标识),集中检索时对不上号。规范做法是应用侧输出结构化日志(键值或 JSON 行),采集器再贴上苗名、田名等标签。字段对齐了,"按一次请求追全程"才有可能。
指标体系的分层
气象站该看什么,业界有个压得很实的四层划分,拿来即用:
| 层 | 看什么 | 回答的问题 |
|---|---|---|
| 资源层 | 节点与苗的水肥水位 | 田渴不渴,苗撑不撑 |
| 应用层 | 请求量、错误率、延迟 | 服务好不好用 |
| 中间件层 | 连接数、队列积压 | 依赖健不健康 |
| 业务层 | 借阅量、活跃读者 | 生意好不好 |
四层自下而上逐层归因:资源正常而应用异常,查代码;应用正常而业务异常,查运营。kubectl top 只覆盖最底层的即时光景,往上的层次属于 Prometheus 生态的辖区,但分层的思维从第一天就该建立。
本节要点回顾
- 指标是气象站(采样看趋势),日志是田间记录(记事看细节)
- 指标管道:cAdvisor 采集、metrics-server 汇聚、kubectl top 展示、HPA 消费
- 日志管道:标准输出落盘,kubectl logs 直取,DaemonSet 采集集中化
- 排障固定顺序:指标定经纬,日志还原案发现场
- Prometheus 与 Grafana 是生产标配的下一步,框架与本节一致