8.1 探针与自愈:苗情巡检三件套
8.1 探针与自愈:苗情巡检三件套
本节摘要:探针是 kubelet 对苗的定期体检:存活探针判"该不该重启",就绪探针判"能不能进水闸名单",启动探针护"慢热苗的启动期"。配置得当时系统先于人发现问题;配置失当时会造成重启风暴或服务雪崩。本节给书屋接口苗装齐三件套,并复盘一次"探针太激进"的经典事故。
进程活着,不等于服务能用
先辨析一对概念:活着与能用。一个进程僵而不死(死锁、内存撑爆前的假死)时,进程管理器看它是活的,用户看它是废的;反过来,应用刚启动还在暖机(加载词库、建连接池)时,进程是活的,但一时半会儿接不了客。kubelet 只看得懂"进程在不在",看不懂"服务行不行"——探针就是你替 kubelet 准备的听诊器:指定一个检查动作与频率,让 kubelet 按单体检。
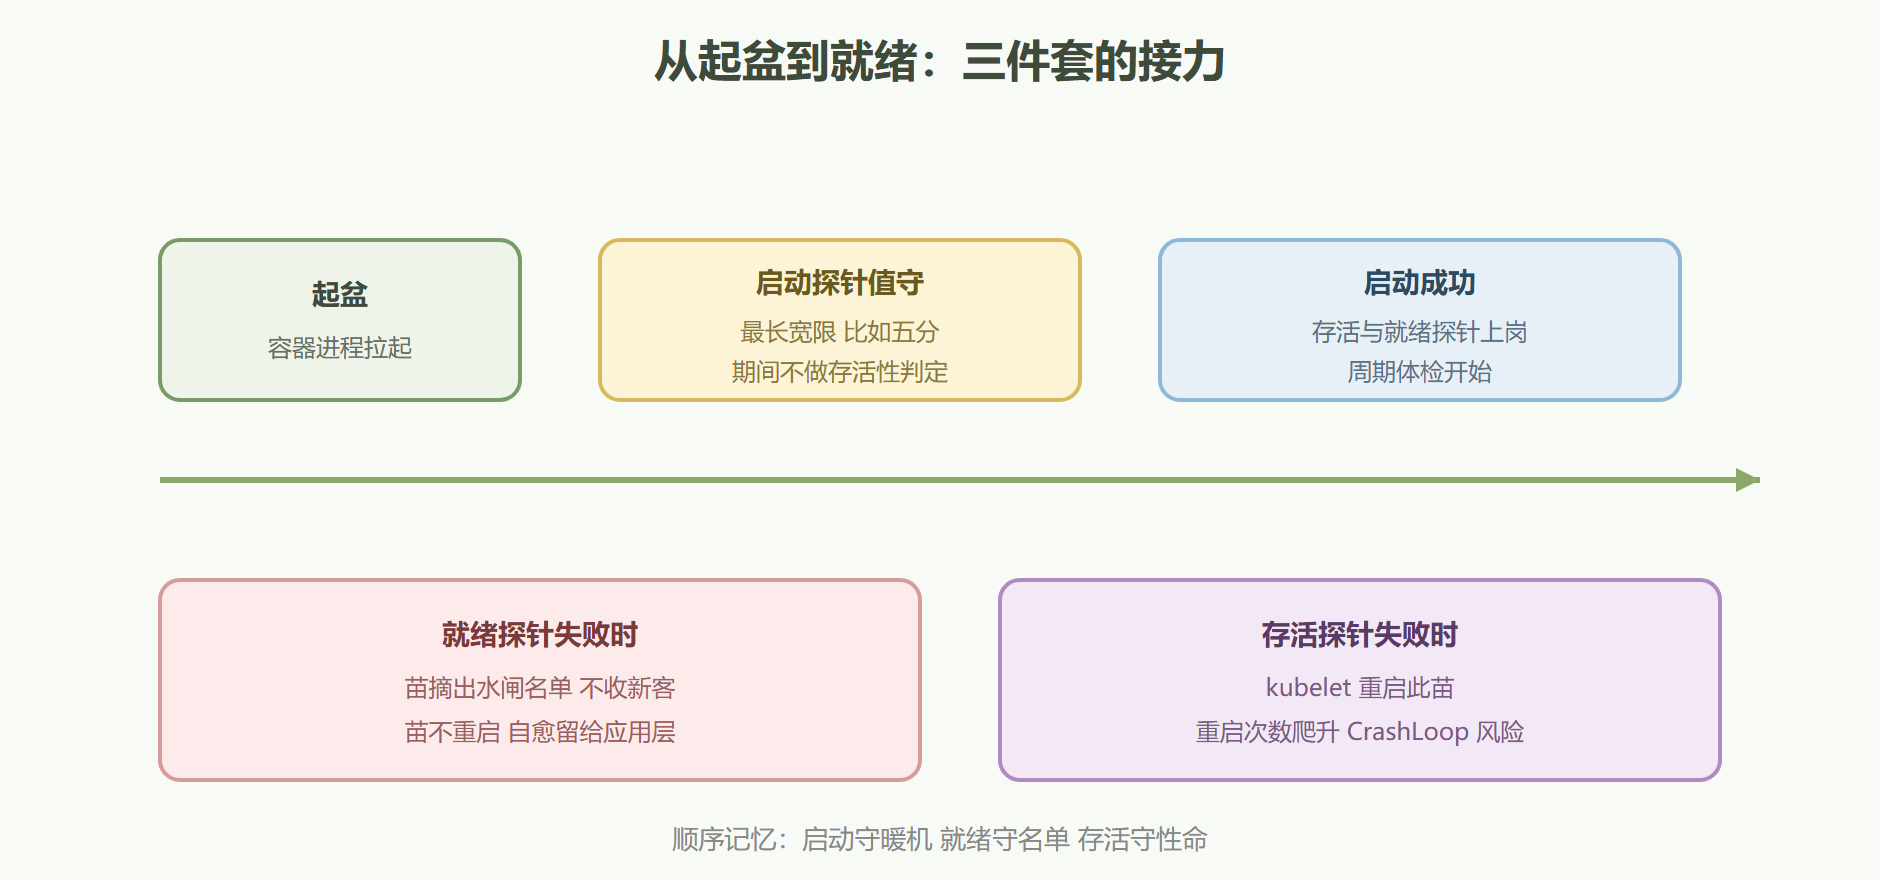
三件套各管一个阶段:
| 探针 | 回答的问题 | 失败的处置 |
|---|---|---|
| 存活 liveness | 这株苗病入膏肓了吗 | 重启它 |
| 就绪 readiness | 这株苗现在能接客吗 | 摘出水闸名单 |
| 启动 startup | 这株苗暖机完了吗 | 暂不做上面两项检查 |
处置的差别是理解三者的钥匙:存活探针失败动苗本身(重启),就绪探针失败动名单(摘除)。把两者配反是新手大忌,后面的事故复盘正是它。
图:一株苗的体检时间线
给接口苗配齐三件套
# 播种单里的探针配置(容器清单节选) - name: api image: greenlib/api:2.0.0 startupProbe: # 先守启动:慢热苗的庇护期 httpGet: path: /healthz port: 8080 failureThreshold: 30 # 允许连败三十次 periodSeconds: 10 # 每十秒问一次 合计宽限五分 livenessProbe: # 再守性命:僵死就重启 httpGet: path: /healthz port: 8080 periodSeconds: 10 failureThreshold: 3 # 连败三次判定病危 timeoutSeconds: 2 readinessProbe: # 常守名单:不能接客就摘除 httpGet: path: /ready # 注意路径不同 语义更严格 port: 8080 periodSeconds: 5 failureThreshold: 2
kubectl apply -f api-deployment.yaml -n greenlib-prod # 观察:苗进入 Running 后仍非 Ready,直到就绪探针放行 kubectl get pods -n greenlib-prod -l app=greenlib-api # NAME READY STATUS RESTARTS AGE # greenlib-api-66d8f9bcb-x1 0/1 Running 0 15s # greenlib-api-66d8f9bcb-x1 1/1 Running 0 40s 暖机完 进入名单 # 体检记录在档案里 kubectl describe pod -n greenlib-prod greenlib-api-66d8f9bcb-x1 | grep -A 2 "Liveness" # Liveness: http-get http://:8080/healthz delay=0s timeout=2s period=10s # Readiness: http-get http://:8080/ready delay=0s timeout=5s period=5s # Last State: 记录里还能翻到历次重启的原因
三个参数值得反复掂量:periodSeconds 是体检频率,timeoutSeconds 是单次等待(体检本身卡住也算病),failureThreshold 是连败容忍。调参的总原则:宁可迟钝,不可过敏——下一小节就是反面教材。
一次探针过敏事故的复盘
书屋曾把存活探针的 timeout 配成了一秒、failureThreshold 配成一。接口在晚高峰偶发慢响应(数据库换茬时的毫秒级抖动),探针把"慢一秒"误判为"病危",连败即重启;重启暖机期间流量压向其余苗,其余苗跟着变慢,跟着被判危,跟着重启——一场由听诊器引发的重启风暴。logs 里的证据链:
kubectl logs -n greenlib-prod greenlib-api-66d8f9bcb-x7 --previous | tail -n 4 # 20:41:07 GET /healthz 1183ms 超过一秒的体检窗口 # 20:41:07 Liveness probe failed: HTTP probe failed with statuscode: 500 # 20:41:08 INFO shutting down gracefully # (重启计数加一 紧接着下一株也被判危)
复盘改法:体检路径与业务路径分离(/healthz 只查进程与关键依赖的连通,不查慢查询)、timeout 放宽到两三秒、容忍连败三次、就绪探针兜住"慢但没死"的场景(摘名单而非重启)。重启是核选项,摘名单是常规动作——能用名单解决的,绝不动苗。
⚠️ 常见坑三连:其一,存活与就绪配同一个敏活动作,等于给过敏体质上了双保险;其二,启动探针缺席,慢热苗还没暖完机就被存活探针判死,陷入"起盆即重启"的死循环(现象:RESTARTS 一路涨、日志永远停在初始化);其三,体检路径里放了重查询,探针自己把苗压垮——体检要轻,问"活着吗",别问"今天业绩如何"。
探针的三种问法
探针的体检动作有三种写法,按需选用:
| 问法 | 写法 | 适合 |
|---|---|---|
| HTTP | 打一个路径看状态码 | 有健康接口的 Web 服务,首选 |
| TCP | 尝试连一个端口 | 无专接口但监听端口的服务 |
| 命令 | 在苗里执行一条命令看退出码 | 需要脚本级自检的复杂应用 |
书屋接口用 HTTP 问健康路径,数据库苗用 TCP 问端口——不同作物不同听诊姿势。无论哪种,动作都要轻、快、确定(两三秒内出结果),这与"宁迟钝勿过敏"是同一条原则的两面。
本节要点回顾
- 三探针分工一句话:启动守暖机、就绪守名单、存活守性命
- 就绪失败摘名单,存活失败重启苗——处置对象完全不同
- 调参总原则宁迟钝勿过敏,重启是核选项
- 启动探针是慢热苗的庇护期,缺席会造出"起盆即重启"的死循环
- 体检路径要轻,与业务路径分离
- 探针配好后,第七章的滚动更新才算真正安全:坏苗进不了名单