2.1 数据库设计流程
2.1 数据库设计流程
本节摘要:数据库设计不是"打开客户端直接建表",而是一条需求分析、概念设计、逻辑设计、物理设计四阶段流水线,每个阶段有明确产出物。本节讲清每个阶段做什么、评审会在哪几步卡点,并用一次真实返工说明跳步的代价。位置:本章的路线图,后面两节是其中两个阶段的手册。
一次跳步引发的半年返工
先讲事故。某 SaaS 团队接了个工单系统需求,产品经理口头说了句"就是客服聊天记录",程序员当天建了表:chat_record,字段包括会话 ID、消息内容、时间。三个月后需求长出工单状态、处理人、SLA 时限,表加字段;再三个月长出多轮次、满意度评价、内部备注,表继续加字段;半年后这张表有 31 个字段,其中 14 个绝大部分行为空,最关键的是——没人能说清第 17 个字段 ext 里那些 JSON 到底存了什么。最终团队停服两天做结构重造,比一开始走完整流程多花三倍时间。
这件事的错误不在字段设计,而在起点:把"建表"当成了设计的全部。需求只被听过一次、从未被结构化确认,后面每一步都在为这个空洞付利息。
四阶段流水线与产出物
图 4 · 设计流程与评审卡点泳道图
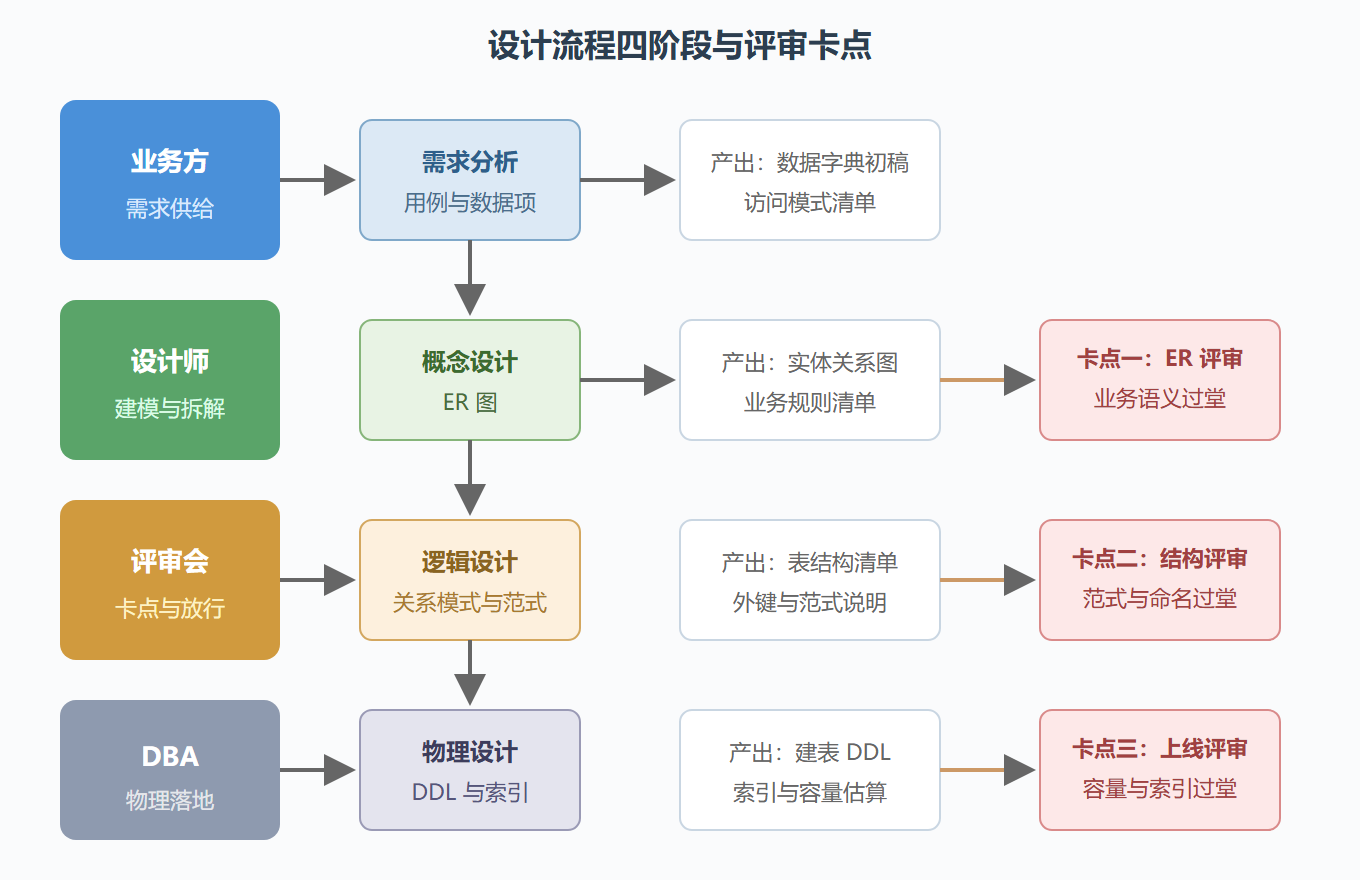
四个阶段一句话概括:需求分析回答"要存什么、谁在什么时候怎么访问";概念设计回答"业务世界里有哪些东西、它们什么关系",产出 ER 图,与任何具体数据库无关;逻辑设计把 ER 图翻译成关系模式,主键、外键、范式校对都在这一步;物理设计面向选定的 MySQL 版本和硬件,敲定类型、引擎、索引、分区,产出可执行 DDL。
评审会的价值不在最后签字,而在三个卡点各拦一次:ER 评审拦"业务理解偏差",结构评审拦"设计缺陷",上线评审拦"性能隐患"。前面拦一次的成本,是后面拦同样问题的十分之一。
演练:给工单系统补做一遍概念设计
背景:还是上面那个返工案例,假设时光倒流。操作:先列数据项和访问模式,再画实体。
需求追问记录: - 工单由谁提?客户。客户与工单是 1:N(一个客户多个工单)。 - 一条工单有几轮对话?N 轮 → 对话应独立成表,与工单 1:N。 - 工单会转给不同客服处理吗?会 → 处理记录独立成表,含交接时间。 - 评价针对谁?整张工单 → 评价字段放工单表还是独立表?数据量小放主表,字段多则独立。
结果:四张表——customer、ticket、ticket_message、ticket_transfer。解读:因为先问了"会转给不同客服吗",交接记录才有了自己的表;原来 ext JSON 里藏着的,正是这些没被问出来的业务事实。变式:如果业务后续长出"跨工单合并",再引入 ticket_group 关系即可,四张表的结构不用推倒。
易错点与命名规范速讲
- 把原型图当需求:原型回答"页面长什么样",不回答"数据怎么变"。数据项要从用例和状态变迁里挖,不是从截图里抄;
- 产出物不存在:ER 图和数据字典没写下来,三个月后就是考古现场。文档要求不高,但必须存在、必须跟上版本;
- 命名规范无小事:评审会上为
userPwd还是user_password吵十分钟并不浪费时间——规范的价值在跨表一致与新人可读。通用约定:库表用小写下划线分隔,布尔字段 is_ 前缀,时间字段 _at 或 _time 结尾统一其一,禁用数据库保留字,每张表和每个字段带 COMMENT。规范一旦确定就写进团队文档,评审照章执行,不再逐条争论。
变更管理:上线后流程并没有结束
设计流程最容易被忽略的真相是:四阶段走完只是第一轮。上线后的每一次需求迭代都会触发新一轮"小型设计流程",而多数团队对变更的管理远比初始设计松散。补一套变更规则:结构变更走评审——加字段要先问"这个字段的历史数据是什么语义",改类型要走 3.1 节的在线 DDL 评估;数据字典随变更更新——字段含义、枚举值、上下游依赖三项缺一不可,没更新字典的合并请求不批;访问模式季度复审——把慢查询排行(第 5 章)和表结构对照看,访问模式漂移了,索引与拆分策略要跟着调。
工单系统那个案例还有后半段:推倒重造时团队立了一条规矩——每次需求评审会上必须有一个"数据问题清单"环节,产品、后端、DBA 各带三个问题来。听起来仪式感很重,实际执行三个月后,新表的一次结构变更都没有发生过。流程的价值不在文档厚度,而在把该问的问题问到。
各阶段产出物的验收标准
评审卡点要可执行,就得给每阶段产出物定验收标准。需求分析阶段:数据字典初稿覆盖所有名词实体,访问模式清单列出读写比例与峰值量级——两个数字说不出,概念设计不许开工。概念设计阶段:ER 图通过业务方指认,每个关系能被一句业务口语反向解释;说不出解释的关系八成是想多了或想错了。逻辑设计阶段:每张表能回答主键是什么、按什么范式、哪些字段是快照;三个答案凑不齐就退回。物理设计阶段:DDL 可执行、索引清单能对应到具体查询、容量估算给出三年量级——估算本身就是设计者对业务理解深度的测试。这套标准贴在评审会纪要模板里,会议效率反而更高,因为争论收敛到了固定框架内。
要点回顾:四阶段各有产出物,缺哪阶段的账迟早要还;评审卡点前置,拦错成本逐级放大;命名规范的价值在一致性而不在具体选哪种;上线后变更走小型流程,字典与访问模式持续维护。下一节进入流程的核心工具——ER 模型。
评审会现场:一张需求单走到第一版 ER 图
需求单原文(某生鲜电商,节选):「商家可以发布商品,一个商品有多个规格;买家下单,一个订单可能包含多个商家的商品;买家可以给已购买的商品评价;运营要按类目和城市看销量。」
第一轮提炼出的实体只有四个:商家、商品、订单、买家。评审会在这里按下暂停键,因为有两处含糊会直接决定表结构走向:
- 「多个商家的商品」:一个订单里出现多商家商品,意味着订单与商家不是一对多,而是订单与"商家子单"一对多。这是 2.2 讲的一对多关系没有被识别出来,硬做成订单直接挂商家,后期结算与售后必然返工。结论:引入"子订单"实体,订单 → 子订单 → 订单明细三层;
- 「评价」的归属:评价挂在商品上还是挂在订单明细上?挂在商品上无法证明购买行为,刷评价成本极低。结论:评价外键指向订单明细,商品页的评价通过订单明细反查。
争议最大的是规格:商品有规格(大份/小份),规格影响价格与库存。三种做法在会上被摆到桌面:
| 做法 | 结构 | 适用 | 代价 |
|---|---|---|---|
| 每个规格一行商品 | 规格即商品,冗余少量字段 | 规格少、规格间差异大 | 商品表膨胀,运营发布体验差 |
| 商品 + 规格表 | 商品主表存公共信息,规格表存价格库存 | 主流选择,规格差异可控 | 查询要多一层 JOIN |
| 规格塞 JSON 列 | 商品表一个 JSON 字段装全部规格 | 规格结构不稳定、只整存整取 | 无法按规格建索引与统计 |
会上选了第二种,理由不是它最优雅,而是运营后台的筛选需求——"按价格区间找商品"——要求规格价格可被索引,JSON 方案当场出局。这就是设计流程里最容易被跳过的一步:先问查询长什么样,再定字段放哪里。
改到第二版的表清单(节选):商户表、商品表、商品规格表、订单表、子订单表、订单明细表、评价表。每张表的审计字段(创建时间、更新时间、逻辑删除标记)在会上统一约定,避免各写各的。
回头看,这一轮评审花掉的四十分钟,省掉的是上线后一次跨三张表的结构重构。设计流程的价值不在于产出漂亮的图,而在于把含糊之处提前逼出来。