- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
MySQL 基础:数据库设计与优化 · 教程导读
一个字段四十七个、把用户姓名与收货地址全都塞进去的订单表,看上去考虑得够周全了——为什么上线才一个月,想加一个「配送方式」就得锁全表两小时?
本册简介:这套教程以"建表评审会"为主线,带你完整走一遍 MySQL 数据库从需求分析、表结构设计、SQL 编写到索引优化、架构演进的全部关键环节。全书七章三十三节,用一个反复被打回、反复返工的电商订单系统做贯穿案例,讲清关系型数据库设计与性能优化的核心方法论。
一个场景:周三下午三点,会议室。刚入职三个月的后端工程师把第一版订单表设计投上幕布——order_info 一张表,字段四十七个,把用户姓名、收货地址、商品名称、库存数量全都塞了进去。DBA 看了三十秒,说了一句话:"这张表上线一个月后,你就得改它的地址字段,改一次要锁全表。"评审没通过,回去改。第二次评审,范式问题解决了,但有人问:"用户查询最新订单的 SQL,你打算用什么索引扛住?"答不上来,又被打回。第三次、第四次……直到第五版,这张表才真正走上生产线。
这本书写的就是那五版之间的全部过程。
数据库设计与优化这门技术,难不在知识点多,而在判断。每个知识点单独看都不复杂——什么是主键、什么是索引、怎么写 JOIN——难的是面对一个具体业务时,你敢不敢拍板"这张表就该这么建",能不能预判半年后的数据量增长,能不能在评审会上解释清楚每一个字段存在的理由。判断力没法靠背概念获得,只能靠一遍遍被真实评审意见锤打。所以本册没有采用"先讲概念再举例"的传统结构,而是反过来:让一个订单系统从头到尾经历七轮评审,每一章就是一轮,每个知识点都出现在"评审委员提出质疑、设计者给出回应"的真实语境里。你会发现,范式理论是在第二次评审被质疑"地址重复存储"时才真正被理解的;B+ 树索引是在有人问"为什么这个查询要扫两千万行"时才变得具体的。
全册知识地图
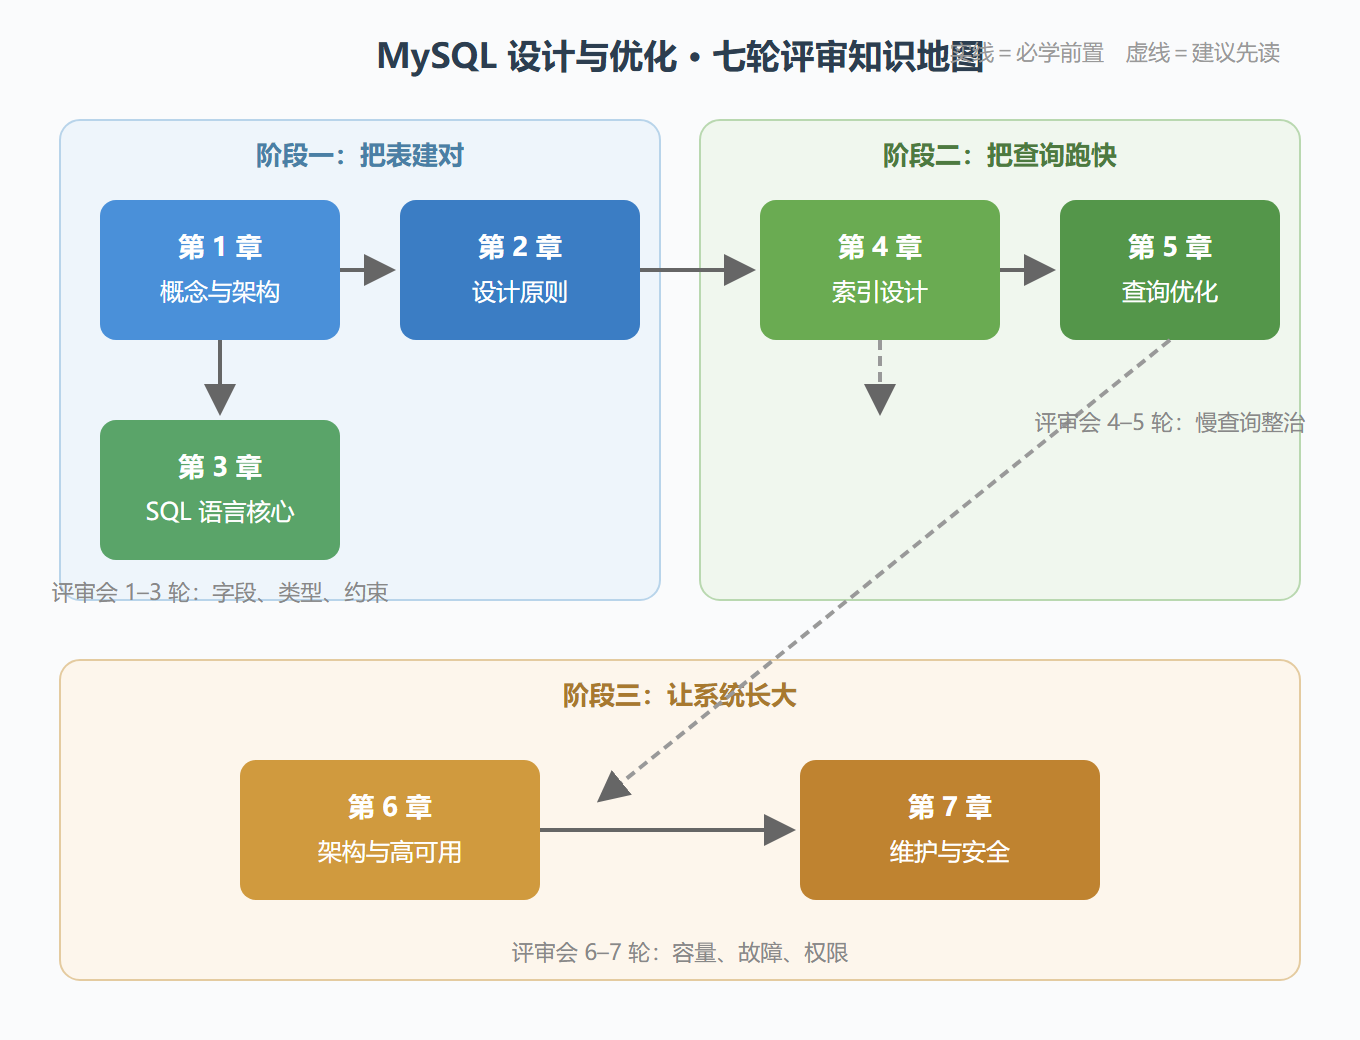
七章之间存在明确的学习依赖:设计(第 1、2 章)是地基,SQL(第 3 章)是日常工具,索引(第 4 章)是性能的钥匙,查询优化(第 5 章)是钥匙的使用方法,架构(第 6 章)与维护(第 7 章)则是系统长大后的必修课。建议按章顺序学习,跨章跳跃时先确认前置章节已读。
图 1 · 全册知识地图与学习依赖关系
你将经历什么
全书七章对应七轮评审。第 1 章把地基打好:关系模型的来龙去脉、MySQL 的分层架构、InnoDB 与 MyISAM 的取舍、数据类型与约束的评审要点。第 2 章进入设计方法论:设计流程怎么走、ER 图怎么画、范式与反范式怎么权衡,以及命名规范这种评审会上最容易吵起来的话题。第 3 章是 SQL 全景——DDL、DML、DQL、事务控制与权限、JOIN 与子查询,四节内容覆盖日常百分之九十的语句。第 4 章值得慢读:索引的 B+ 树原理、各索引类型的适用边界、复合索引的最左前缀、覆盖索引的回表逻辑,以及八种典型失效场景。第 5 章教你用 EXPLAIN 与慢查询日志给语句"看病",排序分组优化的原理也在这一章。第 6 章视野上移:事务隔离与锁、主从复制、分库分表、高可用与负载均衡。第 7 章收尾于运维日常:备份恢复、监控与参数调优、权限审计与故障排除。
学习建议与产出标准
每一节的结尾都附"评审清单"——把本节知识点转成可以在真实评审会上提出的问题。读完后,建议你拿自己项目里的一张表做一次模拟自审:能不能说清每个索引存在的理由?最坏查询的扫描行数量级是多少?数据量翻十倍后架构顶不顶得住?三个问题都答得上,这本册子的目标就算达成了。数据是企业的资产,而设计评审是这份资产入库前最后一道质检——愿你下次坐进评审会时,是被提问的人,而不是被打回的人。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...