2.3 范式与反范式
2.3 范式与反范式
本节摘要:范式理论回答"一份数据该存几份",三范式层层递进消除冗余;反范式化则是在性能压力下有意引入受控冗余。本节用一张违反范式的订单表演示三步拆解,再给出反范式的适用边界与同步代价核算。位置:概念设计的校对工序,也是全书第一次正面讨论性能与规范的取舍。
范式到底在防什么
想象一个场景:订单表里存了客户电话,客户改了手机号,五百条历史订单里躺着五百个旧号码——客服按新号码查订单,一条都查不出来。这就是冗余的代价:同一事实存了多处,更新它就要多处同步,漏一处就是数据不一致。范式理论的全部内容,就是把"哪些事实容易被重复存储"这件事系统化,给出层层收紧的检查标准。
评审会对范式的质疑常有一句开场白:"教科书的东西,实战哪有那么多讲究?"这句话对一半——实战确实不必死守 3NF,但必须先懂范式再破范式。不懂而破是埋雷,懂了而破是权衡,评审会上两者的待遇天差地别。
三步拆解一张违规订单表
图 5 · 违规表到 3NF 的拆解对照
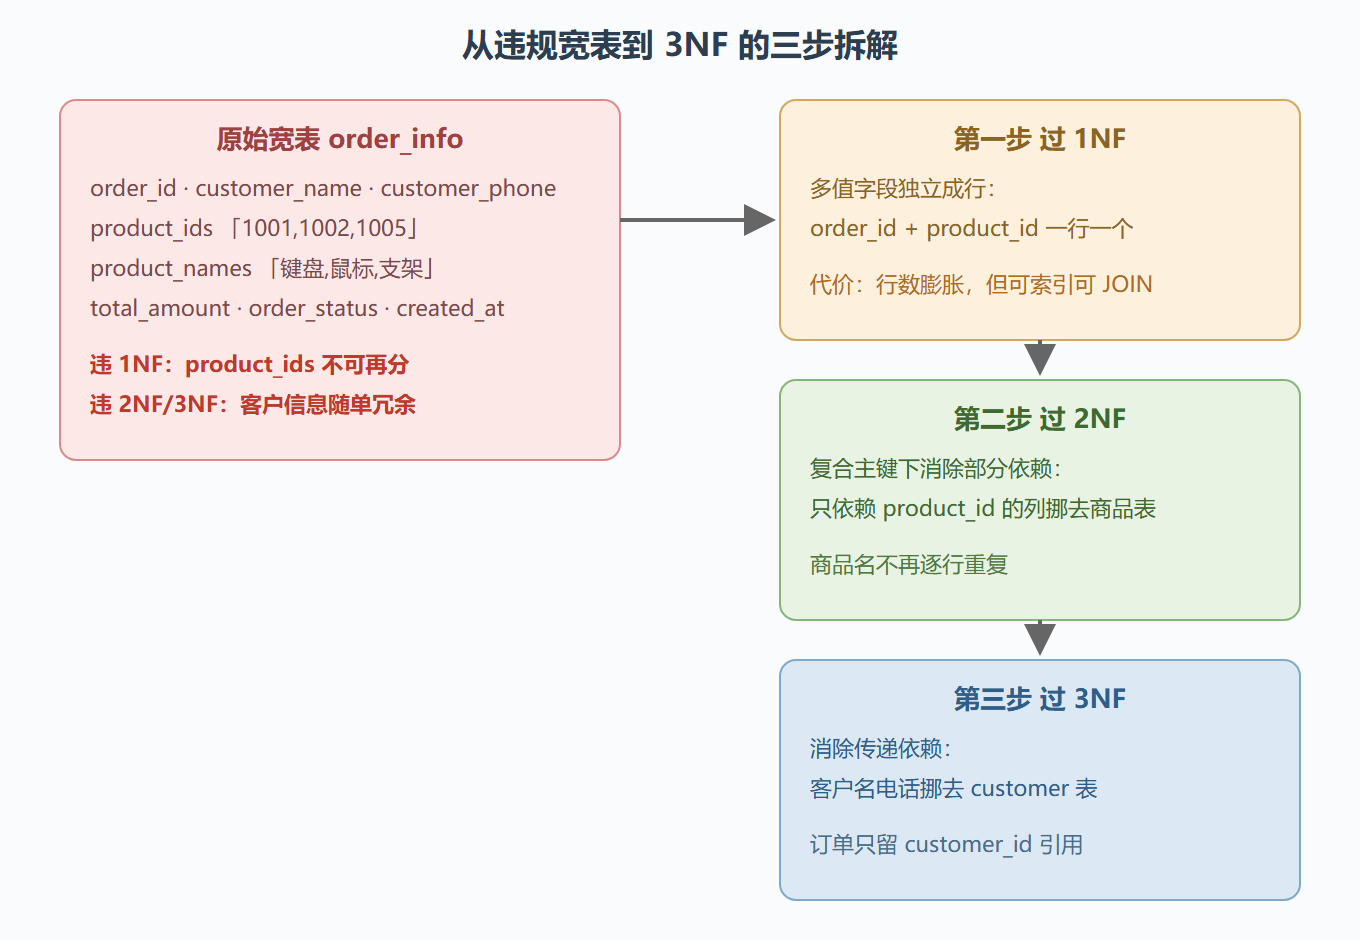
把三步翻译成判定口诀:1NF 看列——每格一个值,逗号串、JSON 数组都是违规;2NF 看复合主键——非主键列是否只依赖主键的一半;3NF 看列与列——非主键列之间是否存在"你变了我也得跟着变"的传递链条(电话依赖客户,不依赖订单,所以不该住在订单表)。多数 OLTP 表设计到 3NF 是合理终点,BCNF 及以上是学术完备性,工程上极少主动追求。
什么时候故意"破格"
范式不是免费的。拆表带来 JOIN:查一份订单要连 order_info、order_item、customer 三张表,在千万级数据和高 QPS 下,JOIN 的成本可能真实到令人肉疼。反范式化的思路由此而来:把最常读、最少改的数据有意冗余回主表,用写时的同步成本换读时的少一条 JOIN。
评审会的一段真实权衡还原——
设计者:"订单列表页要展示客户昵称,我建议订单表加一列 nickname 冗余存储。"
DBA:"昵称会改。改了之后历史订单显示旧昵称,业务上接受吗?"
设计者:"财务和法务那边反而要求历史单据显示当时的昵称,这是合规要求。"
DBA:"那这不是反范式,这是业务快照,合法冗余。记得写入时定格、更新时不回刷。"
这个案例点出反范式的第一判据:冗余的列,业务语义是"当时事实"还是"当前事实"。当时事实(成交价、收货地址、下单昵称)冗余得理直气壮;当前事实(手机号、账户余额)冗余就要回答同步问题。同步策略三选一:事务内双写(强一致,写放大)、异步消息补偿(最终一致,多一个对账任务)、定时校验批刷(容忍窗口期)。选哪个取决于业务能容忍多久的"两张表不一样"。
演练:给订单列表加一个受控冗余字段
背景:列表页高频展示商品标题,JOIN 商品表成为慢查询常客。操作:
ALTER TABLE order_item ADD COLUMN product_title VARCHAR(128) NOT NULL DEFAULT '' COMMENT '下单时标题快照'; -- 写入侧:INSERT order_item 时同时取商品当前标题定格 -- 商品改名时:不回刷 order_item,历史语义保持
结果:列表查询从三表 JOIN 降为两表,P95 延迟从 180ms 降到 60ms 左右(该案例数据量 2000 万行)。解读:这一列的语义是"当时标题",永远不会与现实不一致——这是冗余的最好形态。变式:若要冗余"当前标题",则商品改名必须触发异步更新全部 order_item,那是另一套成本核算,上线前先问数据量有多大。
易错点与评审清单
- JSON 当万能口袋:把易变事实塞进 JSON 字段躲开范式,查询退化为全扫、无法建索引、无法约束。JSON 适合真正的半结构化扩展信息,不适合核心业务事实;
- 无同步机制的反范式:冗余了"当前事实"却没回答"谁负责同步",等于上线一个慢性 bug。评审会必问:同步路径在哪、断了怎么发现;
- 为了省一次 JOIN 过度拆表:把几乎总是一起读写、一对一语义的字段拆成两张表,每次查询多一次 JOIN,得不偿失;
- 把冗余字段建成索引却不查它:只加宽不加索引的冗余列,只是让表更胖。
评审会攻防:范式问题的三连问
第一问:怎么快速判断一张表违反了第几范式? 实战口诀三步走:先扫列值,看到逗号串、JSON 数组、管道分隔,直接 1NF 违规;再看复合主键,非主键列里有没有只跟主键"一半"相关的(比如明细表里的商品名只依赖 product_id),有则 2NF 违规;最后横着看列与列,找出"改 A 必须同步改 B"的传递链(邮编依赖城市、城市依赖客户),有则 3NF 违规。三十秒扫完一张中等宽度的表,这个速度评审会上练得出来。
第二问:JSON 字段算不算违反 1NF? 看内容性质。真正半结构化的扩展信息(第三方回调原文、配置快照)用 JSON 合理,它们没有查询与约束诉求;核心业务事实(订单金额、商品关系)塞 JSON 就是违规——等于把结构化数据降级成文本,索引、约束、JOIN 全部失效。评审会判据一句话:这个字段未来会不会出现在 WHERE 里?会,就不许用 JSON。
第三问:冗余字段要不要建索引? 要分场景。冗余列若只作展示(订单表里的昵称快照),不建索引,白占空间;若参与过滤(订单表里的冗余商户 ID,商户侧查询高频),要建,而且这时它其实是"第二个分片键"级别的存在——冗余列 + 索引的组合本质上是给同一份数据开了第二条访问路径,这是反范式收益最大化的形态。反过来,如果冗余列从不被查询,那这份冗余连存在的理由都没有,删。
要点回顾:三范式是"一份数据一个家"的纪律;1NF 看列、2NF 看部分依赖、3NF 看传递依赖;反范式第一问是"当时事实还是当前事实",第二问是"同步谁负责";JSON 与业务事实的边界看它进不进 WHERE,冗余列与索引要成对评估。表结构就此定型,第 3 章开始往这些表里读写数据。
反范式的四种常用手法与代价清单
反范式不是"随便冗余",它是有名字、有代价、有适用边界的一组手法。评审会上要能叫出名字,才能谈代价。
手法一:冗余字段。把高频读取、低频变更的字段复制到多张表。典型是订单明细里冗余商品名称——商品改名后历史订单显示原名,这恰恰是想要的行为(历史快照语义),不是 bug。代价:源字段变更时要同步刷,漏刷就是数据不一致。
手法二:汇总表 / 计数列。把 COUNT 的结果预先算好存一列,比如商家表上的"在售商品数"。读取从 O(n) 变 O(1)。代价:每次写都要维护计数,且要处理并发下的准确性。
-- 计数列维护的正确姿势:在同事务里用条件更新,避免先查后算的竞态 UPDATE merchant SET on_sale_count = on_sale_count + 1 WHERE id = 1001 AND on_sale_count >= 0; -- 定期校准:用一次全量对账兜底,容忍增量过程中的偶发漂移 UPDATE merchant m JOIN (SELECT merchant_id, COUNT(*) AS c FROM item WHERE status = 'ON_SALE' GROUP BY merchant_id) t ON t.merchant_id = m.id SET m.on_sale_count = t.c;
手法三:宽表。把多个业务实体拍平到一张大表,用一次查询换掉多次 JOIN。常见于报表与分析场景。代价:字段多、行宽大,单行占用缓冲池页多,且任何维度变更都要改表结构。
手法四:历史快照。在写入时把当时的关键维度(下单时的单价、当时的会员等级)固化下来。这是"时间维度上的反范式",让历史数据不再随主数据漂移。
四种手法的共性代价可以归纳成一句话:把读的成本转嫁给了写,并且引入了一致性窗口。评审会上判断能不能接受,看两个数:源字段的变更频率,以及业务能容忍多久的不一致。变更频率低、容忍度高,反范式就划算;反之就是在给自己埋雷。
一个实用的收尾动作:凡是加了冗余字段,就在设计文档里写下三行——冗余了什么、谁负责同步、怎么对账。这三行写不出来,说明这个冗余还没想清楚。