3.4 JOIN 与子查询
3.4 JOIN 与子查询
本节摘要:跨表取数是关系数据库的核心能力。本节用行集合的视角讲清内连、左连、右连到底各取哪部分数据,拆解笛卡尔积陷阱与 NULL 匹配陷阱,最后对比子查询与 JOIN 的改写方法。位置:SQL 家族收尾,直接消费第 2 章的表关系设计,并给第 5 章 JOIN 优化提供语义基础。
先分清你要哪部分行
评审会上看到一个高频困惑:同样查"订单和客户",内连和左连结果行数不同,为什么?本质是两者圈定的行集合不同。用两张小表把这件事彻底讲明白——customer 有 3 行(客户 1、2、3),orders 有 3 行(订单 A 属于客户 1,订单 B 属于客户 2,订单 C 属于客户 99,即不存在客户的脏数据)。
图 6 · 各类 JOIN 的行集合示意图
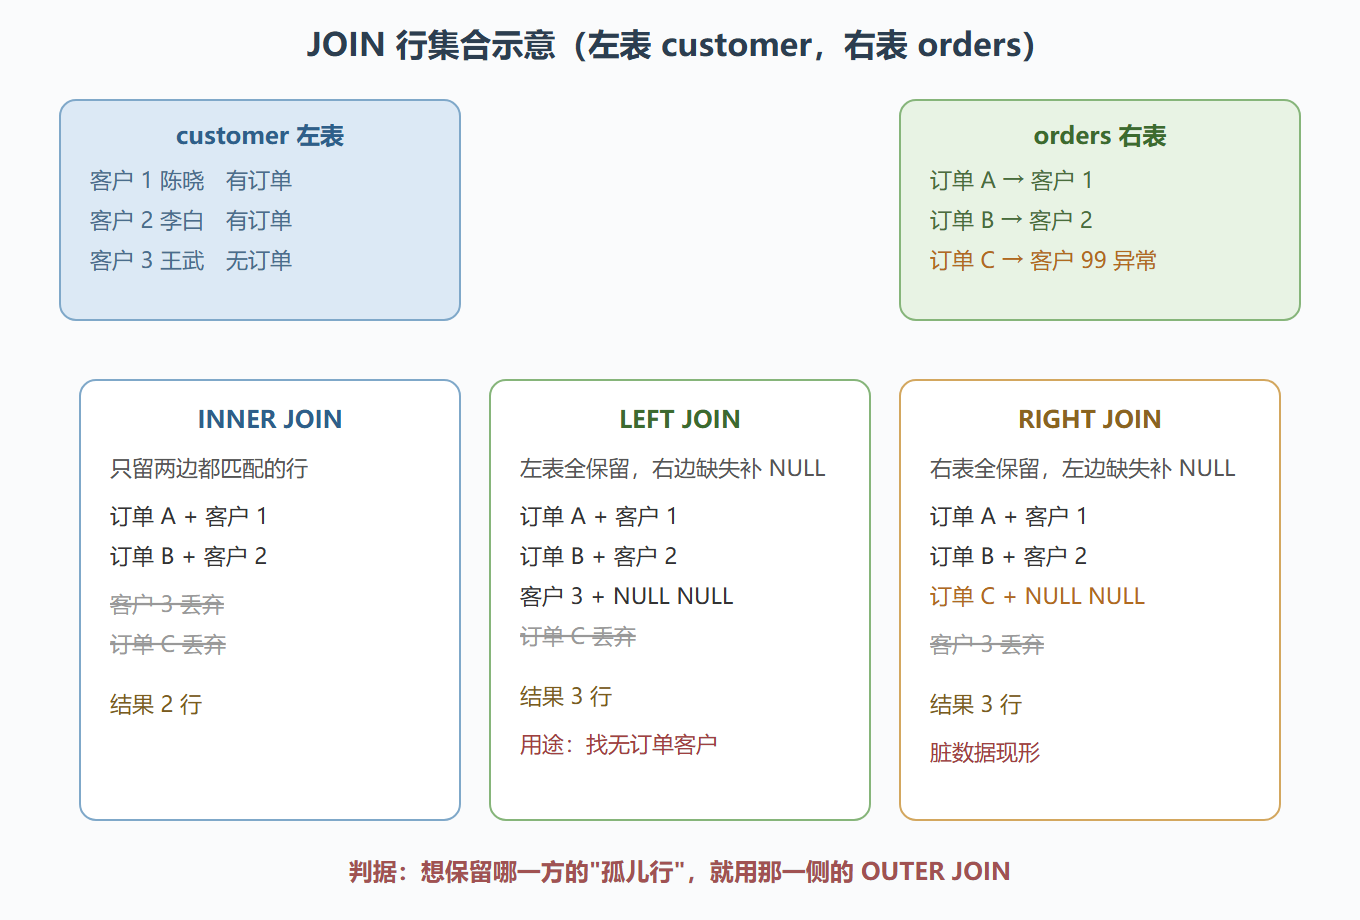
SQL 对应如下:
SELECT o.order_id, c.name FROM orders o INNER JOIN customer c ON o.customer_id = c.customer_id; -- 结果 2 行,订单 C 与客户 3 都不出现在结果里 SELECT c.customer_id, c.name, o.order_id FROM customer c LEFT JOIN orders o ON o.customer_id = c.customer_id; -- 结果 3 行,客户 3 的 order_id 为 NULL SELECT c.customer_id, c.name FROM customer c LEFT JOIN orders o ON o.customer_id = c.customer_id WHERE o.order_id IS NULL; -- 反连接:只返回从没下过单的客户 3
解读:左连加 IS NULL 过滤是"反连接"惯用法,找"没有下单的客户、没被领取的优惠券、没有映射的编码"全靠它。第三段查询同时暴露了脏数据的用法——把方向换成从 orders 左连 customer,订单 C 就会带着 NULL 客户信息现形。LEFT JOIN 的价值常常不在补 NULL,而在"谁没有对应关系"这类存在性判断。
子查询:两种执行方式与改写
子查询分两类。非相关子查询只执行一次、结果当常量用:WHERE customer_id IN (SELECT customer_id FROM vip)。相关子查询引用外层行,理论上外层每一行都要算一遍:WHERE EXISTS (SELECT 1 FROM orders o WHERE o.customer_id = c.customer_id)——别被"每行都执行"吓到,优化器通常能把 EXISTS 转成半连接,效率不差。
真正容易出事的是 IN 里塞大子查询的历史行为(老版本可能物化整表),以及 SELECT 列表里的标量子查询逐行执行。改写经验:
-- 写法一:标量子查询,外层每行触发一次取价 SELECT oi.order_id, (SELECT title FROM product p WHERE p.product_id = oi.product_id) AS title FROM order_item oi; -- 写法二:改 JOIN,一次连接完成 SELECT oi.order_id, p.title FROM order_item oi JOIN product p ON p.product_id = oi.product_id;
两种写法结果一致,但写法二更利于优化器选择连接顺序与索引(第 5 章 EXPLAIN 验证)。我的习惯:取列用 JOIN,做存在性判断用 EXISTS,IN 子查询仅在结果集确定很小时使用。
易错点与评审清单
- 忘写连接条件的逗号连接:
FROM a, b不带 WHERE 就是笛卡尔积,两表各一万行立刻产出 1 亿行,内存与 IO 双爆; - LEFT JOIN 后又用 WHERE 过滤右表:
LEFT JOIN b ... WHERE b.type = 1会把右表为 NULL 的左表行也过滤掉,LEFT JOIN 悄悄变成 INNER JOIN。右表条件应写在 ON 里; - JOIN 列类型或字符集不一致:一侧 BIGINT 一侧 INT、一侧 utf8mb4 一侧 latin1,索引用不上,连接退化为逐行比对;
- 一行变多行的隐形放大:一对多连接后对"宽表"做 SUM,数字被重复计数翻倍——先聚合子表再连,或明确用 DISTINCT。
进阶:连接在引擎里怎么跑
评审会的隐藏考点是"JOIN 的执行算法"。InnoDB 时代的主力是嵌套循环连接(Nested Loop Join):外层表取一行,拿连接键去内层表查一次。它的性能命门在于"去内层查一次"的成本——内层连接键有索引,每次是一次索引查找,一切安好;没索引,内层退化成全表扫描乘以外层行数,灾难现场。8.0.18 引入了 Hash Join 处理无索引可用的大表连接:把小表构建成内存哈希表,大表逐行探测,成本从"N 乘 M"降到"N 加 M",无索引连接从不可用变成可接受。EXPLAIN 里看到 hash join 字样,说明优化器在告诉你"这个连接没吃到索引,我用哈希兜底了"——能用,但更该问一句为什么没建索引。
驱动表谁说了算? 不是 SQL 里 FROM 的书写顺序。优化器按成本选驱动表,惯例是小结果集驱动大结果集,但"小"是过滤后的估算行数不是表的物理大小。理解这一点就能看懂第 5 章的执行计划:JOIN 顺序在你和优化器之间,最终解释权归优化器,你能做的是把两边的索引都建对,让它怎么选都有好路。
演练:亲眼对比有索引与无索引的连接
背景:验证连接键索引对算法选择的影响。操作:
-- 临时禁用 product 主键的想法不可行,改用一张无索引的影子表 CREATE TABLE product_noidx AS SELECT * FROM product; -- 影子表不带主键与索引 EXPLAIN SELECT oi.order_id, p.title FROM order_item oi JOIN product_noidx p ON p.product_id = oi.product_id; -- 8.0 输出:access type 为 hash join(无索引兜底) EXPLAIN SELECT oi.order_id, p.title FROM order_item oi JOIN product p ON p.product_id = oi.product_id; -- 输出:p 表 type 为 eq_ref,走主键索引查找
结果:两条语句结果一致,执行耗时在十万行量级差出一个数量级。解读:Hash Join 是兜底不是替身——它救得了偶发的无索引连接,救不了常态化的连接设计失误。清理演示表:DROP TABLE product_noidx;。变式:验证连接键类型不一致的效果,把影子表的 product_id 改成 VARCHAR 再连一次,观察索引直接失效——这就是 3.4 易错清单里那条的实证。
要点回顾:内连取交集、外连保孤儿、反连接找"没有";相关子查询未必慢,标量子查询常拖累;右表条件写 ON 不写 WHERE;连接前确认列类型与字符集一致;Hash Join 是无索引时的兜底,别把兜底当常态。SQL 的武器库到此齐备,第 4 章开始解决"查询为什么慢"的第一把钥匙——索引。