4.1 索引原理与创建管理
4.1 索引原理与创建管理
本节摘要:索引快是因为它是一棵精心设计的 B+ 树:节点对齐磁盘页、树高极矮、叶子层串成有序链表。本节从"为什么不用更简单的结构"推演出 B+ 树的必然性,讲清页分裂的代价,再过一遍索引的创建与管理语法。位置:第 4 章的地基,后面三节全部建立在这棵树上。
为什么偏偏是 B+ 树
评审会问新人:"为什么索引不用哈希表?"答:"因为哈希不支持范围查询。"追问:"那不用哈希,用有序数组加二分查找不行吗?"——这就问到根上了。有序数组查询确实快,但插入要在中间挪动全部后续元素,每次写都伤筋动骨;链表插入快,但没法二分。数据库需要一种查询像数组、修改像链表的结构,树形结构两者兼顾,而 B+ 树是经过磁盘 IO 特化的那一种。
特化的关键在"矮"。磁盘 IO 以页为单位(InnoDB 页 16 KB),一次 IO 读整页,读 100 字节和读 16 KB 成本几乎一样,所以减少 IO 次数比减少读取字节数重要得多。B+ 树把每个节点做成一个页:非叶子节点只放键和指针,一个 16 KB 页能塞约 1200 个指针(假设主键 BIGINT 8 字节加页内指针 6 字节再留余量);叶子节点放数据,一页能存约 15 行订单记录(假设每行 1 KB)。于是三层的 B+ 树能容纳 1200 × 1200 × 15 ≈ 2160 万行,而查任何一行最多 3 次 IO——根节点还常驻缓冲池,实际往往只需 1 到 2 次。这就是"两千万行的表,索引查询毫秒级"的物理原因。
图 7 · B+ 树索引结构与一次查询路径
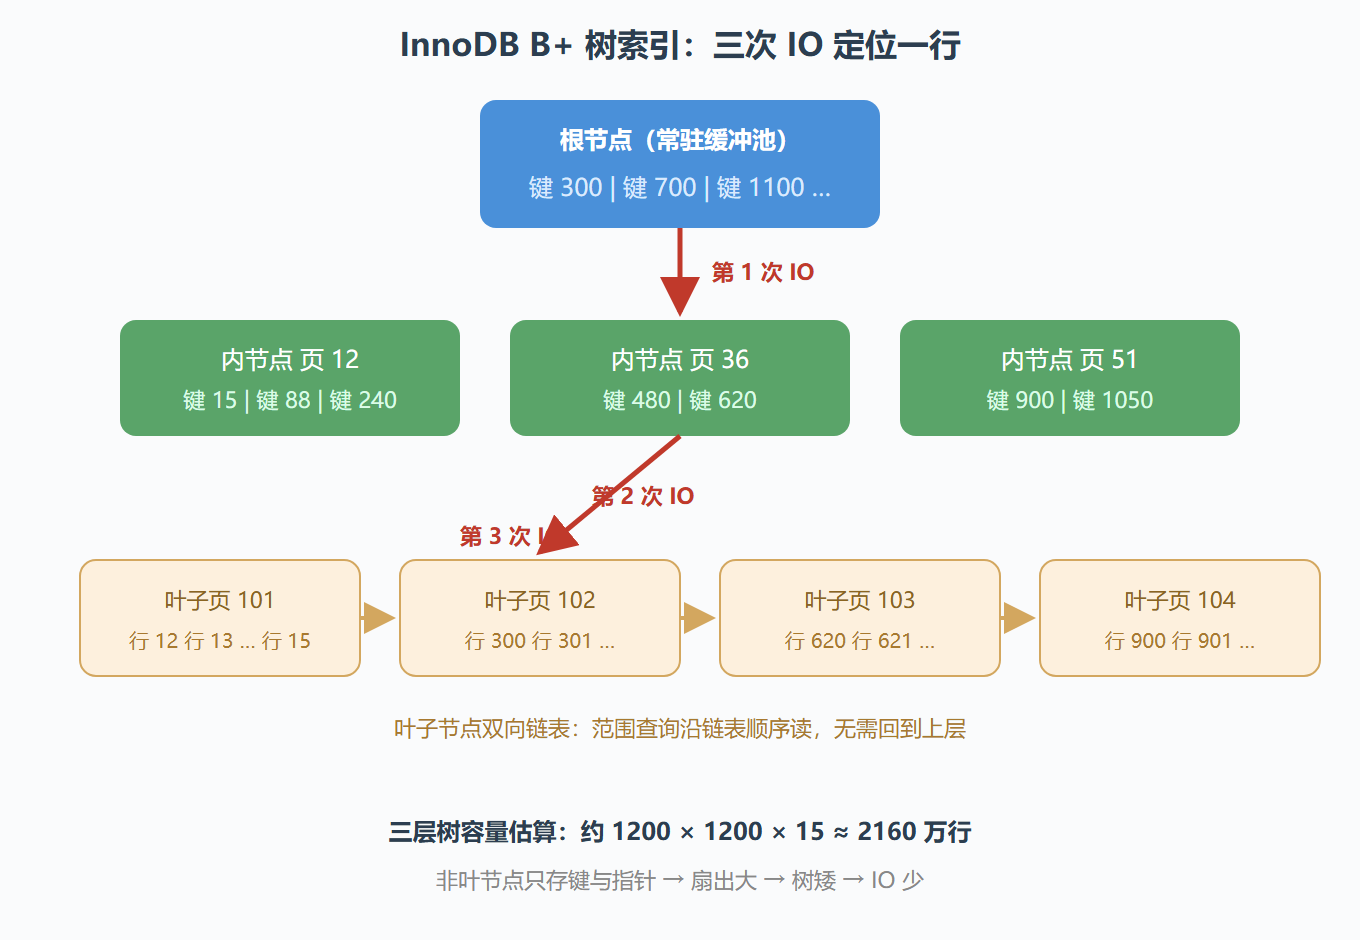
范围查询为什么快,也在这张图里:叶子层是有序双向链表,WHERE order_id BETWEEN 300 AND 500 先二分定位到起点,然后沿链表顺序扫,不碰无关子树。
页分裂:写入抖动的真凶
叶子页按主键顺序存数据。用自增主键时,新行总追加到最右侧叶子,写满开新页,天然顺序写。但如果主键是随机的(UUID、雪花打乱版),新行会插进中间的某个页:页满则分裂成两半,约一半数据要搬家,上层节点同步调整。这就是"随机主键写入性能差"的物理解释——评审会上有人提议用 UUID 当主键时,把这段讲给他听。
顺带回答一个常见困惑:为什么强烈不建议无主键建表?InnoDB 聚簇索引要求必须有主键,你没有定义它会找第一个 NOT NULL UNIQUE 列顶替,再没有就生成隐藏的行号列——数据物理组织的控制权拱手让人,且后续想加回自增主键等于重建整表。
创建与管理的工程语法
-- 普通二级索引 CREATE INDEX idx_status_created ON orders (status, created_at); -- 唯一索引:业务唯一性的数据库保险 CREATE UNIQUE INDEX uk_phone ON customer (phone); -- 前缀索引:长字符串只索引前 N 位,省空间 CREATE INDEX idx_title_pre ON product (title(20)); -- 函数索引:8.0 支持,免去"函数包列导致失效"的尴尬 CREATE INDEX idx_created_date ON orders ((DATE(created_at))); -- 不可见索引:先让优化器"看不见",验证无副作用后再删 ALTER TABLE orders ALTER INDEX idx_status_created INVISIBLE; -- 观察 48 小时无异常 DROP INDEX idx_status_created ON orders;
前缀索引的 N 怎么定?用选择性判断:SELECT COUNT(DISTINCT LEFT(title, 20)) / COUNT(*) FROM product,比值越接近 1 越好,同时 N 越小索引越省。不可见索引是清理冗余索引的安全姿势——直接删了如果某条老报表 SQL 靠它吃饭,回滚就是再建一次(大表重建索引很贵),先 INVISIBLE 一段时间是低风险验证。
易错点与评审清单
- 索引越多越好:每个二级索引都是一棵要维护的树,INSERT/UPDATE/DELETE 都要同步改所有相关树;一张表的索引个数保持在个位数是健康线;
- 给低选择性列单独建索引:status 只有三个取值,单独索引过滤性差,优化器多半不用;要配和 created_at 之类组成复合索引才有价值;
- 只在建表时建索引:索引应跟着真实查询模式长出来,上线三个月后回头审一次"建了没人用的索引"和"高频查询没索引"两个错配;
- 主键随意选业务字段:手机号会换、身份证号敏感,主键选择回到 1.1 节的三标准:稳定、短小、无业务含义。
评审追问集:树结构的三个深水问题
追问一:索引下推是什么? ICP(Index Condition Pushdown)是 5.6 引入的优化。复合索引 (name, age) 上查询 WHERE name LIKE '陈%' AND age = 25:没有 ICP 时,引擎从索引取出所有"陈姓"条目回表,再由服务层过滤年龄;有 ICP 时,年龄判断下推到引擎层,先在索引里过掉年龄不符的条目,只回表真正命中的行。回表次数骤减。EXPLAIN 的 Extra 显示 Using index condition 即为生效,5.6 以上默认开启。
追问二:表"有空洞"是怎么回事? 频繁删除与页分裂会让叶子页出现填充率不足的碎片,数据量没变,树却"虚胖"了,扫描 IO 变多。诊断看数据长度与索引长度的比值变化,治疗手段是重建:8.0 用 OPTIMIZE TABLE(在线,会短暂锁表并重建),或借助在线改表工具重建整表。这是"只删数据不回收空间"的经典答疑点——DELETE 不释放磁盘页,重建才回收。
追问三:为什么自增主键有时也会页分裂? 自增保证的是"新行追加到最右",但批量插入乱序 ID(应用层自己生成雪花 ID 但时钟回拨)或删除后复用页空间,仍可能触发中间插入。更隐蔽的是自增值到达上限前的"回绕"风险——BIGINT 也终有尽时,评估自增上限是容量规划的一部分:按当前增长速率算还剩几年,提前预案比临时扩列(必须重建表)从容得多。
要点回顾:B+ 树的矮来自大扇出,IO 次数决定查询速度;自增主键让写入顺序化,随机主键引发页分裂;前缀索引权衡空间与选择性;不可见索引提供安全的清理路径;ICP 减少回表、碎片靠重建回收、自增上限要进容量规划。索引的家底摸清了,下一节看它有哪些具体形态。