5.1 EXPLAIN 语句分析
5.1 EXPLAIN 语句分析
本节摘要:EXPLAIN 让 MySQL 说出它打算怎么执行你的 SQL:走哪条路径、用哪个索引、扫多少行。本节逐字段解读输出,重点建立 type 等级刻度与 Extra 信号词两套读法。位置:第 5 章的诊断工具总纲,后续所有优化论证都以它的输出为证据。
病历先于处方
评审会性能环节有个固定开场:把核心接口的 SQL 各跑一次 EXPLAIN,投屏。有一次投出这样一段——type: ALL,rows: 2000 万,key: NULL。开发辩解"表里有索引",DBA 回答"索引是索引,用不用是优化器的决定,EXPLAIN 就是把这个决定给你看"。这句话是本节的定位:EXPLAIN 是优化器和你的对话记录,学会读它,优化就从猜变成证。
用法本身简单,重点在解读。注意两个实用变体:EXPLAIN FORMAT=JSON 给出更细的成本估算(cost_info),EXPLAIN ANALYZE(8.0.18 起)真的执行并返回每步的实际耗时和行数,估算与实际的偏差一目了然——统计信息失真问题(4.4 场景八)靠它抓现行。
逐字段解读
一张 EXPLAIN 输出十来列,日常盯五个就够。
id 与 select_type:id 相同表示同一批执行(如一次 JOIN),不同则序号大的先执行(子查询);select_type 标明 SIMPLE(无子查询)、PRIMARY(最外层)、SUBQUERY、DERIVED(派生表)等。复杂 SQL 先看 id 分组,理清执行层次。
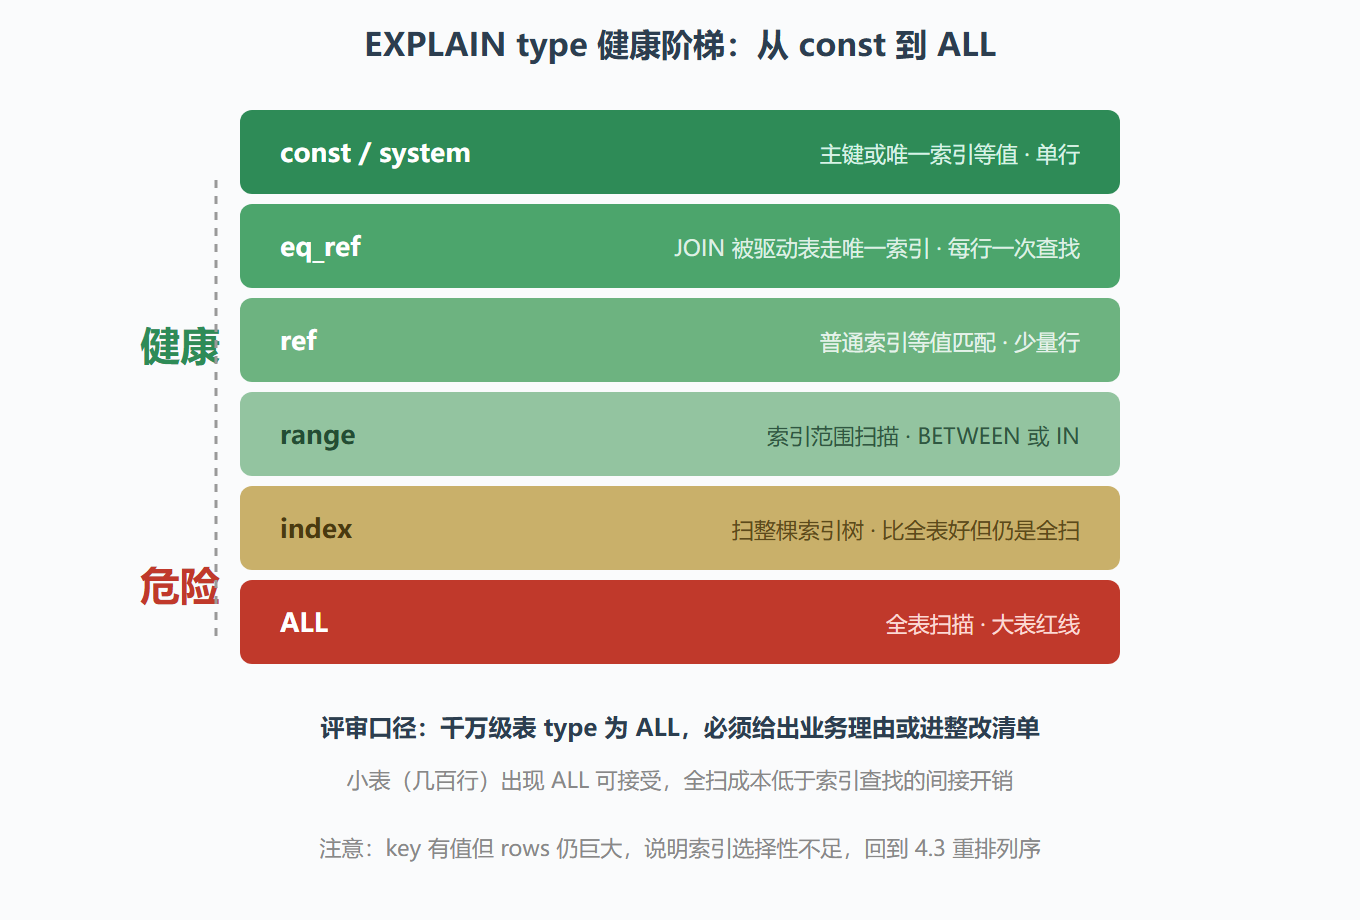
type:健康刻度。从好到坏:system > const > eq_ref > ref > range > index > ALL。const 是主键或唯一索引等值(最多一行);eq_ref 是 JOIN 时被驱动表走主键或唯一索引(每行至多一次查找,理想形态);ref 是普通二级索引等值;range 是索引范围扫描;index 是扫整棵索引树(比 ALL 好在索引通常更小,但本质仍是全扫);ALL 是全表扫描。大表出现 ALL 或 index 都要给理由。
key 与 possible_keys:后者是候选索引,前者是实际选中的。两者都有值但 key 为 NULL,说明优化器评估后认为不走更划算——回查 4.4 根源三。key_len 告诉你复合索引用了几列,长度骤减往往意味着后段列没吃上(前缀断链或范围截断)。
rows 与 filtered:rows 是估算扫描行数,优化器成本模型的核心变量;filtered 是估算经 WHERE 过滤后剩下的百分比。两者相乘才是预计的"有效行数",rows 很大而 filtered 很低,常常意味着索引选择性与查询条件不匹配。
图 9 · EXPLAIN type 健康阶梯
Extra:信号词集散地。高频词四连:Using index 覆盖索引生效,好信号;Using index condition 索引条件下推,正常;Using filesort 排序没吃到索引,5.3 的病灶;Using temporary 建了临时表(常见于 GROUP BY、DISTINCT),另一个病灶。
演练:给一份执行计划写诊断书
背景:库存报表 SQL 被投诉慢。操作:
EXPLAIN SELECT w.name, SUM(i.stock) FROM inventory i JOIN warehouse w ON w.warehouse_id = i.warehouse_id WHERE i.updated_at > '2026-08-01' GROUP BY w.name; -- 关键输出:id=1 均同组;i 表 type=ALL rows=8000万;w 表 type=eq_ref -- Extra(i 表):Using where; Using temporary; Using filesort
诊断书三行写完:一、i 表全表扫,updated_at 无索引——加 idx_updated;二、GROUP BY 按 w.name 分组导致临时表——改为按 w.warehouse_id 分组后前端再做名称映射,或接受临时表但先解决全表扫;三、filesort 是分组聚合的伴生症状,第一项解决后再评估。结果:加索引后 rows 降到 40 万,接口从 12 秒到 800ms。解读:诊断书的价值在归因顺序——先消灭最大成本项(扫描行数),再处理次要项,一次改一件事、跑一次 EXPLAIN 验证,避免多处同时改导致归因混乱。
易错点与评审清单
- 把 EXPLAIN 当唯一真相:rows 是估算不是实测,统计失真时估算会撒谎,必要时用 EXPLAIN ANALYZE 交叉验证;
- 只看单表计划:JOIN 计划要看驱动顺序,驱动表选错(大表驱动小表)会让被驱动表重复扫描,关注 id 分组里谁先执行;
- 在小表上过度优化:几百行的配置表 ALL 一下无所谓,别为它建一堆索引交写入税;
- 改完不复测:任何优化动作后必须重跑 EXPLAIN 对比 rows 与 type,口头说"应该快了"不算数。
要点回顾:EXPLAIN 是优化器的决定书,五字段五读法;type 刻度是健康分,大表 ALL 红线;key 为 NULL 先查成本再查写法;Extra 信号词按图索骥;一次只改一件事,改完必复测。工具在手,下一节看 WHERE 与写法层的专项病灶。
一次完整的 EXPLAIN 判读演练
看一条真实语句的执行计划,逐字段拆开读。
EXPLAIN SELECT o.id, o.total_amount, u.nickname FROM orders o JOIN user u ON u.id = o.customer_id WHERE o.status = 'PAID' AND o.created_at >= '2026-08-01' ORDER BY o.created_at DESC LIMIT 20;
假想输出(两行,orders 为驱动表):
| id | select_type | table | type | possible_keys | key | rows | filtered | Extra |
|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | o | range | idx_status_created | idx_status_created | 48210 | 100 | Using index condition; Using filesort |
| 1 | SIMPLE | u | eq_ref | PRIMARY | PRIMARY | 1 | 100 | NULL |
判读顺序建议固定成下面五步,形成肌肉记忆:
- 看 type:orders 是 range(索引范围扫描),user 是 eq_ref(主键等值,最优)。若 orders 这里是 ALL,第一步就该问 status 与 created_at 有没有联合索引;
- 看 key 与 possible_keys:实际用到的 key 是否在候选里、是否与预期一致。若 key 为 NULL 而 possible_keys 有值,多半是优化器基于成本估算放弃索引(常见于命中行数占比过高的低选择性条件);
- 看 rows:48210 是预估扫描行数,不是返回行数。它决定了这条语句的成本量级——配合 filtered 看,实际流向上一层的行数约等于 rows 乘以 filtered 百分比;
- 看 Extra:Using index condition 表示走了索引下推,能在存储引擎层提前过滤;Using filesort 表示有排序代价。这里排序来自
ORDER BY o.created_at DESC,而索引是(status, created_at),在 status 为等值时 created_at 有序,本不该 filesort——出现 filesort 说明优化器没有选择预期的索引路径,或排序方向混用(部分 DESC 部分 ASC); - 回头看 LIMIT:LIMIT 20 意味着排序可能只需维护一个小顶堆,filesort 的实际开销未必如数字吓人。判定要不要优化,看的是慢日志里的实际耗时,不是执行计划里的词。
针对这条语句的两种改法:其一,让索引与查询完全对齐,建 (status, created_at, customer_id),覆盖 o 侧全部需要的列,消除回表;其二,若业务允许,改成按主键游标翻页(记录上一页最后的 id 与 created_at,用范围条件接续),把深翻页的代价从"扫过并丢弃"降为"直接定位"。
判读的终点不是背下每个字段的含义,而是能回答三个问题:扫了多少、回表多少次、排序在哪发生。答得上来,优化方向就定了。