第1章 自然语言处理(NLP)基础
第1章 · 自然语言处理(NLP)基础
章节摘要:机器为什么读不懂"我想查快递"这么简单的一句话?本章从语言的歧义性与计算机的数值本性这对矛盾出发,讲清 NLP 的处理链条:先把杂乱文本洗干净(预处理),再把词语变成向量(表示),然后用深度学习模型捕捉序列规律。读完你能判断一个 NLP 任务的难度层级,并为第2、3章的应用场景打好地基。
先说结论
阅读完本章,你应当能够:
- 解释分词、词性标注、命名实体识别各自解决什么问题,以及它们为什么是中文 NLP 的第一道坎;
- 对比独热编码、TF-IDF、静态词向量、上下文词向量四代文本表示方法的优劣与适用场景;
- 说清 Word2Vec 的 CBOW 与 Skip-gram 两种训练模式的差别,以及 FastText 为何能对付拼写错误;
- 解释 RNN 的梯度消失问题,以及 LSTM、GRU、注意力机制分别如何缓解它;
- 把一个具体业务需求(如工单分类、评论摘要)拆解成对应的 NLP 任务组合。
核心概念速览
语言是符号,数学要数值——NLP 的全部历史,就是把这句话的鸿沟一点点填平的历史。
从符号到向量:表示方法演进
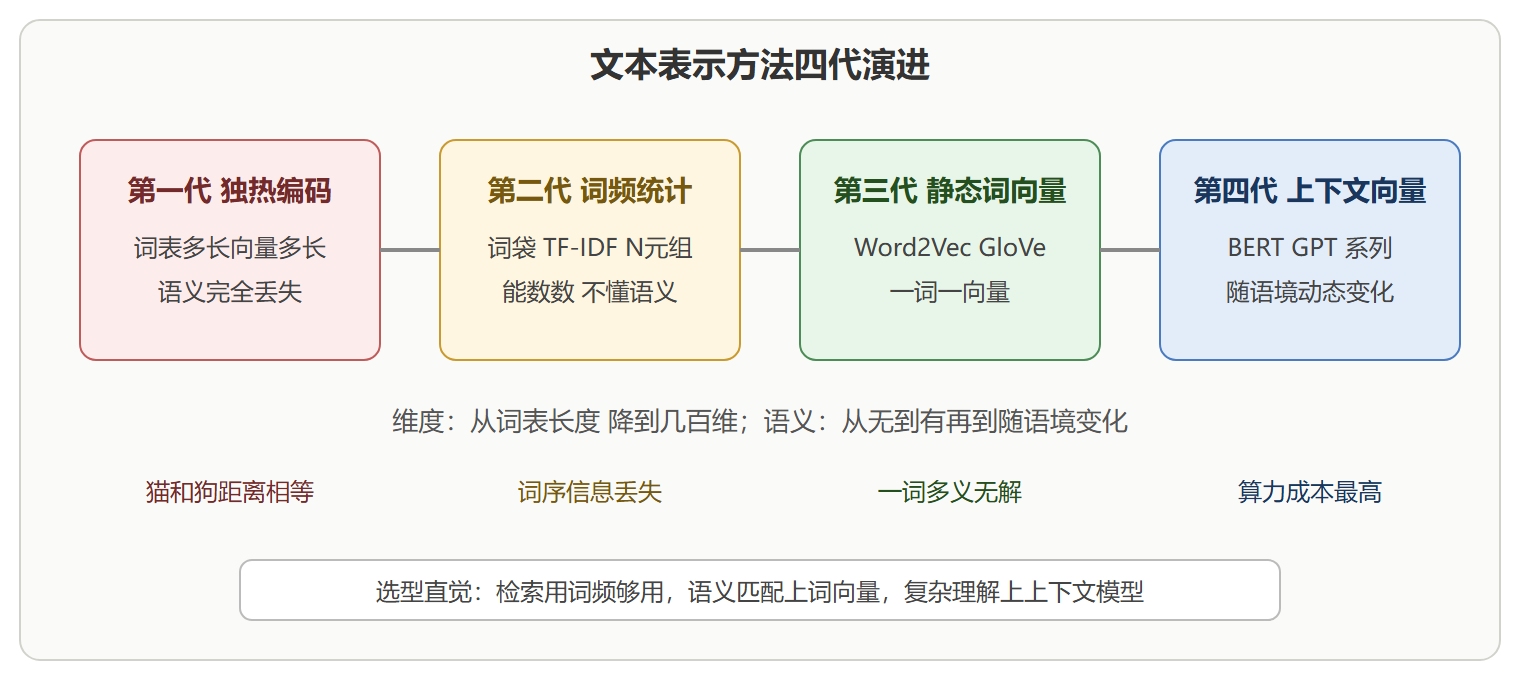
本章的知识地图有一条暗线:从「语言是什么」(符号与意义)到「机器怎么读」(分词、表征)再到「机器怎么做」(任务与评估),三步分别对应语言学视角、表示学习视角、工程视角。只学第一步容易变成概念清谈,只学第三步容易沦为调包侠,三步连起来才是完整的 NLP 入门。给读者的建议是把 1.2 与 1.3 两节当作全书的地基工程,宁可慢一点也要动手跑通从原始文本到特征矩阵的完整链路——后面所有应用章节,无非是在这条链路的两端换上不同的任务外壳。
子章节导航
1.1 NLP是什么:从一次答非所问说起
回答"NLP 到底在做什么"这个元问题。以一次真实的客服误判为线索,介绍语言理解与语言生成两大目标,梳理 NLP 面临的五类挑战——歧义、上下文依赖、语言动态变化、数据稀疏、常识推理缺失——并给出预处理、表示、句法语义分析、生成这条处理链的全景。
1.2 文本预处理与特征工程
机器读到的第一手文本有多脏:网页标签、表情符号、错别字、中英混杂。本节讲清洗流程、子词切分(BPE、WordPiece、SentencePiece)、停用词取舍、词干提取与词形还原的区别,以及稀疏表示(词袋、TF-IDF、N元组)与稠密表示的工程选择。
1.3 词向量与深度学习基础
NLP 的"任督二脉"。讲分布式假设、CBOW 与 Skip-gram、GloVe 的全局统计、FastText 的字符级技巧,再进入神经网络:从梯度消失讲到 LSTM 的三门设计、GRU 的简化、注意力机制的引入。
1.4 常用NLP任务与算法
把前面学到的零件组装成八类常用任务:文本分类、命名实体识别、语义匹配、文本摘要、自然语言生成、问答、序列标注。每个任务给出"输入—输出—代表算法—典型坑"四要素速查。
子章节之间的逻辑关系
观点先行:1.1 定问题,1.2 治输入,1.3 造零件,1.4 组整机——四章环环相扣,跳读容易断链。
┌──────────┐ ┌──────────────┐ ┌──────────────┐ ┌──────────────┐ │ 1.1 定问题 │ → │ 1.2 治理输入 │ → │ 1.3 表示与模型 │ → │ 1.4 任务组装 │ │ 歧义在哪 │ │ 文本洗洗干净 │ │ 向量+深度学习 │ │ 分类/抽取/生成│ └──────────┘ └──────────────┘ └──────────────┘ └──────────────┘ ↓ ↓ 第2章 智能客服 第3章 内容分析
1.2 的清洗质量直接决定 1.3 训练出的词向量好不好;1.3 的表示方法决定 1.4 里每个任务能达到的精度上限;而 1.4 的任务清单,正是第2、3章应用场景的原料库。
前置知识与后续延伸
- 前置:高中程度的统计概念(频率、概率)即可;涉及矩阵的地方会用文字描述直觉。
- 为后续铺垫:第2章的意图识别直接复用 1.4 的分类算法;第3章的主题模型建立在 1.2 的向量表示之上;第4章的大语言模型则是 1.3 注意力机制的放大版。
- 建议配一张速查表:把四代表示方法、四类模型(FFNN、RNN/LSTM、CNN、Transformer)各画一列,随读随填——本章结束时应能徒手画出这张表。
💡 学习心法:每遇到一个算法,先问"它解决的是上一代方法的哪个具体毛病"。梯度消失之于 RNN、上下文向量之于一词多义,都是被逼出来的。记住问题,算法自然记得住。
常见问题
学 NLP 一定要先学深度学习吗
不必。很多生产系统至今仍在用 TF-IDF 加朴素贝叶斯跑工单分类,效果够用、成本极低。建议的路径是先掌握统计方法,能解决八成常规问题,再在语义复杂度高的场景(同义问法识别、讽刺识别)引入深度学习。带着具体问题去学模型,比先啃三个月理论有效得多。
中文 NLP 和英文 NLP 差别大吗
主要差在第一步:英文有空格,中文要分词。"我想查快递"切成"我/想/查/快递"还是"我想/查/快递",直接影响后续所有环节。此外中文没有词形变化,词性标注和词形还原的压力小,但歧义和新词(网络用语、产品黑话)压力更大——客服场景里,用户一天就能造出一个训练集里从没出现过的新说法。所以第1章第2节会花不少篇幅在中文特有的预处理坑上。