1.1 NLP是什么:从一次答非所问说起
1.1 NLP是什么:从一次答非所问说起
本节摘要:自然语言处理(NLP)是让计算机理解、处理并生成人类语言的技术,分为语言理解(NLU)与语言生成(NLG)两大方向。本节从一个真实的客服误判出发,拆解机器"读不懂"人话的五个根源——歧义、上下文依赖、语言演化、数据稀疏、常识缺失——并给出从文本预处理到语义分析再到生成的完整处理链地图,为后续各节定位坐标。
学习目标
阅读完本节,你应当能够:
- 用一句话向非技术同事解释 NLP、NLU、NLG 三者的关系;
- 举出至少三类语言歧义的实例,并说明它们各自会让什么任务出错;
- 复述 NLP 处理链的五个环节及各环节的输入输出;
- 判断一个具体业务故障属于处理链的哪一环。
一、一次昂贵的误判
某零售企业的客服后台曾记录过这样一段对话。用户输入:"苹果怎么还不能发货?"系统检索关键词"苹果",匹配到水果保养类知识条目,回复了一大段"生鲜商品发货时效说明"。用户实际上问的是刚发布的苹果手机。三轮鸡同鸭讲之后,用户撂下一句"转人工"离开了。
事后看,这句查询的每一个字系统都"认识",但整句话它没懂。问题出在哪?拆开看至少有三层。第一层是词义歧义:"苹果"在水果和公司两个义项间摇摆,单看这个词无法裁决。第二层是上下文依赖:这位用户的历史订单里躺着一台未发货的手机,语境信息明明存在,系统却没用。第三层是常识缺失:任何有生活经验的人都会默认,在电商客服里问"苹果发货",多半说的是手机而不是水果——机器没有这份默认。
这个案例几乎浓缩了 NLP 的全部难处。自然语言处理,作为人工智能、计算机科学和语言学交叉的学科,目标是让机器理解、解释、处理和生成人类语言;它拆成两个方向:语言理解负责把人话翻译成机器可操作的结构,语言生成负责把机器的结构翻译回人话。智能客服的"听懂"和"回答",分别压在这两条腿上。一次答非所问,往往是理解那条腿先瘸了。
二、机器读不懂人话的五个根源
把上面案例的病灶一般化,NLP 的困难可以归为五类。理解这五类,比记住十个算法名词更有用——因为后面所有章节的技术,都是在逐个攻克它们。
**第一是歧义。**词汇层面,"苹果"是水果还是公司;句法层面,"咬死了猎人的狗"可以是一只狗,也可以是一个惨烈的场景;语义层面,"这手机真行"在讽刺语境里是差评。歧义的麻烦在于:人类靠语境瞬间消解,机器却要为每种可能都算一遍概率。
**第二是上下文依赖。**用户先问"iPhone 15 Pro Max 多少钱",接着问"它的电池耐用吗"——"它"指什么,人一望即知,机器必须维护对话历史才能解析。上下文一长、话题一切换,"记住前面说过什么"就成了硬仗。
**第三是语言的动态性。**网络新词、缩写、错别字源源不断。训练数据里没有"绝绝子",模型就当它不存在;用户打成"查订葱",精确匹配直接失败。客服场景尤甚:用户不会按训练集的分布说话。
**第四是数据稀疏。**低频意图、小语种、专业领域(比如某个工业品型号的故障描述),标注样本少得可怜。模型在这些长尾区域的表现会断崖式下跌。
第五是常识与推理缺失。"退货运费谁出"背后牵扯运费险规则,"周五前能到吗"需要模型知道今天星期几、默认物流时效几天。语言之外的世界知识,恰恰是最难得的。
五个根源还会叠加放大。一条满是错别字、带着反讽的长句,同时触发动态性、歧义、上下文依赖三重困难;而客服大促场景恰恰批量生产这种句子。这也是为什么真实的工业系统很少只靠单一模型硬扛,而是分层设防:预处理挡住脏数据,句法分析提供骨架线索,语义模型做主判断,规则与知识库做兜底。理解了困难的复合性,就理解了后面章节里"为什么不直接上最强的模型"这个反复出现的疑问——强模型也扛不住复合错误,防线要修在多个环节上。
| 困难根源 | 典型症状 | 主要受害任务 | 对应技术方向 |
|---|---|---|---|
| 歧义 | 苹果=水果还是手机 | 意图识别、实体识别 | 上下文词向量、知识图谱 |
| 上下文依赖 | 代词"它"指向不明 | 多轮对话、摘要 | 对话状态追踪、长序列模型 |
| 语言动态性 | 新词、错别字识别失败 | 所有理解类任务 | 子词切分、字符级模型 |
| 数据稀疏 | 长尾意图命中率低 | 分类、抽取 | 预训练与迁移学习 |
| 常识缺失 | 回答违背生活常理 | 问答、生成 | 大模型、知识注入 |
三、NLP 处理链全景
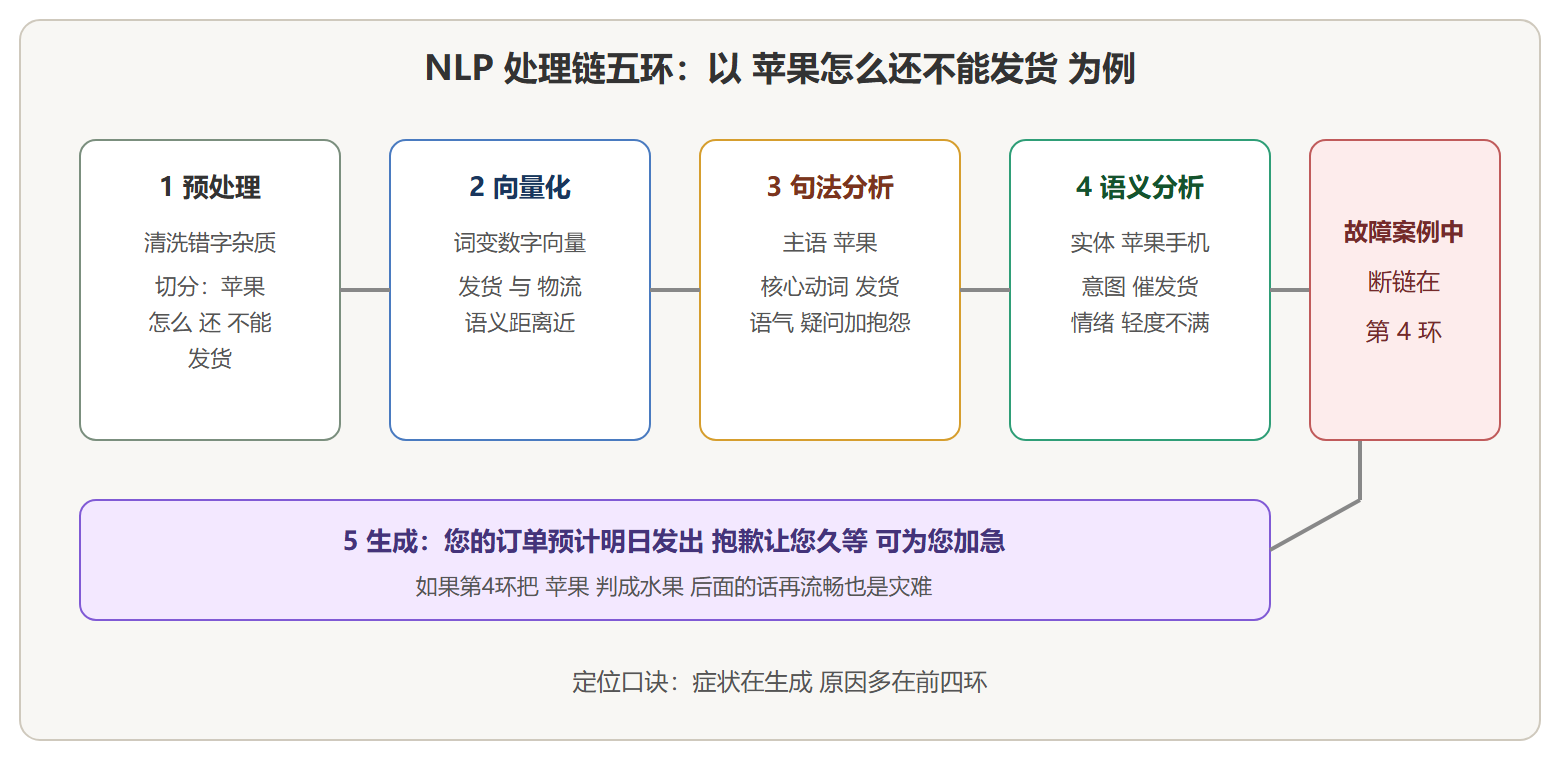
面对这些困难,工业界的答案是分层拆解:把"理解一句话"拆成一条流水线,每环解决一小块。这条链可以概括为五段。
第一段是文本预处理,把网页标签、表情符号、错别字、全半角混杂这些"泥沙"滤掉,再把连续文本切成词元。"我想查快递"被切分为"我/想/查/快递",后续环节才有操作对象——中文没有天然空格,这一步比英文难做得多,细节在第1.2节展开。
第二段是向量化表示。计算机只懂数值,词语必须变成数字向量。用最简单的词频统计,还是用能捕捉语义的词向量,是效果与成本的第一个重大分岔口,第1.3节专讲。
第三段是句法分析。词性标注标出名词动词,依存句法分析找出"谁对谁做了什么"。它像给句子画主谓宾的骨架图,在用户输入复杂长句时,骨架能帮系统定位意图的核心动词和受事对象。
第四段是语义分析,NLP 的价值高地。命名实体识别抽出"订单号 12345""上海";意图识别判定"查询物流";情感分析判断用户情绪是急是怒;关系抽取发现"蒂姆·库克任职于苹果公司"这类事实。第1.4节会把这些任务逐个配齐算法。
第五段是自然语言生成,把系统决策变回流畅人话,从填充模板到深度学习生成,可控性与自然度此消彼长。
这五段不是教条,实战中常按需裁剪:做垃圾评论过滤,可能只需要前两段加个分类器;做智能客服,五段缺一不可。流水线的好处是故障可定位——开头那个"苹果"案例,最后定位结果是语义分析环节的实体消歧没接用户历史订单,修补点非常明确。
处理链五环功能对照
看懂「NLP 难在哪」的关键,是把语言当作符号系统与当作意义载体的双重身份同时拿在手里:符号层面它离散、多变、有歧义,意义层面它依赖常识与上下文。从字词到篇章的各层挑战,本质上都是这两重身份打架的产物——分词歧义是符号切分与意义单元的错位,指代消解是符号省略与意义完整的错位,讽刺识别则是符号表面与真实态度的彻底反叛。工程上没法一次解决所有层,但可以先定位自己的任务卡在哪一层,再选对应武器。这也是本教程把「任务建模」放在「算法学习」之前的原因:先知道自己打的什么仗,再挑兵器。
四、NLU 与 NLG:一条链的两端
把视角拉高一点。语言理解(NLU)涵盖上面链条的一到四环:解析词义、句法、语义乃至篇章,把非结构化输入变成结构化表示。语言生成(NLG)反着走:从结构化数据或系统决策出发,规划内容、组织句子、落地成文字。
两端的不对称值得体会。理解的错误是"静默"的——意图判错了,系统还会一本正经地继续,直到用户不耐烦才暴露;生成的错误是"响亮"的——回复里一句不合事实的话,用户立刻就能看见。所以工业实践里,理解侧追求的是召回和兜底策略(拿不准就追问),生成侧追求的是可控(模板兜底、生成审核)。这个不对称在第2章的客服架构里会反复出现。
两个方向的应用版图也不同。理解侧的成果支撑着意图识别、情感分析、实体抽取、文本分类、主题发现这一票任务,是智能客服和内容分析的共同底座;生成侧的成果支撑自动回复、摘要改写、报告生成,在内容分析里主要扮演"压缩信息"的角色。
💡 关键直觉:NLP 系统的智能上限通常由理解侧决定,但用户体验的下限往往由生成侧决定。用户能原谅一个回答朴素但准确的系统,不会原谅一个辞藻华丽但答非所问的系统。
五、从问题到技术:一张导览图
本节建立的问题框架,会在后续各节逐一兑现。歧义与上下文依赖,靠上下文词向量(第1.3节)和知识图谱(第2.2节)缓解;语言动态性与数据稀疏,靠子词切分(第1.2节)和预训练迁移(第1.3、第4章)压制;常识缺失,正被大语言模型大幅改写(第4.3节)。你不需要记住这些映射,只要养成一个习惯:每见到一个新技术,先问"它在治哪个病"。
⚠️ 常见坑:拿到业务问题就直奔模型选型,是新手最常见的弯路。正确顺序是先按处理链拆解问题——原始数据有多脏(第1.2节的活)、需要什么粒度的表示(第1.3节的活)、最终要什么形态的输出——拆完再谈算法。跳过拆解直接选模型,等于不诊断就开药。
要点速记
- NLP 的定义:让计算机理解、处理、生成人类语言的交叉学科,分为语言理解(NLU)与语言生成(NLG)两大方向;
- 五大困难:歧义、上下文依赖、语言动态性、数据稀疏、常识缺失——几乎所有故障都能归到这五类;
- 处理链五环:预处理、向量化、句法分析、语义分析、生成;故障定位从链路入手,症状在末端、病灶多在中段;
- 理解与生成不对称:理解错误静默累积,生成错误即时可见,因此两端的工程策略取向不同;
- 问题驱动的学习法:每学一项技术先问它治哪个病,技术清单才不会变成名词堆。
下一节我们钻进处理链的第一环:原始文本究竟有多脏,预处理又该怎么把泥沙滤干净而不误伤语义。