第2章 NLP在智能客服中的应用
第2章 · NLP在智能客服中的应用
章节摘要:为什么客服机器人总在答非所问、一遍遍让用户"换个说法试试"?本章把智能客服拆成五层架构,沿着"用户一句话进来、系统回复出去"的完整链路,逐层分析意图识别、槽位填充、对话管理、回复生成各环节的失守点,再给出评估与优化的系统方法。读完你能定位一次客服故障该在哪一层修,以及为什么"转人工率"比"准确率"更值得盯。
本节导航
阅读完本章,你应当能够:
- 画出智能客服的五层架构(交互层、核心处理层、知识管理层、数据集成层、运维监控层)并说明各层职责;
- 解释意图识别与槽位填充为什么常联合建模,槽位缺信息时系统该如何追问;
- 区分对话状态追踪的槽位表方法与信念状态方法,说出四代对话策略的演进逻辑;
- 列出技术、业务、体验三层评估指标,并设计一套 A/B 测试验证优化效果;
- 针对一个转人工率过高的客服系统,提出分层的排查与优化路径。
核心概念速览
智能客服不是一个大模型,而是一条流水线——水浑了先查格栅,别急着换滤芯。
一句话的旅程:客服系统处理链路
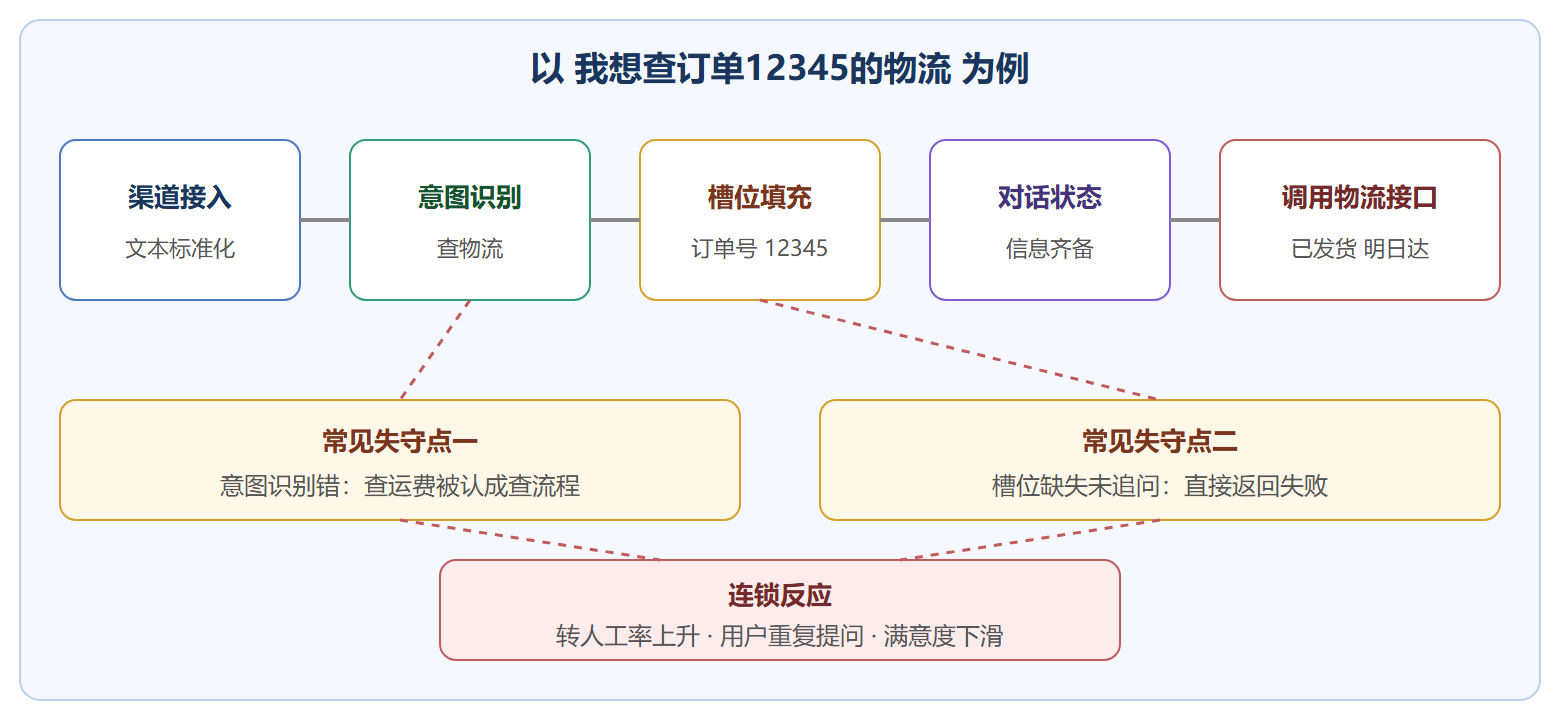
本章的阅读主线是「一条消息的完整旅程」:从抵达通道、被理解、查知识、经对话管理、到生成回复、进入评估闭环。四个小节恰好对应旅程的四段路,串起来读比孤立读每节收获大得多——2.1 的架构是地图,2.2 的技术是引擎,2.3 的对话管理是司机,2.4 的评估是行车记录仪。建议读完 2.4 后回头再看一眼 2.1 的架构图,那时你会自然地在每个模块旁标注出它对应的评估指标,架构与运营就在这一刻接上了头。能完成这个闭环标注,智能客服这一章就算真正毕业。
子章节导航
2.1 智能客服系统架构与模块
一块完整的"解剖图"。五层架构各管什么,NLU、知识库、对话管理、NLG、后端集成、运维监控六大模块如何协同,用一个"查订单物流"的完整时序把所有模块串一遍。
2.2 核心NLP技术在客服中的应用
逐项拆解技术栈:意图识别与槽位填充、命名实体识别、情感分析(情绪预警)、语义匹配(同义问法)、知识图谱(多跳问答)、文本摘要(对话总结)、机器翻译(多语言客服)。重点讲每项技术的"输入—输出—怎么选模型"。
2.3 对话管理与用户体验
多轮对话为什么难:上下文丢失、意图漂移、用户打断。讲对话状态追踪(槽位表与信念状态)、四代对话策略(规则、统计、强化学习、大模型)、以及主动澄清、优雅降级、情感安抚等体验策略,附十项评估指标。
2.4 性能评估与优化
系统上线只是开始。三层指标体系(技术、业务、体验)、离线评估与在线 A/B 测试的方法、数据驱动与模型层面的优化手段(数据增强、蒸馏、量化),以及 PDCA 持续改进闭环的落地要点。
子章节之间的逻辑关系
观点先行:2.1 是空间轴(系统长什么样),2.2 是技术轴(每层用什么算法),2.3 是动态轴(多轮对话怎么流转),2.4 是时间轴(怎么越跑越好)——四条轴交叉处,就是一次故障的坐标。
2.1 架构分层 ──放置──→ 2.2 技术清单 │ │ └── 动起来 ──→ 2.3 对话流转 │ 持续运转 ↓ 2.4 评估优化 ──反哺──→ 2.1 知识库 2.2 模型 2.3 策略
排查故障时按这个顺序问:先看 2.1 的链路哪一环(日志定位),再看 2.2 的模型指标是否异常,然后查 2.3 的状态管理有没有丢上下文,最后用 2.4 的方法验证修复效果。
前置知识与后续延伸
- 前置:第1章的全部内容,尤其是 1.4 的任务清单——本章的每项技术都能在那儿找到原型。
- 为后续铺垫:本章的评估指标体系(准确率、F1、转人工率)在第3章第4节会以内容分析的视角重讲一遍;本章的用户反馈闭环思想,与第4章的监控体系一脉相承。
- 延伸阅读建议:读完本章回头重做 1.4 的速查表,把每个任务后面补上"在客服里的落点"一列,知识就串起来了。
⚠️ 一句忠告:别用单一指标考核智能客服。只考核准确率,团队会把模糊问题全转人工;只考核转人工率,团队会硬答不会的题。指标要成组使用,相互制衡。
常见问题
自建客服系统还是买云服务
看数据敏感度和定制深度。金融、医疗类客户数据出不了内网,只能自建或私有化部署;普通电商场景用云服务起步更快,把精力留给知识库运营——实践中知识库质量对解决率的贡献常大于模型选型。一个折中路线是:前期用云服务验证价值,规模上来、需求特殊后再逐步自建核心模块。
机器人越像真人越好吗
不一定。用户发现"真人"其实是机器人后的反感,常比一开始就知道是机器人更强烈;监管趋势也要求 AI 表明身份。体验的关键不在拟人,而在"能解决问题、答不上时痛快转人工"。把力气花在意图覆盖和追问策略上,比调教语气词回报更高。