1.4 常用NLP任务与算法
1.4 常用NLP任务与算法
本节摘要:本节把前两节的零件组装成八类常用任务:文本分类、命名实体识别、语义相似度匹配、文本摘要、自然语言生成、问答系统、序列标注与文本预处理任务族。每个任务按"输入—输出—代表算法—典型坑"四要素展开,并给出按数据规模与精度需求选型的决策路径。读完本节,你面对一个业务需求时应能快速说出"这是哪类任务、用什么算法起步、第一个坑在哪"。
阅读收获
阅读完本节,你应当能够:
- 把"工单自动分类""评论摘要""同义问法识别"等业务语言翻译成标准 NLP 任务;
- 为每类任务说出至少两代算法(统计方法与深度方法)及各自适用条件;
- 区分抽取式与生成式摘要、检索式与生成式问答的边界;
- 用"数据量—精度要求—延迟预算"三要素为一个新任务选起步方案。
一、任务图谱:八类任务各管什么
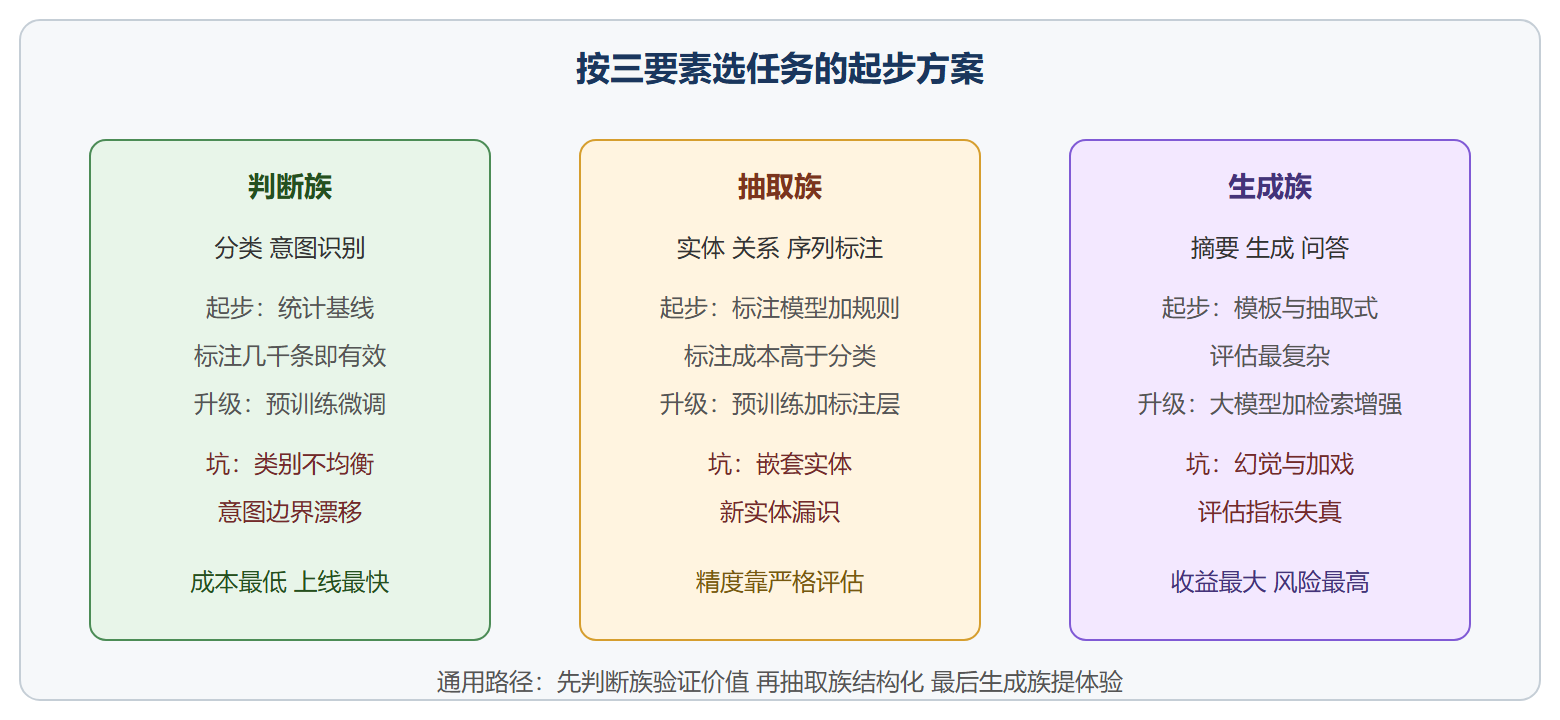
一个便于记忆的组织方式:按"输出形态"把任务分三族。输出一个标签的是判断族(文本分类、意图识别);输出一段位置的是抽取族(命名实体识别、序列标注、关系抽取);输出一段新文本的是生成族(摘要、自然语言生成、问答)。判断族最成熟最便宜,生成族最灵活最危险——这条难度与风险的双升曲线贯穿本节。
| 任务 | 输入 | 输出 | 判断/抽取/生成 |
|---|---|---|---|
| 文本分类 | 一段文本 | 预定义类别之一 | 判断 |
| 意图识别 | 用户话语 | 意图标签 | 判断 |
| 命名实体识别 | 一段文本 | 实体及类型、位置 | 抽取 |
| 序列标注 | 分词序列 | 每个词元的标签 | 抽取 |
| 语义相似度匹配 | 两个文本 | 相似分数 | 判断 |
| 文本摘要 | 长文档 | 短文本 | 生成 |
| 自然语言生成 | 结构化信息或上下文 | 自然语句 | 生成 |
| 问答系统 | 问题加可选文档 | 答案文本 | 生成 |
二、判断族:分类与意图识别
文本分类是 NLP 的"主食":垃圾邮件过滤、新闻主题归类、工单分流、评论打标,全是它。算法两代分明。统计代用词袋或词频逆文档频率特征加朴素贝叶斯、支持向量机:几千条标注就能起步,训练几分钟,可解释性好(能说出门户词权重),是任何分类任务的必做基线。深度代用预训练模型微调:语义泛化能力强,"退货失败"和"退不了货"能归为一类,代价是算力与标注量的上升。
意图识别本质是分类在对话场景的马甲,但多了三个特殊问题。一是意图边界模糊:"我想退货"可能指退款、退换货或取消订单,多意图并存时需要置信度阈值加兜底追问。二是意图体系会漂移:产品改版三个月后,新意图冒头、旧意图萎缩,模型必须能增量更新。三是训练数据天然不均衡:查订单占四成流量,某冷门业务一天不到十条——不处理不均衡,冷门意图永远学不好。这三个问题在第2.2节会结合客服场景细讲。
💡 关键直觉:做分类任务先跑统计基线再上深度模型,不是为了省钱,是为了知道深度模型带来了多少真实增益。没有基线的精度数字是孤立的,无法判断值不值那份复杂度。
三、抽取族:实体、序列与关系
命名实体识别从文本里抠出人名、地名、机构、时间、产品型号、金额,并判明类型。客服里"订单号 12345""上海明天到"全靠它落地。算法演进是教科书级的序列标注路线:早期用隐马尔可夫和条件随机场这类统计模型,把每个字标注为"实体的开始、实体的内部、非实体";深度时代用双向长短期记忆网络加条件随机场的组合——前者读上下文,后者保证标签序列合法(比如"实体的内部"不能凭空跟在"非实体"后面);再往后是预训练模型加标注层,边界精度显著提升。它的典型坑有三:嵌套实体("苹果手机"既是产品又是品牌)、新实体(新款型号不在训练集)、边界争议("三号仓库的货架"里实体到哪算完)——评估时要用严格的边界匹配标准,否则指标虚高。
关系抽取在实体的基础上再进一步,判断实体之间的语义关系:"蒂姆·库克任职于苹果公司"抽出"人物—任职—机构"三元组。它是知识图谱的原料线,第2.2节和第3.3节都会用到它。序列标注是这一族的母任务:分词、词性标注、实体识别全是"给每个词元打标签",模型底座可以共用,一个标注模型常同时服务多个抽取任务。
四、匹配族:语义相似度
语义相似度计算衡量两段文本在意义上的接近程度,是搜索去重、同义问法识别、推荐召回的引擎。技术路线三代:字符串与统计相似(编辑距离、词频重合),只认字面;静态词向量平均后算余弦夹角,能抓同义但平均操作丢失语序;预训练模型时代分两条技术路线——双塔结构与交叉结构。双塔把两段文本各自编码成向量再算相似度,两段可以离线预计算,速度快,适合百万级候选库的粗筛;交叉结构把两段拼在一起进模型做深度交互,精度高但每对都要现算,适合小候选集的精排。生产系统的标准打法是先双塔召回再交叉精排,两段流水线各取所长。
客服场景的落地形态是常见问题库匹配:用户问"怎么退货",库里标准问法是"退货流程是什么",字面重合度低、语义距离近,靠向量匹配才能命中。第2.2节会展开这个应用。
五、生成族:摘要、生成与问答
生成族的任务要"写"出新文本,风险与灵活性同步放大。
文本摘要两路线。抽取式从原文里挑出最重要的句子拼成摘要,忠实原文、不会捏造,但读起来常像摘抄;代表方法是基于图排序的算法——把句子当节点、句间相似度当边,算每个句子的重要度。生成式用新语言重新组织概括,更接近人类写法,但可能"加戏"——原文没有的细节被模型脑补出来。工程选择看容错:财报摘要、医疗文书这类零容忍场景,抽取式保底;资讯速览这类低风险场景,生成式体验更好。评估用面向召回的摘要重叠指标(比对生成与参考的词组重合)加人工审读,第3.4节细讲。
自然语言生成范围最广:从结构化数据写短讯("您的订单已发货,预计明日送达"),到对话回复生成。工业系统的主流是模板与深度生成混合:高频固定场景用模板,保证零错误;开放场景用模型生成,配审核策略。纯生成路线的最大敌人是幻觉——流畅但错误的输出,第4.3节专门处理。
问答系统按答案来源分三类。检索式从知识库里找最相关的条目返回,本质是匹配加排序,可控性最好;抽取式在文档里定位答案片段,介于检索与生成之间;生成式用大模型综合多源信息组织答案,体验最自然、风险也最高。三类常组合成流水线:先检索召回候选,再抽取或生成最终答案——这个"检索增强"思路正是当前大模型落地的主流架构之一。
三族任务的选型决策
六、组合拳:一个需求拆成一串任务
真实业务从不是单任务。看一个例子:"分析本月用户评论,找出最影响复购的问题"。拆解下来:先做分类把评论按主题归组(判断族);再做方面级情感分析,判断每条评论对物流、包装、质量各维度的态度(判断族的精细化变体);对高负面组做实体与产品型号抽取,定位问题机型(抽取族);最后每组生成一段三句话总结(生成族)。四步各用一族技术,评估口径也各不相同——这就是为什么本教程反复强调先拆解再选型。
再举智能客服的例子:用户一句"上周买的耳机右边没声音",系统同时跑意图识别(判断:报障)、实体抽取(耳机型号、故障描述)、情感分析(判断:情绪等级),三个结果汇给对话管理决定是追问型号还是直接建工单。第2.2节将完整展开这条链路。
⚠️ 常见坑:把任务族选错级别。最容易犯的两个错:一是该用判断族的上了生成族——只需打标签的审核任务用生成模型,慢、贵、还不可控;二是该用生成族的死守判断族——需要灵活应答的场景全靠关键词模板,用户体验僵化。判断标准就一条:任务是否需要"写出原文没有的内容",需要才上生成族。
另一个坑是评估错位:用判断族的准确率标准去评估生成任务,或反之。分类看精确率召回率,抽取看边界匹配率,生成看重叠指标加人工审读——拿错尺子,结论必然失真。第3.4节会把各任务的评估指标配齐。
七、从任务到应用:第2、3章的原料清单
本节的八类任务就是后面两章的原料库。智能客服主要消费:意图识别、槽位填充(抽取族)、语义匹配、问答、对话生成。内容分析主要消费:文本分类、情感分析、主题发现(判断族变体)、实体与关系抽取、摘要。同一原料在不同场景的火候不同:意图识别在客服要求毫秒级响应,内容分析的分类可以批处理跑通宵;这就是同一技术两副面孔的根源。
本节速览
- 三族分类法:判断族(分类、意图)最成熟,抽取族(实体、关系)做结构化,生成族(摘要、问答)最灵活也最危险;
- 统计基线先行:任何分类任务先跑词频加线性模型的基线,再决定是否值得上深度模型;
- 双塔与交叉是语义匹配的两段式标准架构:召回要快用双塔,精排要准用交叉;
- 抽取式保底、生成式提效:摘要与问答都可以按容错度在两条路线间选,检索增强是当前生成任务的主流护栏;
- 组合拳思维:真实需求几乎都要拆成多任务流水线,拆解清楚了选型自然清楚;
- 评估要对口:三族任务各有各的指标体系,拿错尺子比不做评估更糟。
任务的原料备齐了。下一章进入第一个战场:智能客服——看这些任务怎么被组装成一条每秒承受成百上千次对话的实时流水线。