2.4 智能客服的性能评估与优化
2.4 智能客服的性能评估与优化
本节摘要:智能客服的评估指标分三层:技术指标(准确率、精确率、召回率、F1 分数、响应时间、吞吐量、稳定性)、业务指标(满意度、首次解决率、自助服务率、平均处理时长、成本节约)、体验指标(任务完成率、错误率、留存参与度)。评估方法分离线(标注数据集、混淆矩阵、错误分析、回归测试)与在线(A/B 测试、灰度发布、用户反馈)两套;优化沿数据、模型、架构、流程四条线推进,并以计划—执行—检查—行动的循环持续运转。本节从一个"指标好看、口碑崩盘"的案例切入。
本节导读
阅读完本节,你应当能够:
- 说出三层指标各回答什么问题,以及为什么单层指标必然失真;
- 用混淆矩阵做错误分析,把错误归类为误识别、漏识别、歧义、知识缺失四类并对应不同处置;
- 设计一个合规的 A/B 测试验证优化效果,说明灰度发布的作用;
- 列出数据优化的四个动作(清洗、标注扩充、增强、不平衡处理)与模型优化的三板斧(蒸馏、剪枝、量化);
- 描述持续改进闭环的四个环节及反馈来源。
一、指标好看,口碑崩盘
某团队的季度汇报很漂亮:意图识别准确率百分之九十二,比上季度提升三个点。同一时间,客服邮箱的投诉却在增加。拆开看才发现问题:测试集是半年前构建的,新增的两类高频意图根本不在里面——模型在旧考卷上确实进步了,但考卷已经不覆盖真实考题。更糟的是,准确率是把所有意图平均算的,两个高频意图的误判(占流量四成)被十几个低频意图的高分稀释掉了。
这个案例给出本节的第一条原则:指标必须贴近真实分布。离线测试集要定期用线上新样本刷新;分类指标要按流量加权看分项,宏平均(各类一视同仁)和微平均(按样本量加权)至少各看一遍。第二条原则紧随其后:技术指标只是体温计,业务与体验指标才是病情。准确率涨了但满意度没动,多半是优化打在了低价值区域。
二、三层指标体系
技术层回答"机器准不准快不稳"。理解侧看准确率、精确率(报出来的有多少对)、召回率(该报的报出来多少)、两者的调和均值 F1 分数——精确率与召回率天然此消彼长,报得保守则精确高召回低,报得激进则反之,F1 用于综合权衡。系统侧看响应时间(用户等待体感的直接来源)、吞吐量(高峰期撑不撑得住)、可用性(长期稳定运行比例)。
业务层回答"值不值"。客户满意度(问卷评分与净推荐值)是终点指标;首次解决率衡量一次到位的能力;自助服务率与转人工率是一体两面,直接反映分流人工压力的效果;平均处理时长与成本节约算的是经济账——智能客服的投资回报最终要在这层兑现。
体验层回答"用户爽不爽"。任务完成率(用户角度的成功,与系统角度的"会话正常结束"不是一回事);错误率(理解错、答错、引导错的比例,直接侵蚀信任);留存与参与度(用脚投票的终极指标)。
| 层 | 代表指标 | 回答的问题 | 优化周期 |
|---|---|---|---|
| 技术 | 准确率 F1 响应时间 吞吐量 | 机器准不准快不稳 | 天级监控 周级优化 |
| 业务 | 满意度 首次解决率 转人工率 成本 | 对公司值不值 | 月度复盘 季度目标 |
| 体验 | 任务完成率 错误率 留存参与 | 用户爽不爽 | 实时感知 持续迭代 |
三、离线评估:考卷、错题本与回归防线
离线评估在上线前与迭代中做,三样东西是标配。
标注数据集是考卷。用真实用户语料,人工标注意图与实体,按大约八比一比一的比例切分为训练、验证、测试集,且测试集绝不参与训练。考卷要定期换新——第一节案例的教训。
混淆矩阵是错题本。一张表看清模型把 A 类错认成 B 类的每一格,错误分析由此入手。把错误归成四类,处置方向完全不同:误识别(意图 A 认成 B,需要补易混对的区分样本)、漏识别(没认出来,往往缺该类样本或表达变体)、语义歧义(人类也难断,考虑合并意图或加澄清策略)、知识库缺失(模型没错,是没答案,补知识库而非调模型)。最后一类尤其重要:把知识库问题误诊为模型问题,是优化资源的最大浪费。
回归测试是防线。模型每次更新,用固定旧测试集跑一遍,确保修了新问题没引入新退化——模型优化的"按下葫芦起了瓢"非常常见,回归测试是唯一的系统性保险。
四、在线评估:真实流量里验证
离线分数再高也只是预测,真实表现要在线验证。
A/B 测试把用户流量随机分组,一组用旧版一组用新版,对比满意度、转人工率等业务指标,用统计显著性判断差异是不是噪声。要点有二:分流必须随机(按用户而非按请求分,否则同一用户体验割裂);观察期要够长(覆盖工作日与周末、不同时段的流量模式)。
灰度发布是风险更低的上线方式:新版本先放给百分之五的用户,观察无异常再逐步放大。它兼具新功能验证与故障隔离两用——出问题影响面只有百分之五。
用户反馈分直接与间接。直接反馈是会话结束的评分与评价;间接反馈藏在行为里:用户重复提问(没解决)、中途弃聊(体验差)、主动要求转人工(不信任)。间接信号量大且真实,但需要专门的日志分析管道去挖。
五、四条优化主线
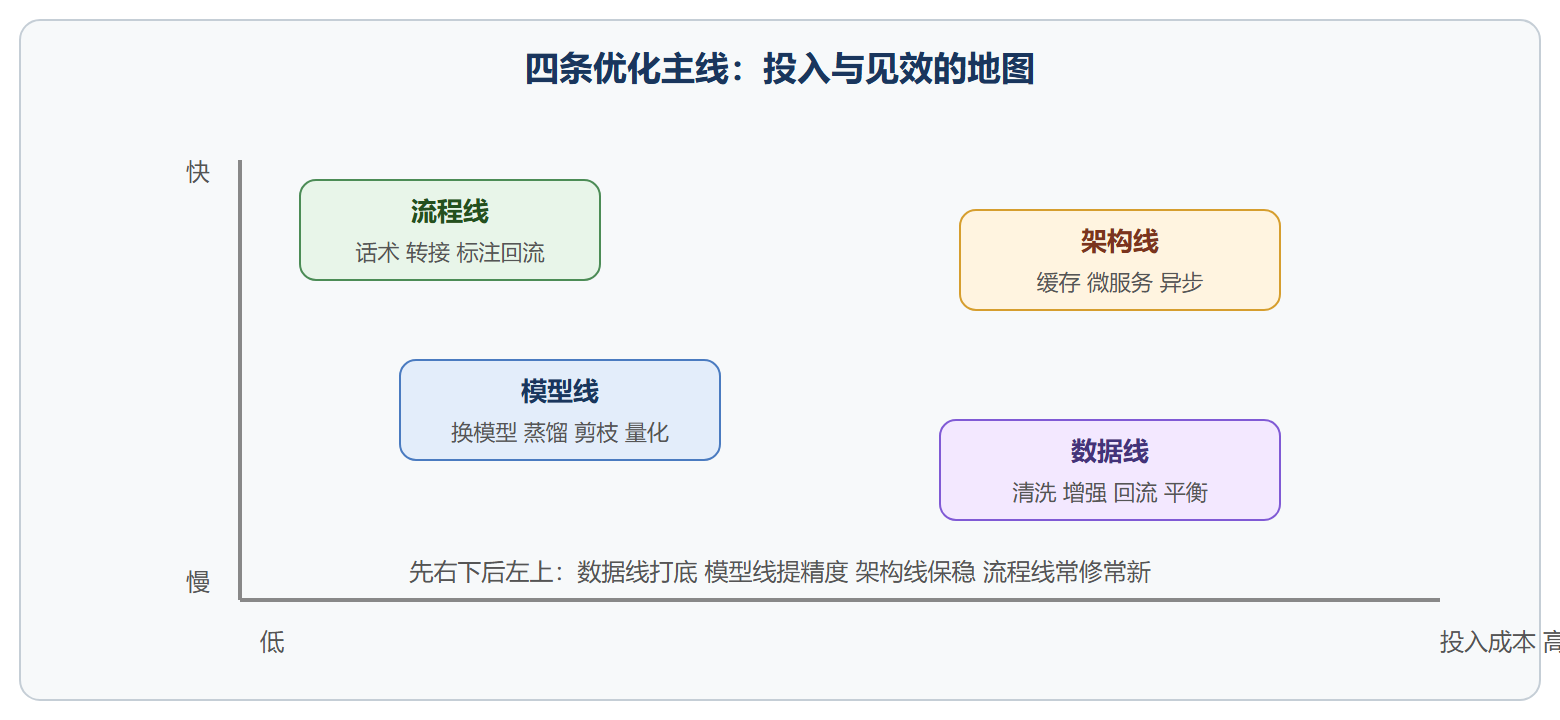
评估定位问题,优化解决问题。四条主线按见效速度与投入成本排序。
数据线见效最慢但后劲最足:清洗线上语料的噪声与重复;把转人工与未命中的会话持续标注回流(这是最珍贵的新训练素材);用同义改写、回译等方法做数据增强,低成本扩充样本;对稀有的高价值意图做过采样或欠采样平衡分布。数据线的每一分投入,所有下游模型都受益。
模型线按需升级:统计模型换预训练微调、双塔换交叉精排、超参数网格搜索。部署前常做三板斧压缩——知识蒸馏让小模型学大模型的输出(保效果、降延迟)、剪枝删掉不重要的连接、量化把参数精度从高降到低(省内存、提速度)。三板斧常组合使用,把大模型的成本压进线上预算。
架构线保稳定:高频问答结果缓存、微服务拆分让意图识别与问答匹配独立扩容、异步处理把日志与统计挪出主链路。这条线与第4.2节的部署运维高度衔接。
流程线改体验:转人工链路是否顺畅、追问话术是否友好、人工客服的标注是否回流反哺模型。流程线的改动成本最低、最容易被忽视,也最容易在复盘时发现"问题根本不在模型"。
优化动作见效矩阵
六、持续改进的闭环
优化不是项目,是循环。业界通用的四步循环完全适用:计划(设定可量化目标,如"下季度自助服务率提升五个百分点")、执行(实施四条线中的具体动作)、检查(A/B 验证效果,对比指标)、行动(固化有效经验、调整无效方向,进入下一轮)。
闭环的燃料是三类反馈:用户反馈(评分、投诉、行为信号)、运营反馈(人工客服与运营人员的一线记录,他们最先知道哪里别扭)、数据反馈(对话日志的挖掘结果,长尾问题、热点变迁、模型漂移)。三类反馈各有盲区——用户说不清技术原因、运营有主观偏好、数据缺业务语境——交叉印证才可靠。
还有一件常被漏掉的事:把评估结果讲给不做技术的人听。管理层关心的是成本与满意度的曲线,业务方关心的是哪些问题还在转人工,一线客服关心的是"这个新模型会不会又改我的话术"。同一份错误分析报告,至少要有技术版、业务版、运营版三种讲法——数据再好,讲不清就换不来改进的资源与配合,闭环的最后一公里其实是沟通。
⚠️ 常见坑:三个。其一,指标口径不统一——"解决率"在不同团队嘴里含义不同(用户没再问就算解决?还是用户确认解决了?),先统一口径再谈提升,否则所有优化都在优化定义。其二,忽视回归——新模型上线只看新指标,三个月后发现旧功能悄悄退化。其三,用离线指标代替在线验证——离线达标只说明"有资格上线",不等于"上线会好",跳过灰度直接全量,等于裸奔。
💡 关键直觉:评估的目的不是证明系统好,而是找到下一个最值得修的问题。抱着"汇报好看"的心态做评估,指标会越来越好、系统原地踏步;抱着"找茬"的心态做评估,每次复盘都是一张明确的改进清单。错误分析比精度数字值钱十倍。
要点速记
- 三层指标各有分工:技术层是体温计、业务层是病情、体验层是感受,单层指标必然失真,必须贴近真实流量分布地看;
- 离线三件套:定期换新的标注考卷、当错题本用的混淆矩阵、防"按下葫芦起了瓢"的回归测试;
- 错误四分类定处置:误识别补区分样本、漏识别补变体、歧义改体系加澄清、知识缺失补库不动模型;
- 在线验证两板斧:A/B 测试判显著性,灰度发布控风险,离线达标只是上线的资格证;
- 四条优化主线:数据打底、模型提精、架构保稳、流程常新,按投入产出排序推进;
- 闭环靠三类反馈交叉:用户、运营、数据,任何单一来源都有盲区。
客服战场到此完整走了一遍。下一个战场换到内容分析:那里没有用户实时等待,却有几十万条文本等着被读懂——约束变了,同一批技术要换一副打法。