第3章 NLP在内容分析中的应用
第3章 · NLP在内容分析中的应用
章节摘要:三十万条用户评论、上千份行业报告、每天涌进的社交帖子——读不完,也数不清。本章讲如何用 NLP 把海量非结构化文本变成可决策的洞察:从分类、情感、主题、实体的基础任务,到多模态、时序、跨语言、因果推断的高级分析,再到评估验证的方法论。读完你能为一条"分析用户反馈"的业务需求设计完整的技术路线,并回答老板那句"这结果可信吗"。
阅读收获
阅读完本章,你应当能够:
- 说清内容分析与智能客服在约束上的本质差异(批处理求准 vs 实时交互求快);
- 为"用户反馈分析"需求选配任务组合:分类打标签、情感分极、主题聚类、实体抽取、摘要提炼;
- 解释方面级情感分析与文档级情感分析的差别及适用条件;
- 描述主题模型三代技术(LDA、NMF、BERTopic)的演进逻辑与评估方式;
- 用黄金标准、交叉验证、领域专家审查、A/B 测试四道关口验证分析结果的可信度。
核心概念速览
内容分析不是把文本变短,是把噪声变成证据。
从原始文本到决策的加工流水线
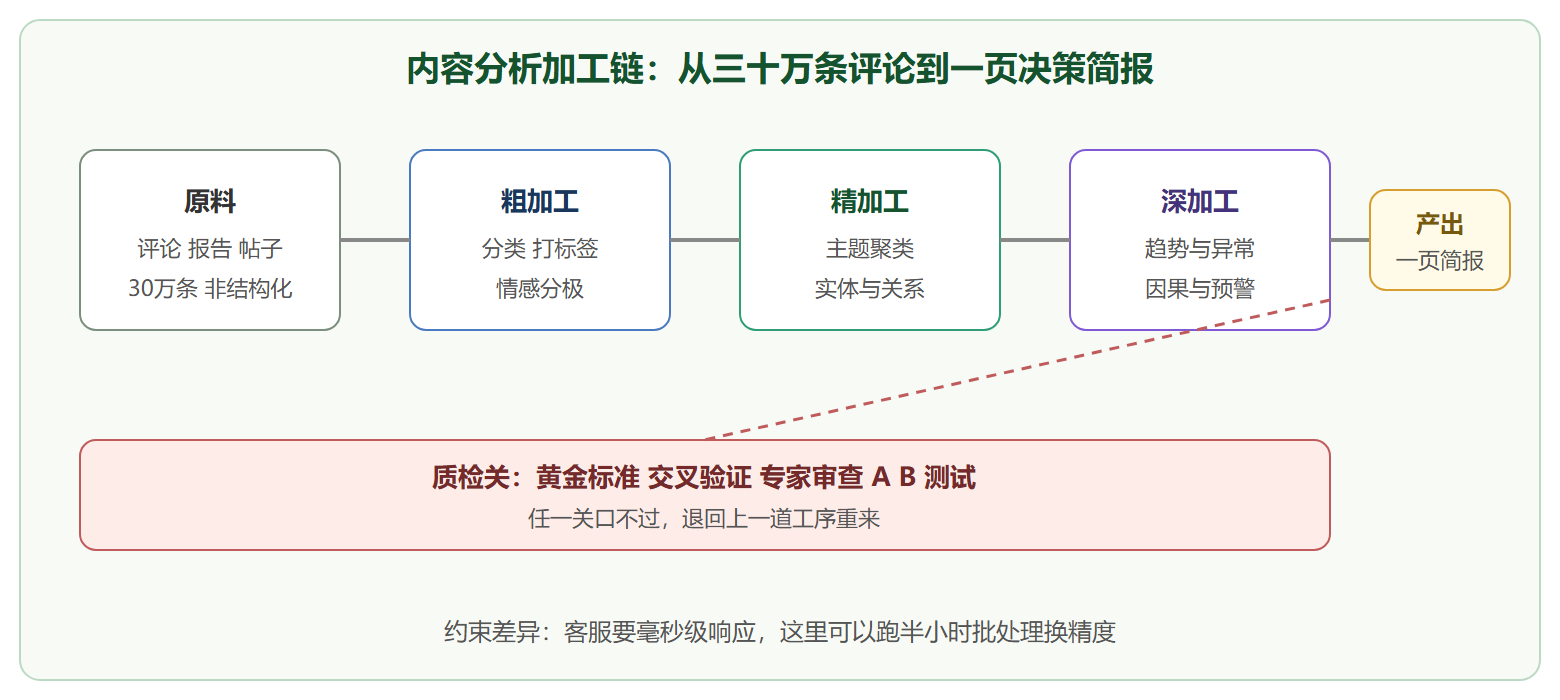
内容分析一章的主线是把「文本堆」变成「决策依据」的三级跳:第一跳是从原文到结构化标签(3.2 的技术层),第二跳是从标签到洞察模式(3.3 的高级分析),第三跳是从洞察到可信结论(3.4 的评估验证)。很多团队倒在第二跳到第三跳之间——洞察讲得头头是道,验证一做样本就缩水。把 3.4 提前到选型阶段读一遍,带着「这个方法最后怎么验」的问题回来学 3.2 与 3.3,整个章节的重量分布会健康很多:技术不再是炫技,而是可交付结论的生产资料。
子章节导航
3.1 内容分析的价值与场景
先回答"值不值得做"。六类价值(数据决策、效率成本、体验提升、风险规避、竞争情报、产品优化)与七大典型场景(客户反馈、市场研究、舆情监控、合规审计、人力资源、内容推荐、学术文献),每个场景给出"输入—分析动作—产出"的具体形态。
3.2 核心NLP技术在内容分析中的应用
技术主菜。文本分类(含垃圾过滤与风险预警)、情感分析(文档级到方面级)、主题模型(LDA、NMF、BERTopic 三代对比)、文本摘要(抽取式与生成式)、关键词提取、关系与事件抽取,每项配"怎么选"的判断规则。
3.3 高级内容洞察与模式识别
从"描述现状"进阶到"发现规律":多模态分析(图文互证)、时序模式(舆情演变、需求变迁)、跨语言统一分析、因果关系发现、异常检测与新兴趋势识别、知识图谱构建、个性化洞察。
3.4 内容分析的评估与验证
没有验证的分析等于猜。定量指标分任务选(分类看 F1、摘要看 ROUGE、主题看一致性、聚类看轮廓系数),验证方法分四道关(黄金标准、交叉验证、专家审查、A/B 测试),并直面主观性、语境依赖、真值缺失三大评估难题。
子章节之间的逻辑关系
观点先行:3.1 定价值边界(别为分析而分析),3.2 是工具箱,3.3 是组合拳,3.4 是裁判——顺序读,跳过 3.4 的分析项目最危险。
3.1 值不值得做 ──决定──→ 需求拆解 ↓ 3.2 单件工具:分类 / 情感 / 主题 / 实体 / 摘要 ↓ 组合 3.3 组合拳:时序 + 跨语言 + 多模态 + 因果 ↓ 验收 3.4 裁判:指标 + 黄金标准 + 专家 + A B 测试 ↓ 可信后才进决策
3.2 的每个单项技术都可能成为 3.3 组合分析的构件:主题模型加上时间轴就是趋势分析,实体抽取叠上关系就是知识图谱。而 3.4 的评估结果会反过来告诉你 3.2 里哪个环节拖了后腿。
前置知识与后续延伸
- 前置:第1章的表示方法(3.2 的主题模型直接建立在向量表示上)与 1.4 的任务清单。
- 与第2章的关系:同一批底层技术在两个场景换装——情感分析在客服是预警器(单条实时判),在内容分析是统计表(批量离线判),精度与速度的取舍方向相反。
- 为后续铺垫:本章产出的用户洞察会喂给第4章的大语言模型做深度加工;3.4 的评估方法论与第4章的模型监控(漂移检测)同源。
💡 一条实践铁律:内容分析项目立项时先写好验收标准(多少准确率、谁签字确认),再动技术。没有验收标准的分析项目,最后都会变成"看起来有点道理"的 PPT。
常见问题
情感分析准确率多高才能用
看用途。粗粒度趋势监控(本周负面占比是否上升)对准确率宽容,七成也能看出走势;但用于自动处罚商家、下架内容这类高影响动作,九成都不够,必须配人工复核。原则是:模型输出影响越大,精度门槛和人工介入比例越高。
主题模型的主题数怎么定
没有解析解,靠试。主题数太少会把"物流慢"和"包装破"揉成一团,太多会把同一个话题撕成几瓣。实用做法是:先按业务常识给一个数量级,再用主题一致性指标扫描对比,最后让业务方看词表——人读不懂的主题再多也是垃圾。第3章第2节和第4节会分别从生成与评估两端展开。