第4章 跨领域与前沿技术
第4章 · 跨领域与前沿技术
章节摘要:模型训好了只是开始。客户数据能不能用、系统怎么扛住大促洪峰、大语言模型要不要上、行业往哪走——这四个问题决定了 NLP 项目是"能跑的 demo"还是"能赚钱的系统"。本章讲数据管理与隐私合规、部署监控与可扩展性、大语言模型落地,最后展望行业趋势。读完你能为一个 NLP 项目设计合规的数据流程和可扩展的部署方案,并冷静评估大模型的机会与风险。
本节导读
阅读完本章,你应当能够:
- 描述数据生命周期的六个阶段,并说明每个阶段的合规要点;
- 对比 GDPR 的"明确同意"与 CCPA 的"选择退出"两种监管思路,说出中国两部数据法律的核心要求;
- 解释差分隐私、联邦学习、同态加密三种隐私技术的原理边界与成熟度差异;
- 为高并发智能客服设计容器化部署与弹性伸缩方案,并说出模型漂移的监控方法;
- 客观评估大语言模型在客服与内容分析中的收益(少样本、生成质量)与代价(幻觉、成本、合规)。
核心概念速览
越是前沿的技术,越要配越传统的护栏——合规和监控不是创新的刹车,是上路的保险。
四层问题的依赖关系
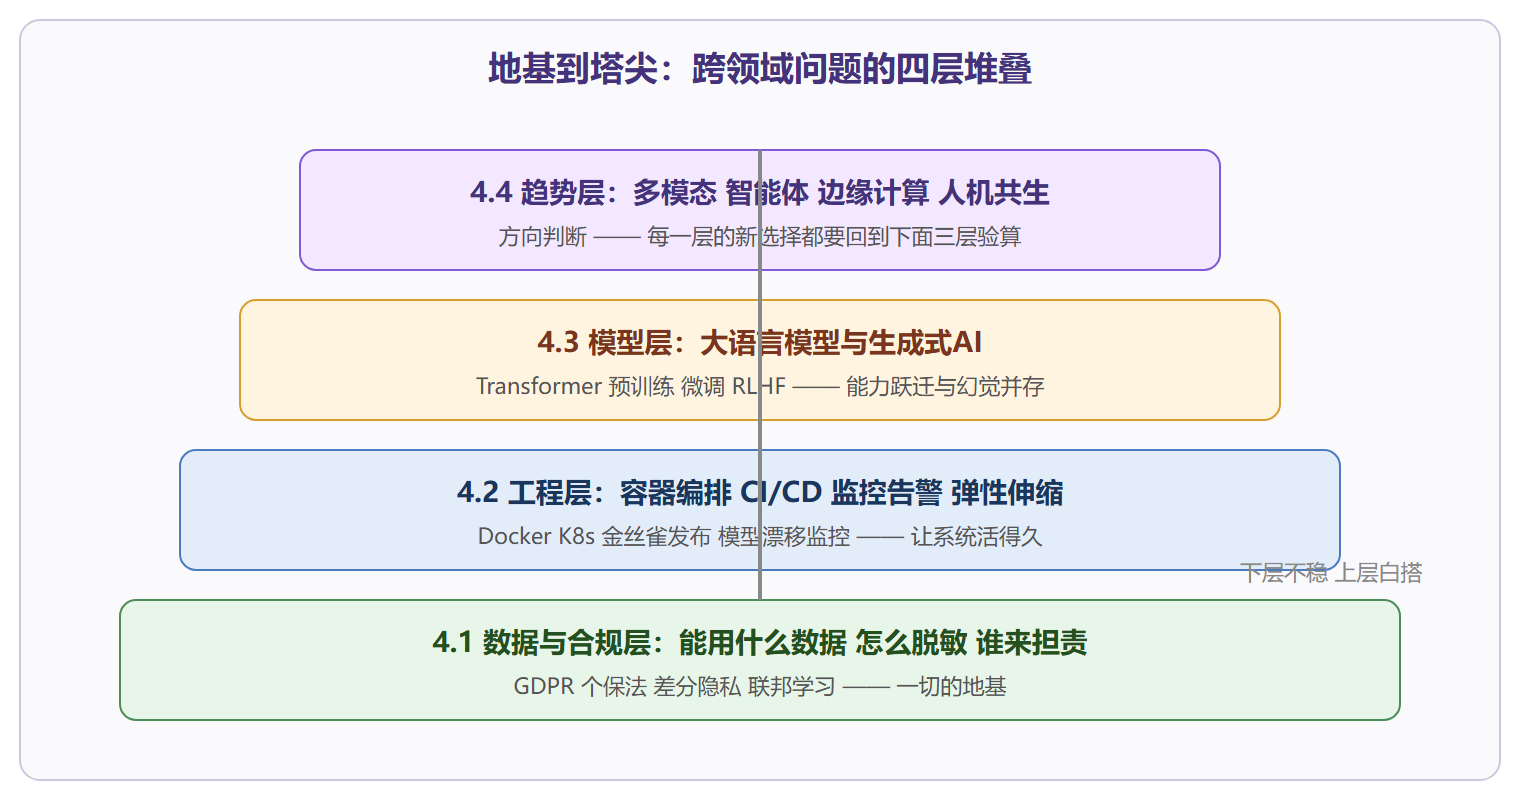
末章的三个小节构成一套「出门行囊」:4.1 的伦理与数据管理是底线清单——什么不能碰、怎么合规地碰;4.2 的部署与监控是落地清单——从笔记本到生产线要补哪些课;4.3 与 4.4 的大模型与趋势是方向清单——接下来三五年往哪走。三张清单对应三种错误:没底线会翻车,不会落地会烂尾,没方向会内卷。读完本章不妨给自己各打一个分,最低的那项就是下一个学习周期的主题。这也呼应全书的方法论:按缺口学习,而不是按目录学习。
子章节导航
4.1 数据管理与隐私伦理
最容易被工程团队轻视、出事时最致命的一章。数据质量五要素、生命周期六阶段、治理框架;个人身份信息的识别与脱敏;GDPR、CCPA 与中国数据安全法、个人信息保护法的对照;差分隐私、联邦学习、同态加密的原理与落地成熟度;算法偏见与伦理责任。
4.2 部署、监控与可扩展性
模型从笔记本走进生产环境的完整路径:云、本地、混合三种部署的取舍;容器化与编排(Docker 与 Kubernetes);持续集成与金丝雀、蓝绿发布;监控体系(延迟、吞吐、模型漂移);垂直与水平扩展、异步消息队列;以及 API 安全与基础设施防护。
4.3 大语言模型与生成式AI
正在改写行业的技术变量。Transformer 自注意力、预训练与微调范式、RLHF 对齐;生成机制与采样策略;大模型在客服(动态回复、座席辅助)与内容分析(细粒度情感、知识发现)中的落地形态;直面幻觉、偏见、成本、可解释性四大挑战。
4.4 行业趋势与未来展望
收束全局。四项核心驱动力、五条技术趋势(大模型深化、多模态、超个性化、可解释AI、边缘计算)、产业应用深化方向(数字员工、智能内容大脑),以及数据偏见、人才稀缺等挑战背后的机遇。
子章节之间的逻辑关系
观点先行:这四节是向上堆叠的四层楼——数据是地基,工程是结构,大模型是加速器,趋势是风向标;跳层建设必塌。
4.1 数据合规(地基) └→ 4.2 部署工程(结构) └→ 4.3 大模型(加速器:能力放大 但风险同放大) └→ 4.4 趋势(风向:决定前两层未来怎么建)
三处强关联值得记住:4.3 的大模型训练离不开 4.1 讲的数据合规边界(拿用户对话微调前先问"有没有授权");4.3 的幻觉问题要靠 4.2 的监控体系兜底(生成内容需要质量抽检);4.4 的边缘计算趋势直接改变 4.2 的部署形态。
前置知识与后续延伸
- 前置:第2、3章任一章即可,本章的案例大多来自这两个场景。
- 延伸方向:对合规感兴趣的读者可以此为入口深入研究本地区行业监管细则;对工程感兴趣的读者可继续深入容器编排与模型服务框架的实践。
- 最后一课的分量:技术会过时,但"数据要合规、系统要可观测、生成要可追溯"这三条原则,在可见的未来不会过时。
⚠️ 经验之谈:NLP 项目的翻车复盘里,"用了不该用的数据"和"上线后没人盯着"是最高频的两个原因,前者属于 4.1,后者属于 4.2。这两节即使只精读一本文集,也值得是它们。
常见问题
大模型会取代传统 NLP 管线吗
短期内是共存。大模型在理解、生成上能力强,但推理成本高、延迟不稳、输出需要防幻觉;高并发的意图识别、实体抽取等任务,小模型加蒸馏仍是性价比之选。务实的架构是分层调度:简单任务走小模型,复杂对话和长文本理解才调大模型。第4章第3节会详细算这笔账。
合规会不会拖慢迭代
方法得当反而提速。把脱敏、授权检查做进数据管道的固定工序,一次投入长期受益;反之,事后补救(数据已污染训练集再回滚)的代价是十倍不止。把隐私设计前置到需求阶段,是"慢即是快"的典型场景。