4.1 数据管理与隐私伦理
4.1 数据管理与隐私伦理
本节摘要:数据管理与隐私伦理是 NLP 系统的合规地基:数据质量五要素(准确、完整、一致、时效、代表)决定模型性能,生命周期六阶段(收集、存储、处理、使用、共享、销毁)各有合规要点;个人身份信息需识别后脱敏、掩码、删除或加密;法规层面要理解通用数据保护条例的"明确同意"、加州法案的"选择退出"与中国两部数据法的核心要求;技术层面有差分隐私、联邦学习、同态加密、安全多方计算四道防线;伦理层面直面临明性与算法偏见。本节从一次数据泄露事故讲起。
先说结论
阅读完本节,你应当能够:
- 说出数据质量五要素与生命周期六阶段,并指出客服语料各阶段的高风险点;
- 描述个人身份信息的四种处理手段(脱敏、掩码、删除、加密)的差别;
- 对比"明确同意"与"选择退出"两种监管思路,说出中国两部数据法的核心原则;
- 解释差分隐私、联邦学习、同态加密的原理边界与成熟度排序;
- 列出算法偏见的三个来源与对应缓解措施。
一、一次本可避免的泄露
某公司的客服系统出过一次事故:测试团队为排查问题,把三万条真实对话记录(含姓名、电话、地址)导出到一个未加密的共享盘"临时用一下"。半年后安全扫描发现这批文件时,它们已经被内外部数十人访问过。事后追责很清晰,但更值得复盘的是流程漏洞:从生产库导出数据没有任何审批环节,测试环境与个人身份信息之间没有强制脱敏闸门,"临时用一下"畅通无阻。
这不是孤例,而是通病:NLP 系统以对话和文本为原料,而对话天然携带个人身份信息——用户随口就会报手机号、地址、订单号。数据管理和隐私伦理不是法务部门寄来的合规手册,而是这类系统每天都要面对的工程现实。本节把这条线拆成管理、法规、技术、伦理四段讲。
二、数据管理:质量与生命周期
质量五要素决定模型性能的上限。准确性:语料里的错别字与歧义句会直接教坏模型;完整性:对话缺上下文片段,模型学到的是残缺模式;一致性:多来源数据格式与标注标准不统一,会引入系统性偏差;时效性:用户语言习惯随时间漂移,三年前的客服语料训今天的模型会脱节;代表性:训练数据覆盖不了实际用户群(比如只采了年轻人语料),模型对未覆盖群体表现骤降——这最后一个要素直接连着后文的偏见问题。
生命周期六阶段各有合规要点。收集:目的、范围、方式先明确,来源合法且取得同意——客服录音转文本训练模型,用户知情了吗?存储:加密存储、分类分级(一般数据与敏感数据不同策略)。处理:清洗与标注在脱敏后的数据进行。使用:数据只用于收集时声明的目的,客服数据拿去训营销模型就是越界。共享:与第三方交换必须协议加脱敏双保险。销毁:到期数据彻底销毁而非"删个快捷方式"。开篇事故的病根,正是"使用与共享"两阶段零管控。
治理框架是六阶段的操作系统:数据策略与标准(分类、保留期限)、所有权与责任(谁拥有、谁管理、谁使用)、流程控制点、审计监控、质量与安全管理。没有治理框架的生命周期管理,靠的是每个人的自觉——而自觉是所有安全机制里最不可靠的一种。
三、个人身份信息:识别与处理
对话语料里的个人身份信息识别本身就是 NLP 问题——用命名实体识别技术抠出姓名、电话、证件号、银行卡号,嵌在非结构化文本里的信息靠人工排查根本扫不完。识别出来后四种处理手段按场景选用:
| 手段 | 做法 | 适用场景 |
|---|---|---|
| 脱敏 | 替换为格式相同的假数据 | 测试与开发环境 |
| 掩码 | 只显示部分(卡号留后四位) | 界面展示 |
| 删除 | 彻底移除 | 不再需要的分析字段 |
| 加密 | 密文存储传输 | 必须保留原始值的场景 |
敏感数据(健康、财务、生物特征等)要在分类分级里单列更高保护级,处理前需更严格的匿名化甚至直接排除。要清醒的是:匿名化不等于绝对安全——多数据集交叉比对可能"再识别"出个人(几项看似无害的属性组合起来唯一定位到某人),高维数据场景要持续评估匿名化效果。
四、法规地图:三种监管思路
欧盟的通用数据保护条例是全球最严的标杆,核心原则一组词:合法公平透明、目的限制(数据只用于声明目的)、数据最小化(只收必要的)、准确性、存储限制(到期即删)、安全保密、问责制。用户权利包括访问、更正、删除(被遗忘权)、可携带、拒绝自动化决策。对企业的影响是全链路的:从收集时的同意机制到响应用户删除请求的系统设计。
美国加州的消费者隐私法案思路不同:侧重"选择退出"——默认可以处理,但消费者有权说停、要求删除、拒绝出售;而欧盟强调"明确同意"——不点头不能动。一字之差,产品设计完全两样:同意模式要在入口处弹明确授权,退出模式要常驻"拒绝"开关。
中国的数据安全法与个人信息保护法构成国内双支柱:前者确立数据分类分级保护、明确处理者安全义务;后者确立合法、正当、必要、诚信原则,对跨境传输与敏感个人信息有专门规定。在国内运营的智能客服,收集前获同意、敏感信息特别保护、数据出境安全评估,三条硬线不能碰。
三地法规细节各异,原则相通:最小化收集、目的限定、用户控制、安全问责。按这四原则设计的系统,面对新法规只需要对表微调;反过来按最松标准设计的系统,每出一部新法都要伤筋动骨。
五、技术防线:四道保护网
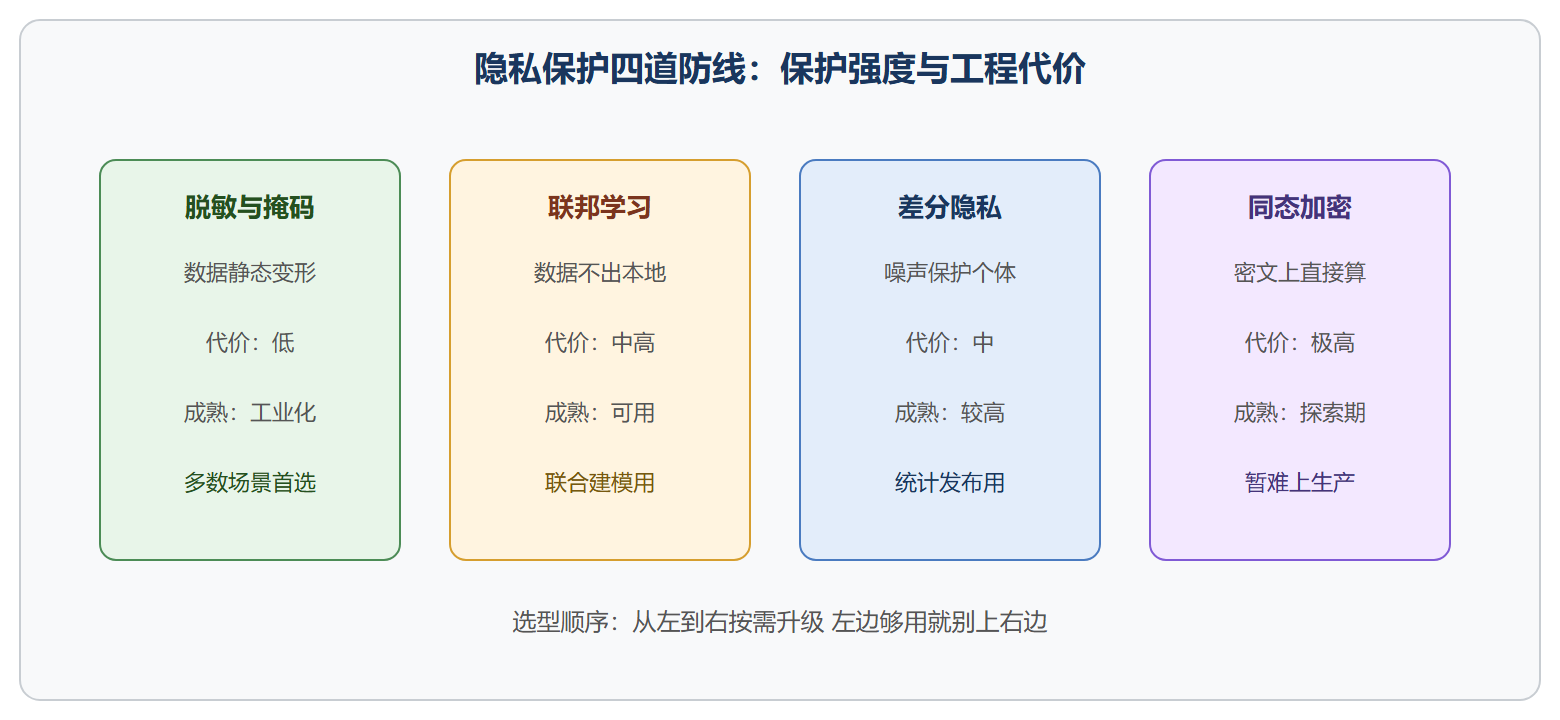
差分隐私:向统计结果注入精心校准的噪声,使得任何单一个体的加入或退出对结果的影响微乎其微——数据整体可用、个体不可辨。适合词频统计、聚合分析类场景,在模型训练中也有应用。成熟度较高,但噪声大小与可用性要权衡。
联邦学习:数据不出本地,各参与方在本地训练、只上传模型参数或梯度到中心聚合。多家企业想共建客服模型又都不愿交出对话数据,联邦学习正好解这个僵局。工程复杂度高(各方数据分布不齐、通信开销大),但在金融、医疗等强合规行业已是标配选项。
同态加密:直接对密文计算,全程不解密,"带密运算"。理论上最彻底——服务方见不到明文却能为它做推理。现实是计算开销高出明文几个数量级,目前主要停留在研究与小规模试点,别指望它近期扛生产流量。
安全多方计算:多方共同完成计算,彼此看不到对方输入。适合联合统计与联合建模的特定场景。另有区块链技术用于数据授权与流转的存证溯源——记录谁在何时授权了什么,不可篡改,泄露事故追责时有据可查。
成熟度排序大致是:脱敏掩码(工业化)高于联邦学习与差分隐私(可用但重)高于安全多方计算(特定场景)高于同态加密(探索期)。工程选型从左往右越来越贵,必要性却未必递增——多数合规需求,最左边那层加流程管控已经够用。
四道技术防线对比
六、伦理:透明、公平、问责
技术合规之外还有伦理三问。
透明与可解释:智能客服给出某个回复,能否解释依据了什么?内容分析把一篇文章标记为风险,理由是什么?黑箱决策在高影响场景(金融、医疗)既是信任问题也是监管问题。务实做法:给关键决策留解释接口(哪怕只是"命中了哪条规则、检索到哪条知识")、向用户说明在与机器对话、披露数据的用途。
公平与偏见:偏见的三个来源——数据源偏见(客服语料主要来自某类人群,模型对其他人群的语言理解打折)、训练放大(算法无意放大了数据中的偏差)、反馈循环(模型给某群体更差的服务,该群体更少使用,数据更少,服务更差)。缓解措施对应三招:提升训练数据的多样性与代表性、用公平性指标分群监测模型表现(按地区、年龄段、语言习惯切片看指标差距)、保留人工干预通道纠偏。
问责与社会影响:数据泄露、模型出错、自动化决策伤及用户时,责任链条要事先明确——数据所有者、模型开发者、运营方各担什么。部署大规模系统前值得做社会影响评估:自动化对人工岗位的冲击、推荐系统可能加剧的信息茧房、内容分析技术被滥用于过度监控的风险。这些不是杞人忧天,而是项目走远之前必须写在纸面上的预案。
⚠️ 常见坑:三个。其一,"先跑起来再合规"——数据已经进训练集、模型已经上线,此时要合规就得回滚重来,代价十倍于事前设计。隐私设计前置(系统设计之初就融入隐私原则)是唯一正确的顺序。其二,匿名化迷信——删了姓名就当万事大吉,交叉再识别的口子完全敞开。其三,合规当项目做——过一次认证就束之高阁,法规在更新、数据在增长,合规必须是持续运营的流程而非一次性工程。
💡 关键直觉:把数据合规想象成建筑消防规范——它约束了你的设计自由,但正是它保证楼不烧、人不伤、生意做得长久。最贵的合规投入,也远比最便宜的一次泄露事故便宜。
温故知新
- 质量五要素与生命周期六阶段:准确、完整、一致、时效、代表决定模型上限;收集到销毁每阶段有合规要点,治理框架是贯穿的操作系统;
- 个人身份信息四手段:脱敏、掩码、删除、加密按场景选用,匿名化不等于绝对安全,警惕交叉再识别;
- 三种监管思路:欧盟明确同意、加州选择退出、中国两部法律确立分类分级与最小必要,四条通用原则是应对新法规的锚点;
- 四道技术防线:脱敏工业化、联邦与差分可用但重、同态加密仍在探索,按需从左往右升级;
- 伦理三问:透明可解释、公平反偏见(三来源对三招)、问责与社会影响前置评估;
- 隐私设计前置:合规是持续流程不是一次性项目,事后补救的代价是事前的十倍。
数据的地基打牢了,下一节把系统送进生产环境:部署怎么选环境、监控盯什么指标、流量翻十倍时靠什么活下来。