1.1 什么是 NoSQL:不止是 SQL
1.1 什么是 NoSQL:不止是 SQL
作为全书的起点,本节先给"NoSQL"这个词一个能用的定义,并划清它的边界——哪些技术算、哪些不算。它承接导读的历史叙述,产出的是后面四章都要反复引用的"定义坐标系":搞不清这个坐标系,第 2 章的门派划分就会像背单词表一样飘在空中。
学习目标
阅读完本节,你应当能够:
- 给出 NoSQL 的准确含义,解释为什么它不是"不用 SQL 的数据库";
- 说出区分 NoSQL 家族的四个判断特征;
- 举出至少三种典型 NoSQL 产品,并指出它们分别牺牲了什么;
- 判断一个具体的存储需求是否适合用 NoSQL 解决。
先看一个定义的失效
问一个新工程师"NoSQL 是什么",最常见的回答是"不用 SQL 的数据库"。这个定义 2009 年还勉强成立,今天已经漏洞百出:MongoDB 早就有了完整的 SQL 风格查询能力,Cassandra 支持 CQL(一门长得像 SQL 的查询语言),连 Redis 都有人做了 SQL 层封装。反过来,号称"不写 SQL"的很多场景用的其实是关系型数据库的 ORM。
问题出在用"界面语言"定义一个技术流派。真正区分 NoSQL 的不是查询语言,而是数据模型与系统设计的取舍。一个更站得住的定义是:
NoSQL 是一类非关系型数据库的统称:它们不把数据组织成二维表,不强制固定的表结构,通常原生支持分布式部署与水平扩展,并以放宽部分事务与一致性保证为代价,换取特定数据模型下的扩展性与性能。"Not Only SQL"这个别名暗示了它的真实定位——在多数系统里它与关系型数据库并存,而不是取代。
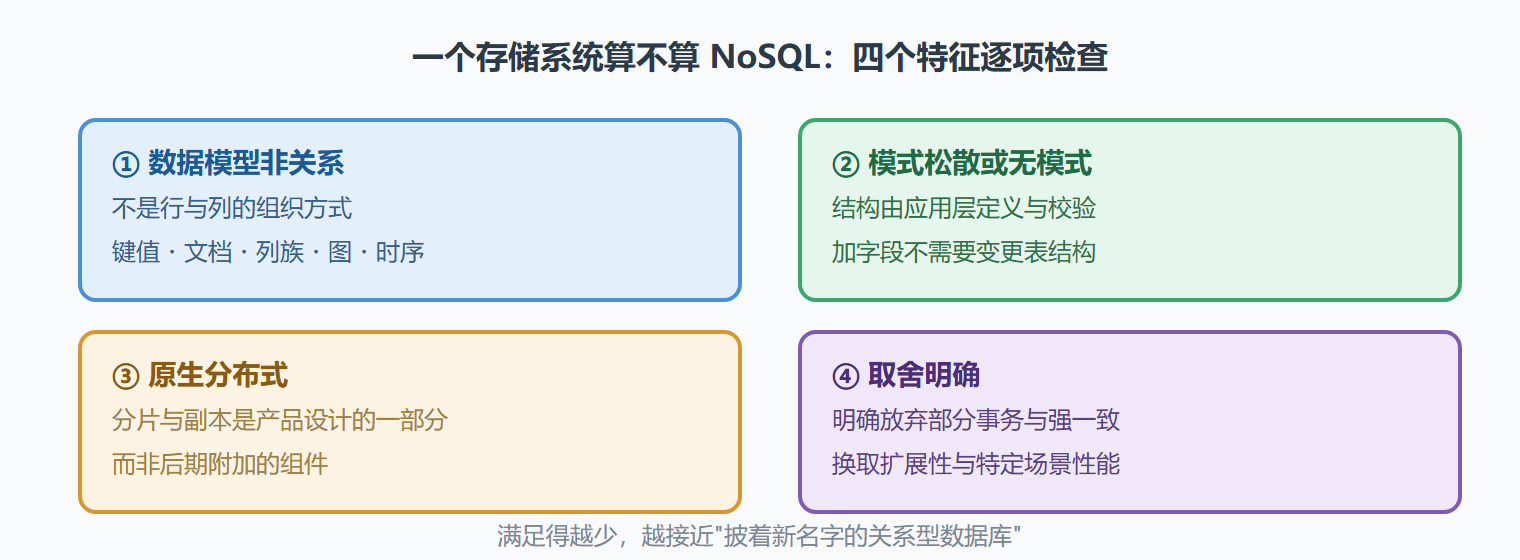
把这句话拆开,就是判断一个存储系统"算不算 NoSQL"的四个特征:数据模型非关系(不是行与列);模式松散或无模式(结构由应用层约束);原生分布式(分片与副本是产品设计的一部分,而非附加组件);取舍明确(明确放弃某些 ACID 能力换性能与规模)。四个特征未必全部满足才算,但满足得越少,它越接近"披着新名字的关系型数据库"。
演练:同一份数据的两种表达
用一份数据看两种世界观的差别。假设要存一个用户资料:昵称、邮箱、最近三笔订单。
关系型数据库的做法是先设计表结构,把数据压平到多张表中,用外键关联:
-- 关系型表达:先定结构,再填数据 CREATE TABLE users ( id BIGINT PRIMARY KEY, nickname VARCHAR(64) NOT NULL, email VARCHAR(128) NOT NULL ); CREATE TABLE orders ( id BIGINT PRIMARY KEY, user_id BIGINT NOT NULL REFERENCES users(id), amount DECIMAL(10,2) NOT NULL, created_at TIMESTAMP NOT NULL ); -- 取"最近三笔订单"需要关联查询 SELECT u.nickname, o.amount FROM users u JOIN orders o ON o.user_id = u.id WHERE u.id = 1001 ORDER BY o.created_at DESC LIMIT 3;
文档型数据库(以 MongoDB 为例)则把一个实体的数据聚合成一份文档,一并取出:
// 文档型表达:数据天然聚合,一次读取拿到全部 db.users.insertOne({ _id: 1001, nickname: "山丘", email: "shanqiu@example.com", recentOrders: [ { orderId: 9001, amount: 129.00, createdAt: ISODate("2026-08-30T10:20:00Z") }, { orderId: 8976, amount: 58.50, createdAt: ISODate("2026-08-28T19:05:00Z") }, { orderId: 8831, amount: 210.00, createdAt: ISODate("2026-08-25T08:41:00Z") } ] }) // 读取:无需关联,一次定位 db.users.findOne( { _id: 1001 }, { nickname: 1, recentOrders: 1 } )
两种表达各自的结果值得细看。关系型的路线换来的是:任何查询角度都可用(按金额查订单、按时间范围查都行),数据无冗余,更新订单不会出现两处不一致。文档型的路线换来的是:读一个实体只需一次 IO、文档结构可以随业务演进(明天给用户加个"等级"字段不用改表)、写路径简单。代价同样清晰:文档里的 recentOrders 若无限增长会把文档撑爆;跨文档的复杂关联查询不再是强项。这组对照就是后面所有章节的母题——数据放在哪、以什么形状放,决定了系统能力的高低分布。
图:NoSQL 定义坐标系——四个判断特征
易错点与边界澄清
三个高频误解放在一起澄清。
误区一:NoSQL 不支持事务。 多数 NoSQL 不提供跨多张表、多行数据的完整 ACID 事务,这是对的;但"单文档原子性"这类局部事务能力普遍存在,Redis 的 Lua 脚本甚至能做出与事务等价的原子操作序列。第 3、4、5 章会分别展开。
误区二:NoSQL = 大数据专用。 只有数据量巨大才需要 NoSQL 是另一个流行误判。很多团队用 Redis 只是为了一个几 GB 的会话缓存,用 MongoDB 是因为运营活动页的字段三天一变。数据规模只是动因之一,数据形态与迭代速度同样重要——这正是 1.2 节的主题。
误区三:凡是不用 SQL 的都算 NoSQL。 判断标准是前面那四个特征,不是语言。比如把数据存成本地 JSON 文件的小工具,数据模型虽然灵活,但没有分布式与并发控制设计,通常不归入 NoSQL 家族。
FAQ
问:NoSQL 这个名字是谁起的,当初就是这个意思吗? 2009 年柏林那场技术聚会的标签,最初确实带着"反 SQL"的情绪。随后社区很快意识到取代并不现实,"Not Only SQL"的解释被广泛接受——它更像一场对关系模型垄断地位的纠偏,而不是革命。
问:一个系统里可以同时用关系型和 NoSQL 吗? 不但可以,而且是主流做法。订单与账务放关系型数据库保事务,商品详情与会话放 NoSQL 求性能与灵活,这种组合有个专门的名字叫混合持久化,1.3 节会专门讨论。
本节要点回顾
- NoSQL 的本质是非关系数据模型 + 松散模式 + 原生分布式 + 明确取舍,与查询语言无关。
- "Not Only SQL" 的定位是共存与互补,不是取代关系型数据库。
- 同一份数据在两种世界观下的表达差异,本质是读路径与写路径的取舍。
- 判断是否适合 NoSQL,看数据规模、数据形态、迭代速度三个维度,而非盲目追新。
- 局部事务能力(单文档、单键、Lua)在 NoSQL 中普遍存在,别被"无事务"的旧标签误导。