1.2 NoSQL 的兴起:一场数据规模的叛变
1.2 NoSQL 的兴起:一场数据规模的叛变
1.1 节给出了定义坐标系,本节回答"定义为什么长这样"——任何技术的设计都是它的历史压痕。读完本节你再看第 3 章的 CAP 定理时,会明白那些看似抽象的约束全部来自这一时期真实公司的真实故障。
从三个 V 说起
把时间拨回 2003 到 2008 年。搜索引擎、社交网络、电商大促这三类业务,把数据库要面对的数据压成了三个维度:规模(Volume)从 GB 冲向 TB 再冲向 PB;形态(Variety)从规整的账目数据扩展到日志、点击流、消息、地理位置等半结构化数据;速度(Velocity)从每天百万次查询变成每秒数十万次写入。业内把这三个维度合称 3V,它们不是概念游戏,而是三类各不相同的技术压力:规模逼你把数据摊到多台机器,形态逼你放弃固定表结构,速度逼你为特定访问模式重写存储引擎。
关系型数据库在三股压力面前的反应值得认真研究。它并非没有分布式方案——基于共享存储的商业集群早就存在——但那些方案的思路是垂直扩展(Scale Up):换更强的 CPU、更大的内存、更贵的存储阵列。这条路线在硬件成本曲线上走得越远越陡:一台能扛住 PB 级数据的高端小型机,价格可能是几十台普通服务器的十倍以上,而且天花板仍然存在——单机总有用尽的一天。
水平扩展(Scale Out)是另一条路线:数据分摊到大量廉价机器上,容量不够就加机器。关系型数据库做分片要靠应用层手工切分,主从复制延迟带来的不一致、跨片事务的复杂性,全都暴露给业务代码。 业界需要一个天生为分布式设计的存储系统,而不是把单机软件硬塞进机柜。
两篇论文点燃的导火索
真正的转折点是两篇内部技术论文的公开。
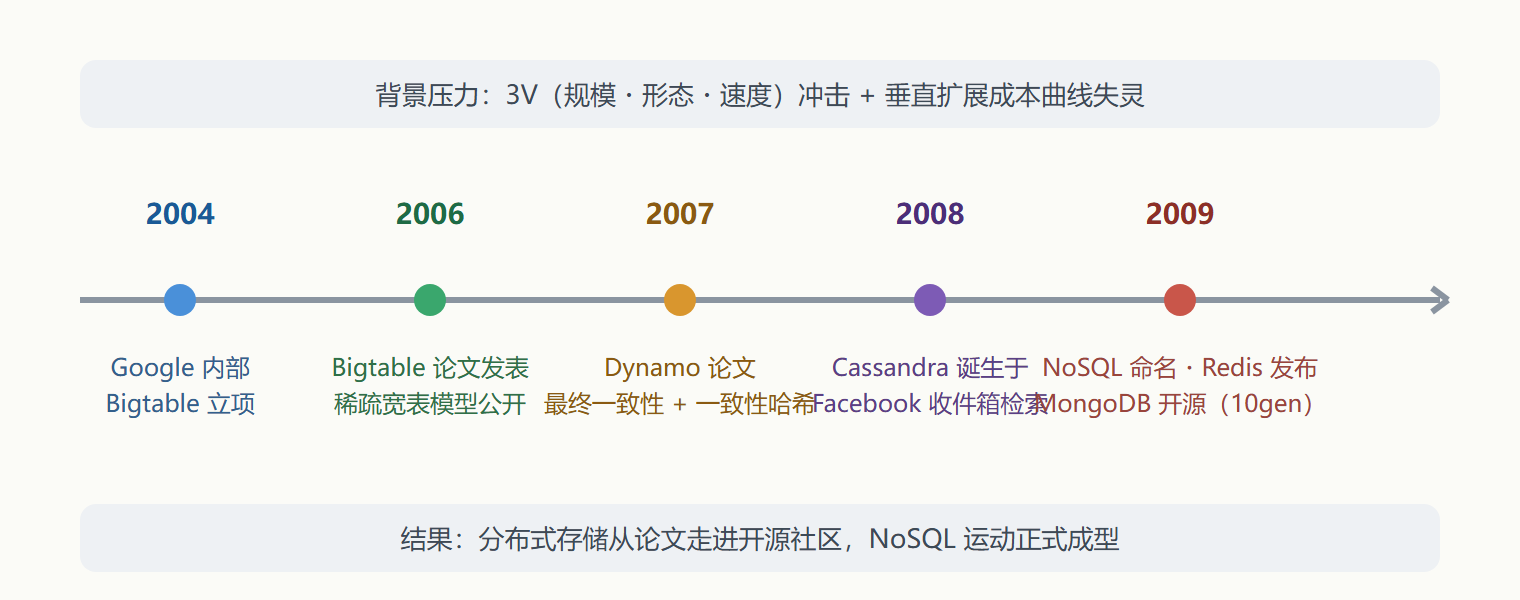
2006 年,Google 发表 Bigtable 论文,描述了支撑其网页索引系统的分布式存储:亿万行、上千列的稀疏表,数据按行键有序分片,每片可以动态分裂迁移。它放弃了完整的关系模型和 SQL,换来近乎无限的横向扩容。
2007 年,Amazon 发表 Dynamo 论文,面对的是另一组约束:购物车数据必须全年无休可写入,哪怕机房断网、节点宕机也不能拒绝用户下单。为此 Dynamo 选择了最终一致性,用一致性哈希把数据均匀摊在集群里,写入时用可调的副本数换取可用性与一致性的平衡。
这两篇论文几乎是后来所有 NoSQL 产品的族谱源头:HBase、Cassandra、MongoDB 的分片设计、Riak、 Voldemort……都能在其中找到血统。Cassandra 尤其有趣——它由 Facebook 在 2008 年开发,直接把 Bigtable 的数据模型和 Dynamo 的分布式协议拼在了一起,2009 年开源后成为 Apache 项目,后来在 Netflix、苹果等公司撑起超大集群。
图:NoSQL 兴起时间线(2004–2010)
演练:一条成本曲线的完整推演
纸上谈兵不如算一笔账。假设你的电商平台业务增长,数据库压力每年翻倍,现在单机 MySQL 已经到顶,有两条路。
背景:3 亿用户,订单表 8 亿行,大促峰值写入 4 万行每秒,日常查询以"我的订单"为主。
操作(垂直路线):采购一台 128 核、4TB 内存的高端服务器迁移现有库。迁移本身顺利,但询价结果是一年预算的七成。更麻烦的是第二年业务再翻倍时,市场上没有现成的更大机器可买——这条路的尽头是断崖。
操作(水平路线):按用户 ID 把订单拆到 16 台普通服务器,每台只扛十二分之一的写入。应用层要维护"哪个用户在哪个分片"的路由表,跨用户的运营统计查询需要汇总 16 个分片的结果。改造花了两个迭代周期,还修出了两个路由缓存导致的错查 bug。
结果与解读:水平路线的硬件成本只有垂直路线的六分之一,且容量可以随业务线性增长;代价是复杂度从数据库层转移到了应用层——路由、跨片查询、副本一致性全要自己操心。2000 年代末的工程师面对的正是这道选择题,而 NoSQL 的答案是:把路由、副本、故障转移做成存储系统本身的能力,应用层只管用。理解了这个来龙去脉,你就理解了为什么 MongoDB 有 mongos 路由、为什么 Cassandra 无主架构没有中心协调节点——它们都是对这道选择题的产品化回答。
变式:如果业务增长不是来自数据量,而是来自查询的复杂度(比如运营要各种报表交叉分析),两条路线都不合适,正确答案可能是数据仓库。这提醒我们:水平扩展解决的是"量"的问题,不解决"复杂"的问题。
易错点
最常见的误解是把 NoSQL 兴起归因于"关系型数据库技术不行"。事实是当时的关系型数据库在单机能力上依然优秀,问题出在商业模式与硬件路线:高端单机的价格曲线追不上数据增长曲线。第二个易错点是忽视两篇论文的差异——Bigtable 选择了强结构、按行键有序的组织方式(后来演化为列族门派),Dynamo 选择了可用性优先的键值模型(后来演化为键值门派)。两者哲学不同,学习时不加区分就会把 Cassandra 和 Redis 的设计理由张冠李戴。
三次流量浪潮与三次数据库改朝换代
NoSQL 不是某个人拍脑袋的发明,它是三次基础设施压力依次传导到数据层的结果。把浪潮与产物对照起来看,产品的设计取向就不再是"风格",而是"当时被逼到墙角的那个瓶颈"。
| 浪潮 | 时间 | 压力来自哪里 | 关系型库顶不住的地方 | 催生的产物 |
|---|---|---|---|---|
| Web 2.0 与 UGC | 2000 年代中后期 | 用户产生内容,数据量与并发双涨,页面结构天变 | 单机垂直扩展贵且到顶;表结构频繁改动 | 键值与文档库、分布式文件系统与 MapReduce 思路 |
| 移动互联网与社交 | 2010 年前后 | 亿级用户的读写混合、关系图谱化 | 多表关联在海量关系上代价失控;强一致拖慢写入 | 列族库、图数据库、宽列存储 |
| 物联网与实时化 | 2010 年代后期至今 | 设备按秒上报、监控指标、向量检索 | 时序写入吞吐与按时间窗口聚合;高维相似性检索 | 时序库、搜索引擎、向量库 |
三次浪潮的共同点值得单独拎出来:每一次都不是"关系型不好用了",而是"某一类负载在特定量级下变得不经济"。关系型数据库至今仍是账务、库存、核心交易的首选——NoSQL 抢走的是那些"量大、结构松、模式单一"的边缘负载,只是后来这些边缘长成了主体。
这也解释了为什么 NoSQL 的产品形态如此多样:键值解决的是"按主键快速存取",文档解决的是"结构常变且一次读完",列族解决的是"海量写入与按列族扫描",图解决的是"多跳关系",时序解决的是"按时间窗口聚合"。门派之分,是负载之分。选型时先问"我的负载像哪一种",比问"哪个产品最火"靠谱得多。
优势的四条来源
把各种 NoSQL 产品拆开,优势大致来自四条技术路径,它们常常叠加出现:数据模型贴合访问模式(不再强制把对象拆成十张表再 JOIN)、把分布式当成默认前提(分片与复制内建而非外挂)、放宽一致性换吞吐(允许短暂不一致以换取写入可用)、针对单一负载做深度优化(时序的时间分区、向量的近似索引)。四条路径各自有代价——后面 1.4 节逐条清算。
本节要点回顾
- 3V(规模、形态、速度)是 NoSQL 兴起的三股原始压力,各自对应不同的技术需求。
- 垂直扩展的成本曲线陡峭且有物理天花板,水平扩展便宜但要自己处理分布式复杂性。
- Bigtable 论文贡献了宽表数据模型,Dynamo 论文贡献了无主复制与最终一致性,二者构成 NoSQL 的双源。
- NoSQL 运动的本质是把分布式复杂性下沉到存储系统内部,而非发明全新的数学。
- 选择扩展路线前先分清压力来自"量"还是"复杂",两者解法完全不同。