1.4 NoSQL 的四大特点与代价
1.4 NoSQL 的四大特点与代价
前三节完成了"是什么、为什么、和谁比",本节把第 1 章收束为一份资产清单:NoSQL 的四大特点,以及每个特点背后对应的价格。它是第 2 章门派总览前的最后一站——带着"收益必有对价"的眼光去看门派,才不会被宣传页上的漂亮数字迷惑。
学习目标
阅读完本节,你应当能够:
- 说出四大特点的准确定义与适用条件;
- 对每个特点指出至少一种典型代价;
- 用"特点 × 代价"框架快速评估一个新产品宣传的真实含金量。
一、灵活模式:自由的边界
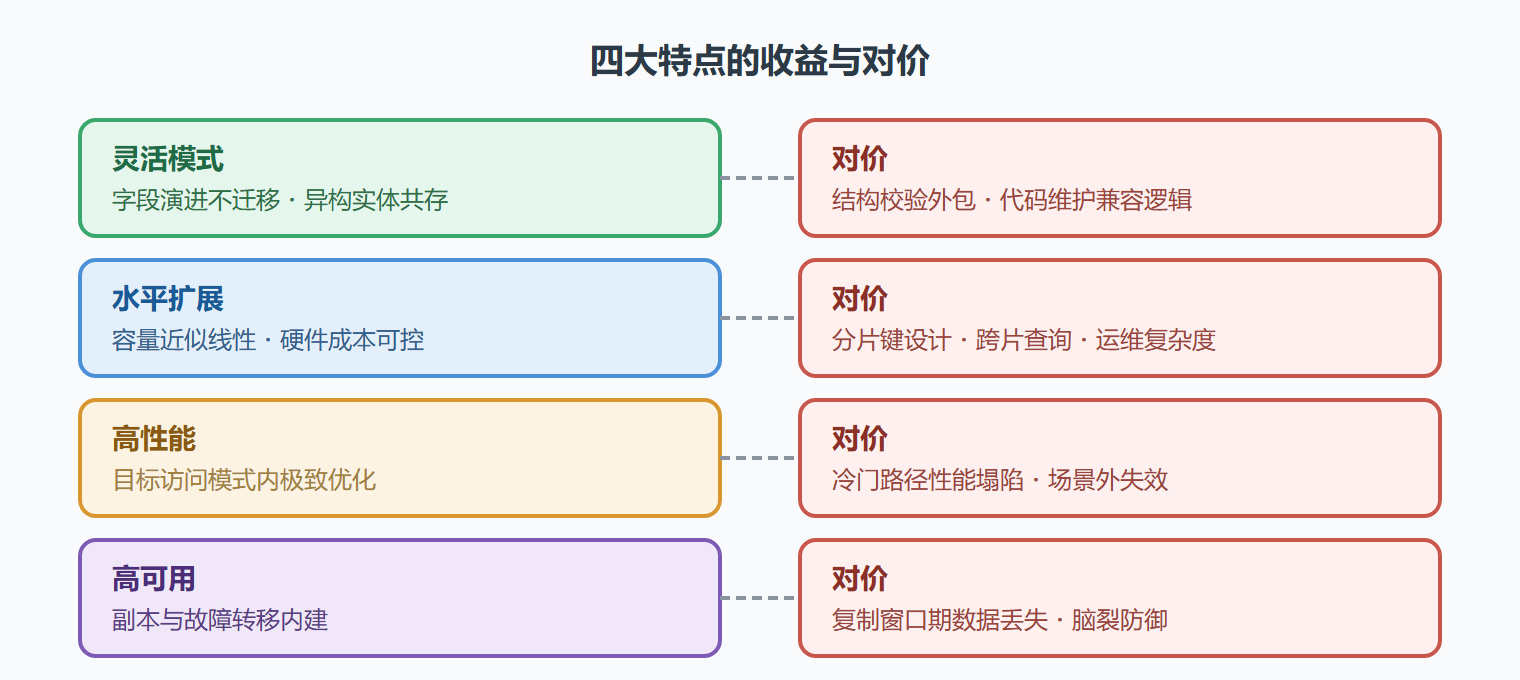
第一个特点最常被误解,需要先说清楚它不是什么。灵活模式不等于"没有结构"——数据当然有结构,只是结构由应用代码定义与校验,而非由数据库强制。同一个集合里,昨天的文档没有"等级"字段,今天的文档可以有,数据库不会拒绝。
这条特性兑现价值的场景很具体:字段随业务高频演进、不同实体差异较大(如商品的品类属性)、需要接纳不可预知的上游数据(如埋点日志)。反过来的场景要冷静:核心交易数据(订单、账务)字段演进并不频繁,历史数据还要求跨年口径一致,此时灵活模式不仅无用,反而失去了数据库帮忙把关结构这层保险。
代价方面有两笔账。其一,结构校验外包给了应用,写错字段名不会报错,脏数据静默积累,直到某天查询结果诡异才暴露;成熟团队的做法是在应用层加 schema 校验库,或使用 MongoDB 后来提供的可选 schema 校验规则。其二,文档内部结构的演进需要维护策略——老文档缺少新字段时,代码要兼容"有"与"没有"两种形态,这个兼容逻辑常常比改表结构更琐碎。
二、水平扩展:把规模变成加法
第二个特点在 1.2 节已经铺垫过:数据与负载分摊到大量普通机器,容量增长近似线性。这里要补充的是它的运行细节与代价。
水平扩展不是免费的加机器。分片要选键(选不好数据倾斜,一片烧其他片闲);跨分片查询要在协调层聚合;集群拓扑变更时数据要再平衡,期间性能抖动。此外,运维复杂度是实打实的:从管理 1 台数据库到管理 30 台数据库节点,监控、备份、升级、故障排查的工作量不是 30 倍线性增长,但绝不是加法那么简单。中小团队常常低估这笔运维账,结果"为了省硬件钱多雇了半个运维"。
三、高性能:针对访问模式的引擎特化
第三个特点的解释藏在"针对"二字里。NoSQL 产品通常只为一两种访问模式做极致优化:Redis 把数据放在内存、用单线程避开锁竞争,换档操作的延迟低到亚毫秒;Cassandra 的存储引擎为顺序追加写优化,写入吞吐碾压随机写的 B+ 树引擎;MongoDB 的文档聚簇存储让"读一个实体"只需一次 IO。
特化的另一面是冷门路径的性能塌陷。Redis 上跑一个需要全量扫描的报表,性能会差得让人怀疑人生;Cassandra 上做跨分区关联查询同样是灾难。高性能承诺只在它设计预想的访问模式内有效,出了这个范围,关系型数据库的通用性反而占优。这就是为什么 1.3 节反复强调"查询模式稳定"是选 NoSQL 的前提。
四、高可用:冗余是设计出来的
第四个特点是多数 NoSQL 产品把副本与故障转移内建为默认配置:写入自动复制到多个节点,主节点宕机时集群自动选出新主,应用几乎无感。相比之下,传统关系型数据库的高可用方案长期依赖外部组件与人工预案。
高可用同样有对价。副本之间的同步策略决定了故障时可能丢失多少数据(异步复制的窗口期数据会丢);自动故障转移期间可能出现短暂的双主(脑裂),需要配置仲裁与最小副本写入来防御。第 3 章的 CAP 定理会把这笔账算得更精确。
图:四大特点与对应代价
演练:用框架审视一个新产品的宣传页
把四组"特点 × 代价"当作分析工具,演练一次真实场景。
背景:团队在技术评审会上看到某新存储产品的宣传:无模式、水平扩展到千节点、百万级写入每秒、五个九可用性。
操作:逐条追问。无模式——结构校验靠什么兜底,有没有 schema 校验选项?千节点——分片键如何设计,支持在线再平衡吗,跨片事务呢?百万写入——这个数字对应的访问模式是什么,随机读性能呢?五个九——副本协议是同步还是异步,故障转移的判定超时多长?
结果:追问之下厂商承认百万写入是顺序追加场景、五个九依赖异步复制、跨片事务尚不支持。
解读:宣传页的每个数字都可能是真的,但都绑定着前置条件。"特点 × 代价"框架的价值就是把前置条件逼到台面上,让你在评审会就能判断这产品适不适合自己的业务,而不是上线三个月后用事故来验证。
变式:把同一套追问用于老产品同样有效。MySQL 八零年代以来的 ACID 承诺也有前置条件:串行化隔离级别下的吞吐代价、单机写容量的天花板。框架是中立的,对谁都别迷信。
代价清单:四条特点逐条量化
特点讲完,把账单也摊开。每一条特点都有对应的隐藏成本,评审会上要能说出这笔账怎么算。
| 特点 | 直接收益 | 隐藏代价 | 常见缓解手段 |
|---|---|---|---|
| 灵活模式 | 加字段零迁移,迭代快 | 约束责任转移到应用;脏数据难发现 | 文档级校验规则;写入前统一走领域层;定期数据质量扫描 |
| 水平扩展 | 加机器即加容量 | 分片键选错难改;跨片查询与事务复杂 | 上线前统计查询分布定键;逻辑片预留;避免跨片强一致流程 |
| 放宽一致性 | 写入吞吐与可用性提升 | 读旧数据、丢失更新、需要冲突解决 | 按数据重要性分级:核心数据强一致,派生数据最终一致 |
| 针对性优化 | 单一负载做到极致 | 通用能力弱(如关联查询、即席分析) | 一主多副本同步到专用引擎(搜索/时序/数仓) |
表里最容易被低估的是第一行。灵活模式在团队规模小、规范强时是巨大优势;在团队快速扩张、代码质量参差时,它会以"同一个集合里混着三种结构的历史文档"的形式反噬。此时补文档校验规则的成本,远高于一开始就约好字段约定。
第二行的最贵代价是分片键不可逆。分片键是在数据量还小的时候定下的,等发现查询模式与键不匹配时,改键等于全量重分布。因此选键这件事值得单独开一次评审,输入是真实的查询统计,而不是架构师的直觉。
什么时候明确不该用 NoSQL
四条反向信号,命中任意一条就该重新考虑:
- 业务依赖跨实体的强一致事务(转账、库存扣减、账务对账)——这类需求在关系型里是内建的,在 NoSQL 里是附加成本;
- 查询模式无法预先确定(分析师要反复即席探索)——文档与键值库都要求"先知道怎么查,再决定怎么存",与即席分析天然冲突;
- 数据量根本不大(百万行以内、单机轻松承载)——引入分布式只是增加运维复杂度,收益为零;
- 团队没有对应的运维能力——分片集群、副本集选举、数据重平衡的排错都需要专门经验,没有人不熟就上生产。
这四条加起来可以浓缩成一句:NoSQL 是为特定规模与特定负载准备的工具,不是关系型的升级版。把它当升级版用,代价会在第二年集中兑现。
本节要点回顾
- 灵活模式把结构责任转给应用,收益是演进速度,代价是校验与兼容逻辑。
- 水平扩展让容量成为加法,代价是分片设计与运维复杂度上台阶。
- 高性能绑定特定访问模式,出了设计场景会塌陷,选型先画出自己的访问模式。
- 高可用内建是常态,但复制协议与脑裂防御的细节决定故障时的真实表现。
- 四组"特点 × 代价"是评估任何存储产品宣传的通用框架。
四大特点在不同门派身上的表现强度并不相同——键值门派把性能推到极致,列族门派把写入吞吐推到极致。第 2 章开始逐派拜访。