1.3 NoSQL 与关系型数据库的正面对比
1.3 NoSQL 与关系型数据库的正面对比
有了定义(1.1)和历史(1.2),本节把两代数据库放在同一张桌面上逐项对比。这张对比表是你今后做选型时用得最久的工具,第 2 章每个门派小节的"实战取舍"都会回到这里校准。
对比要用维度,不要用印象
"哪个更好"是个无效问题,有效的问法是"在哪些维度上各自占优"。下面这张表列出六个核心维度,是本节的主线。
| 维度 | 关系型数据库 | NoSQL 数据库 | 说明 |
|---|---|---|---|
| 数据模型 | 二维表,行列严格 | 键值、文档、列族、图等多样 | 模型决定查询能力的天花板 |
| 模式约束 | 写入前必须定义表结构 | 松散或无模式,结构由应用约束 | 迭代快的业务收益明显 |
| 扩展方式 | 以垂直扩展为主,分布式是后加的 | 原生水平扩展,分片内建 | 大规模数据的分水岭 |
| 事务能力 | 完整 ACID,跨行跨表 | 局部原子性为主,跨节点事务有限或有代价 | 金融账务场景的硬约束 |
| 查询能力 | SQL 通用且强大 | 各派专用 API,弱于通用查询 | 分析型需求慎选 NoSQL |
| 一致性默认 | 强一致 | 可调,常见默认为最终一致 | 影响 业务正确性设计 |
表格之外,有三个维度值得展开,因为它们最容易在选型时被误判。
事务的真相。关系型数据库的 ACID 不是魔法而是成本:为了在并发与故障下保持正确,它付出了锁、日志与两阶段提交的复杂度。NoSQL 普遍的取舍是把范围缩小——MongoDB 保证单文档操作的原子性,Redis 保证单命令与 Lua 脚本的原子性。当你的业务正确性只落在单个数据单元内(比如一个计数器、一份用户资料),这些局部原子性就够用;一旦业务要求跨单元一致(转账、扣库存加下单),就要认真掂量。第 3.4 节会讲如何在 NoSQL 里用模式与流程弥补事务短板。
查询能力的真相。SQL 的价值在于"数据放进去时不知道将来会怎么查"。NoSQL 各派普遍采用查询优先设计:建模时就假定访问路径,数据形状为已知查询定制。这带来极高的可预期性能,但也意味着"新来一个统计需求"可能要求重新建模。判断标准很朴素:查询模式稳定可预见,选 NoSQL 常常赚;查询模式多变,关系型更稳。
一致性的真相。最终一致性不等于"数据是错的",它承诺的是"停止写入后,经过有限时间,所有副本趋于一致"。期间不同客户端可能读到不同版本。这影响的是业务逻辑的写法:付款后立刻刷新页面看不到订单状态,是最终一致系统的正常现象,业务流程必须容忍或规避它。第 3.3 节会给出更细的一致性级别阶梯。
演练:一个电商系统的拆分决策
用一个完整案例演练这套对比方法。
背景:一个中型电商平台,包含订单、库存、商品详情、购物车、会话、商品评价六个模块,日均订单百万级,大促峰值写入压力集中在库存与订单。
操作:逐模块套用六维对比表。订单与库存涉及跨模块的金额与数量正确性,事务能力是硬约束,留在 MySQL;商品详情字段因品类而异(手机有存储容量,衣服有尺码),模式约束维度上文档模型明显占优,迁到 MongoDB;购物车与会话是典型键访问、容忍偶发丢失,放 Redis;商品评价量大、按商品维度聚合读取,用 MongoDB;历史订单归档按时间范围扫描,尝试列族模型(第 2 章展开)。
结果:MySQL 承担 30% 的写入压力但 100% 的资金正确性;MongoDB 承担商品与评价的灵活结构;Redis 把会话读写从数据库剥离,大促期间数据库连接数下降一个数量级。
解读:注意这个结果不是"NoSQL 赢了",而是每个模块按照自己的访问特征选了合适的武器。选型错误的常见形态恰恰是全盘替换——把订单也搬进 NoSQL,然后用应用代码重新实现一遍事务,又慢又容易错。
变式:如果公司规模很小、团队只有三个人,六个模块全用 PostgreSQL 是更合理的起点——运维一种数据库的认知成本,常常超过 NoSQL 带来的单点收益。架构选择永远要乘上团队规模这个系数。
混合持久化:行业默认答案
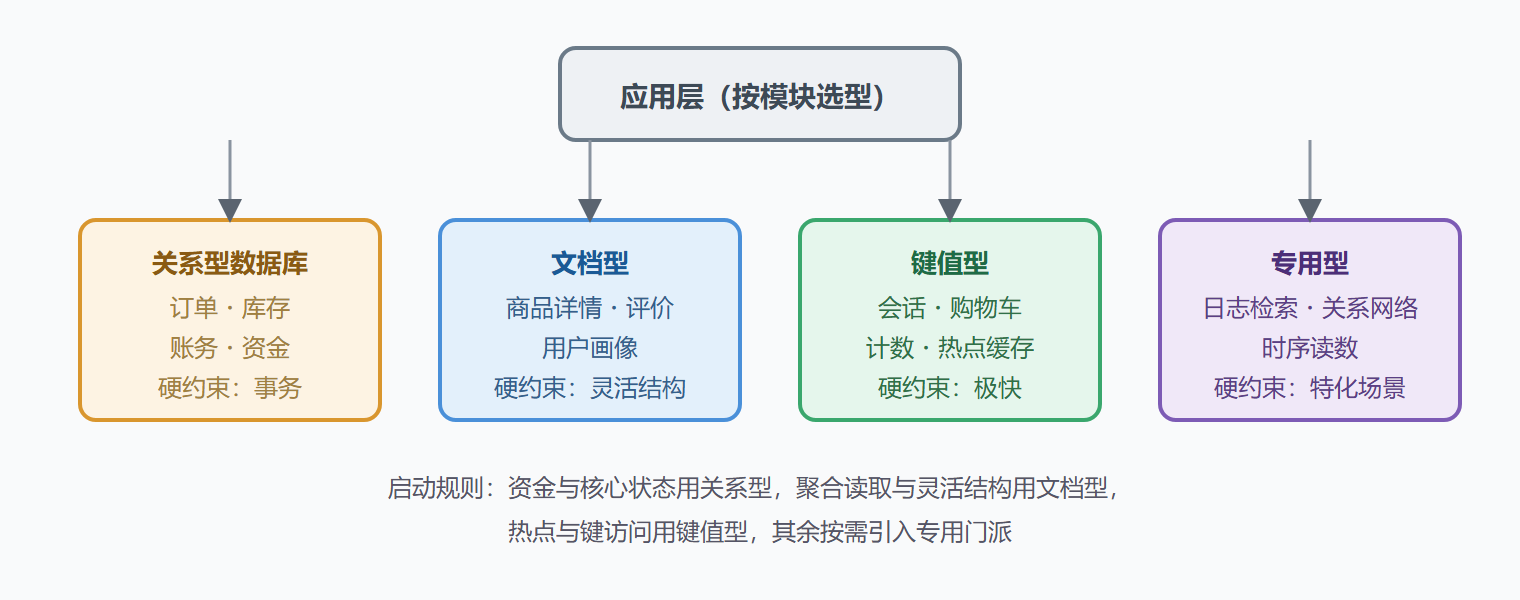
前述案例的思路在业内有个正式名字:混合持久化(Polyglot Persistence)。它是 2000 年代末"用一种数据库解决所有问题"理念碎裂后的新常态。实践中有个粗糙但好用的启动规则:资金与核心状态用关系型,聚合读取与灵活结构用文档型,热点与键访问用键值型,剩下按需引入图、时序等专用门派。规则不完美,但它迫使你在每个模块上做一次显式决策,而不是跟着框架默认值走。
图:混合持久化的典型分工架构
FAQ
问:报表与分析需求怎么办,NoSQL 都不适合吗? 不绝对。文档型数据库的聚合框架可以承担中等复杂度统计(第 4.7 节),列族数据库配合计算引擎是大数据分析的常客(第 2.3 节)。真正不适合的是"任意维度即席查询",那是 OLAP 与数据仓库的主场。
问:关系型数据库现在也支持 JSON 字段了,还有必要用文档型 NoSQL 吗? JSON 字段让关系型数据库具备了部分灵活模式的优点,轻量场景确实够用。但文档型数据库的索引、分片、副本机制都是围绕文档模型设计的,在文档规模与写入吞吐显著上升时优势会拉开。小规模用 JSON 字段,大规模上文档库,是常见的演进路径。
逐项对账:同一需求在两种库里的写法
抽象的比较容易流于口号,把同一个需求在两种库里各写一遍,差异才是具体的。以"订单 + 订单明细"为例。
需求一:读一个订单的完整信息(含明细)。
-- 关系型:三表关联,一次查询但要 JOIN SELECT o.id, o.total_amount, oi.item_name, oi.quantity, oi.price FROM orders o JOIN order_item oi ON oi.order_id = o.id WHERE o.id = 90001;
// 文档型:明细嵌入订单文档,一次主键命中,无 JOIN db.orders.findOne({ _id: 90001 }); // 返回:{ _id: 90001, total_amount: 268.00, // items: [ { item_name: "台灯", quantity: 1, price: 199.00 }, ... ] }
前者灵活、无冗余,后者快、但要接受嵌入带来的冗余与更新放大。
需求二:给订单加一个字段(比如"配送方式")。 关系型要 ALTER TABLE——数据量小时无所谓,亿级行的加列可能锁表数小时,于是有了在线改表工具这一整类基础设施。文档型直接写入新字段,老文档没有这个字段时读到 null,应用侧做兼容即可。注意这不是白吃的午餐:没有 schema 约束意味着约束责任转移到了应用代码,写错了没人拦你。
需求三:按城市统计上月销售额。 关系型一条 GROUP BY 即可,且保证读到的是当前一致的数据。文档型用聚合流水线也能做,但涉及跨分片时,聚合要在协调节点归并,一致性与延迟都要重新评估。
-- 关系型:语义清晰,优化器成熟 SELECT city, SUM(total_amount) AS gmv FROM orders WHERE created_at >= '2026-08-01' AND created_at < '2026-09-01' GROUP BY city ORDER BY gmv DESC;
对账的结论不是"谁更好",而是两者的成本结构不同:关系型把复杂度放在建模与迁移(前期成本高、后期稳),文档型把复杂度放在应用侧的数据治理(前期快、后期要靠规范兜底)。
混合持久化的落地方式
现实中主流做法是分域而治:交易与账务域放关系型(要事务、要对账),内容与目录域放文档型(结构常变、读多写少),会话与计数放键值(要快、可丢),检索与推荐放搜索/向量(要相关性)。多个库之间靠事件(消息队队列或变更数据捕获)同步。
落地时要先想清楚两件事:一是跨域的一致性怎么保证——通常接受最终一致,并设计对账与补偿;二是谁是全量数据的权威源——每个业务实体必须有且只有一个权威源,其余都是派生副本,否则数据不一致时无从裁决。这两条想清楚了,混合持久化是收益最大的架构选择;想不清楚,它就是分布式事故的培养皿。
本节要点回顾
- 选型看六维对比:模型、模式、扩展、事务、查询、一致性,禁止笼统谈好坏。
- 事务缩小范围是 NoSQL 的核心取舍之一,业务正确性落在单数据单元内才划算。
- NoSQL 多为查询优先设计:查询模式稳定是它的舒适区,多变查询是关系型的舒适区。
- 最终一致性要求业务流程显式容忍短暂不一致,而不是假装它不存在。
- 混合持久化是行业默认答案:按模块访问特征选武器,警惕全盘替换。