2.1 键值门派:字典哲学与极致速度
2.1 键值门派:字典哲学与极致速度
门派巡礼第一站是键值存储——NoSQL 家族里模型最简、历史最久、性能上限最高的一个门派。本节先建立它的心智模型,后面第 5 章将以 Redis 为样本再深入八节;两处的关系是"地图与实地",本节负责让你在选型地图上一眼认出这派的地盘。
历史动因:一个哈希表能走多远
键值模型的祖师爷是计算机科学里最古老的数据结构之一——哈希表。它的信条只有一条:给定一个键,以常数时间找到对应的值。至于值里面是什么,字典不关心。
把这个信条从单机内存搬到分布式集群,就是键值数据库的全部野心。1990 年代末到 2000 年代初,动态网站开始把热点数据缓存在内存里来给数据库减负,Memcached 在 2003 年应运而生——它把多台机器的内存拼成一个巨大的分布式哈希表,键值模型因"缓存"这个身份第一次大规模落地。2007 年 Amazon 的 Dynamo 论文则证明了同一模型可以承担更严肃的职责:购物车这种不容丢失的数据,也可以用键值模型 + 多副本写扛住全球规模的流量。一条主线是快(Memcached 到 Redis),一条主线是稳(DynamoDB 到 Riak),键值门派的两支血脉由此成形。
数据模型:对值一无所知,是特性不是缺陷
键值存储的世界里只有两种实体:
键 key -> 值 value "user:1001" <会话的二进制序列化数据> "sku:88312" <商品详情 JSON 文本> "cfg:limit" <"200">
键是字符串或二进制,负责定位;值是一个不透明的大对象,数据库不理解、不解析、不索引它的内部。这个"一无所知"带来三个直接推论:
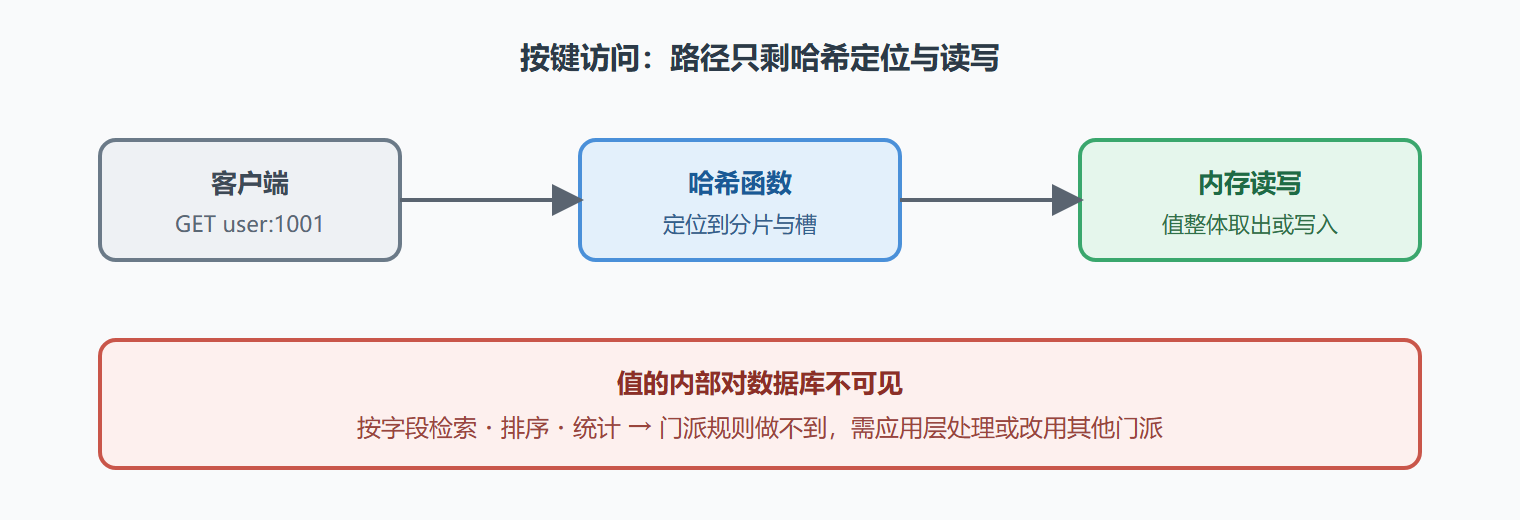
- 性能天花板极高——数据库不做解析,路径只剩"哈希定位 + 读写",Redis 单节点可以轻松跑出十万级每秒操作;
- 查询能力为零——想按"值里面的某个字段"检索?门派规则是做不到,只能自己维护倒排索引或全量扫描;
- 模型简单到极致,复杂度全部转嫁应用——值内的结构演进、关联、校验,都是应用代码的事。
理解这三条推论,键值门派的适用边界就自动浮现:按键访问、模式简单、要求极快的数据最适合;需要按内容检索的数据,请看 2.2 的文档门派。
代表产品
| 产品 | 血统 | 定位 | 典型用法 |
|---|---|---|---|
| Memcached | 缓存起家 | 纯内存、多线程、无持久化 | 页面片段与查询结果缓存 |
| Redis | 内存数据结构服务器 | 丰富数据类型 + 可选持久化 + 主从 | 缓存、会话、排行、锁、消息 |
| DynamoDB | Dynamo 论文 | 云上托管、按量计费、可调一致性 | 购物车、元数据、游戏状态 |
三者定位差异值得多说两句。Memcached 是纯粹的缓存:进程重启数据即消失,数据类型只有字符串,胜在实现简单、多线程吞吐平稳。Redis 把键值模型向上长了一层——值可以是列表、哈希、集合、有序集合等结构,并附带持久化与复制能力,因此从"缓存"升格为"数据结构服务器",这也是它成为门派代表的原因,第 5 章整章都在拆解它。DynamoDB 则把 Dynamo 论文的分布式协议做成了托管服务,用户不操心分片与副本,代价是被绑定在特定云生态里。
演练:会话存储迁移的完整过程
背景:一个日活百万的网站,用户会话原本存在单机 MySQL 的 sessions 表,高峰期登录接口大量超时——每次请求都要查一次会话表,数据库 CPU 被读压满。
操作:第一步改造登录写入:生成会话后,以 sess:<token> 为键把用户信息序列化为 JSON 写入 Redis,并设置 30 分钟过期时间(TTL);第二步改造请求校验:每个请求按 token 拼键去 Redis 取会话,命中则放行;第三步处理过期续期:校验成功时顺手把 TTL 重置回 30 分钟,实现滑动过期;第四步兜底:Redis 不可用时降级为只读校验签名,保证核心下单链路不受影响。
结果:会话读取延迟从平均 40 毫秒降到 0.4 毫秒,MySQL 会话表读负载归零,登录接口在 10 倍峰值流量下稳定。
解读:这个场景把键值门派三个推论用全了——访问模式是"按 token 定位",天然匹配哈希定位;会话内容自我封闭,不需要按字段检索;TTL(键值门派的标配能力)让生命周期管理无需定时清理任务。三个条件缺一个,就该考虑别的门派:比如运营要按"用户 ID 反查所有在线会话",纯键值就吃力了。
变式:若会话需要承载促销资格等强一致信息,且 Redis 故障不能容忍,可改用 DynamoDB 并把强一致读打开;若团队已有 MySQL 且流量不大,加一层本地缓存也许比引入新组件更划算。键值门派的门槛低,但"引入一个新组件"本身有成本,量力而行。
图:键值访问路径——为什么快、为什么查不了
易错点
新手在键值门派最常犯的两个错误。一是把值当数据库用——往一个 key 里塞一个巨型 JSON,每次修改都整体读出、改完再写回,高并发下既慢又容易互相覆盖;正确做法是拆细键粒度,或改用文档门派。二是忽视键设计——键名是唯一索引,user:1001:cart 这类带层级的命名约定要提前定好,等键量过亿再想规范就晚了。
键值门派的三种典型用法与两个反例
键值模型简单到几乎不用解释:一个键对应一个值,值对数据库是不透明的字节串。简单带来的好处是快与可预测,代价是所有查询都必须先知道键。
# 典型用法一:缓存——带过期时间的查询结果 SET user:profile:90001 '{"nickname":"阿澈","level":3}' EX 3600 GET user:profile:90001 # 典型用法二:计数器与限流——单键自增,原子且快 INCR page:view:article:8801 INCR rate:limit:user:90001:2026090210 EXPIRE rate:limit:user:90001:2026090210 3600 # 典型用法三:分布式会话——把会话状态外置,应用节点无状态 HSET session:abc123 user_id 90001 last_seen 1788000000 EXPIRE session:abc123 1800
三种用法的共性是:键是完整已知的、值是整体读写的。一旦需求偏离这条线,键值门派就开始吃力。
反例一:按值里的字段查询。 想查"等级为 3 的所有用户",键值库不知道值里面有什么,只能全量遍历——这是典型的用法错误,正确的做法是把这类查询交给文档库或搜索引擎,或者在写入时维护一份反向索引(等级到用户 ID 集合的映射),用空间换查询能力。
反例二:把键值库当持久化主库却不做持久化配置。 键值库常被部署成纯内存 + 无持久化,此时它是缓存而非数据库。缓存可以丢,主库不能丢——这个定位必须在架构图上写清楚,否则一次重启就会变成一次数据事故。
判据可以总结成一句话:能用键直接命中、且值不需要被数据库理解的场景,键值门派是最优解;需要"按内容找数据"的场景,请换门派或加索引层。
本节要点回顾
- 键值门派的哲学:哈希定位 + 值不可知,性能天花板由此而来,查询能力也由此归零。
- 两支血脉:Memcached 与 Redis 主打快,DynamoDB 主打稳(可调一致性的托管键值)。
- 适用三条件:按键访问、模式简单、要求极快;要按内容检索就该换门派。
- TTL 是门派标配能力,生命周期管理内建。
- 键设计是唯一需要提前规划的"模式",命名约定趁早。
下一站文档门派:同样是"存一坨数据",它选择理解值的内部结构,用查询能力换掉一部分速度。