2.2 文档门派:理解值内部结构的信徒
2.2 文档门派:理解值内部结构的信徒
键值门派把值当黑盒,文档门派偏要拆开黑盒。本节是巡礼第二站,也是第 4 章 MongoDB 深访的地图页——在那里你将看到这一派最成功的代表被逐层解剖。
历史动因:互联网数据不再是表格
2000 年代中后期,Web 应用要存的数据越来越不像账本:一篇博客有标题、正文、若干标签、变长的评论列表;一个商品有品类专属的属性、图片地址、变体组合。用二维表存这些数据,要么把对象拆得七零八落(多表 + 外键),要么往 varchar 字段里塞序列化字符串(查询能力随之报废)。
工程师们自然想到一个折中:既然对象在内存里是树状的,为什么存储时不保持树状?于是文档模型出现了——数据以 JSON 或其二进制变体(如 BSON)为单位存放,文档内部支持嵌套对象与数组,数据库理解文档结构,可以为内部字段建索引、做查询。CouchDB 在 2005 年前后率先成形,MongoDB 于 2009 年开源后凭借易用的开发体验后来居上,成为这一派的门面。
数据模型:树状文档 + 灵活结构
文档门派的心智模型是"一棵棵独立的树":
{ "_id": "p-88312", "name": "轻量冲锋衣", "category": "outdoor", "attrs": { "size": ["M", "L", "XL"], "waterproof": true }, "tags": ["秋季", "登山"], "stock": { "M": 12, "L": 0, "XL": 5 } }
三个关键特征。其一,文档自我完备:一个业务实体通常聚在一个文档内,读取一次 IO 拿全,无需关联。其二,结构灵活:同集合内文档的字段可以不同,上面冲锋衣文档里的 waterproof 字段,放到图书商品文档里换成 pages 也没问题。其三,数据库懂结构:可以按 attrs.waterproof 建索引、按 tags 包含"秋季"做查询——这是与键值门派的本质分界。
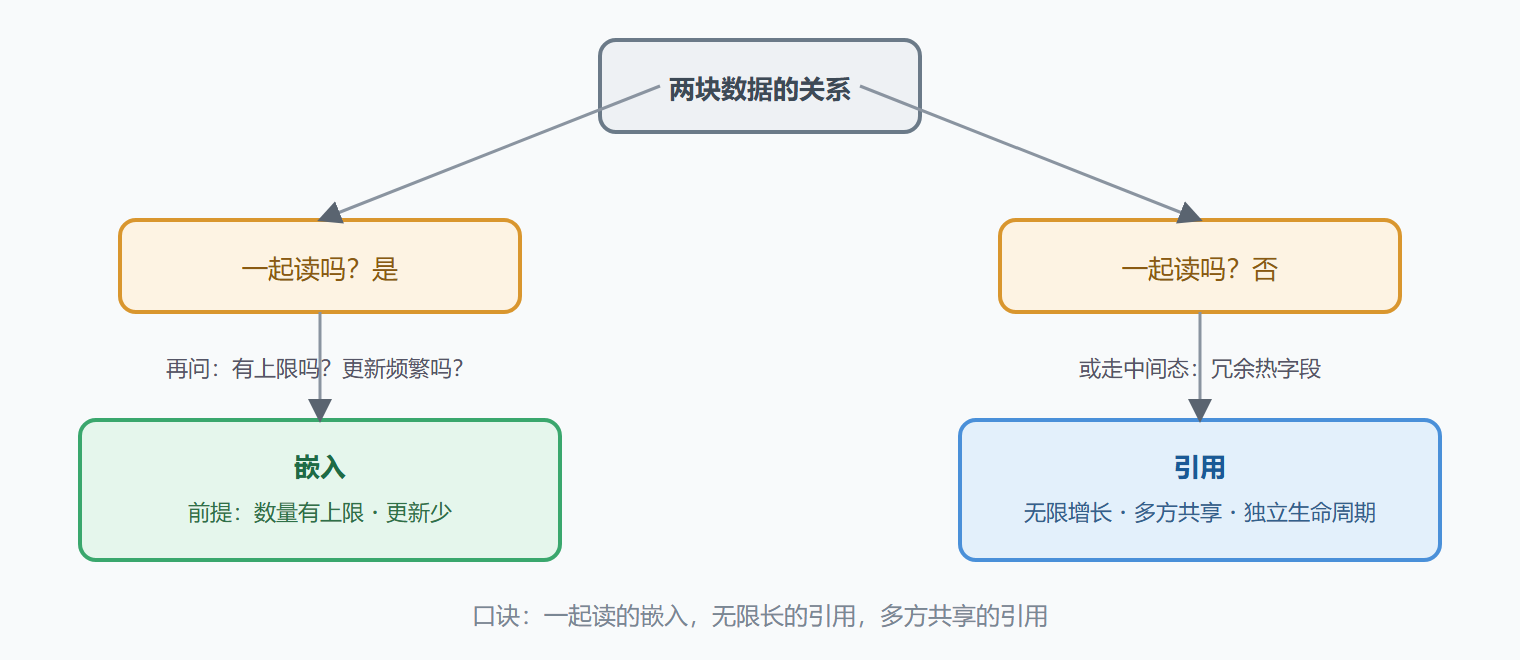
灵活结构带来一个必须直面的问题:相关的数据放一起(嵌入),还是分开存(引用)? 这是文档建模的核心抉择,规则可以概括为"读多且一起读则嵌入,一方变化频繁或无限增长则引用"。比如订单详情适合嵌入订单项(一起读、总量有限),而商品与评价应该分开(评价无限增长,会把商品文档撑爆)。第 3.5 节会把这对抉择上升为通用方法论。
代表产品
| 产品 | 出现年代 | 定位与特色 | 典型场景 |
|---|---|---|---|
| MongoDB | 2009 | 通用文档库,功能最全,生态最大 | 商品、内容、用户画像、IoT 元数据 |
| CouchDB | 2005 | 多主复制、HTTP 接口、离线同步 | 移动端离线优先应用 |
| RavenDB | 2009 | .NET 生态、事务性强 | 企业 .NET 应用 |
MongoDB 的统治地位使得"文档门派"与"MongoDB"在很多语境下成了同义词,第 4 章会完整展开它的数据模型、CRUD、索引、复制集、分片、聚合与事务。这里只点一个容易忽视的差异:CouchDB 的多主复制(任意节点都可写入、数据双向同步)与 MongoDB 的单主复制(只有主节点可写)哲学完全不同,离线优先场景选前者,常规服务端场景选后者。
演练:内容管理系统的建模全过程
背景:一家媒体要做内容管理系统(CMS),文章有几十种字段且不同栏目差异大,编辑要求"明天就要上线新栏目",旧系统因每次加字段都要改表被诟病已久。
操作:第一步选定文档门派,建 articles 集合,文章全部字段聚在一个文档;第二步区分热点与冷数据——正文与基础字段嵌入文档,全文检索交给搜索引擎(见 2.5),评论单独成集合(无限增长);第三步按"编辑后台按栏目 + 状态筛选"的固定查询,对栏目、状态、发布时间建复合索引;第四步上线"视频栏目"新增 8 个字段,直接在发布流程里写入,无需任何结构变更操作。
结果:新栏目上线周期从一周缩到半天;文章详情页一次读取拿到全部展示数据;唯一踩的坑是早期把评论数嵌入文章文档并高频更新,写入冲突频发,改为按需统计后解决。
解读:案例浓缩了文档门派的典型收益路径——字段灵活是显性收益,聚簇读取是隐性收益,而坑也如影随形:频繁更新的计数字段不适合嵌入,这是嵌入与引用抉择的经典反例。
变式:如果需求变成"跨全站所有文章按任意字段组合出报表",文档模型的短板暴露,正确解法是把数据同步到分析引擎,而不是强改文档模型。文档门派服务"已知读路径",别忘了这个前提。
图:嵌入与引用的决策路径
易错点
文档门派最常见的误用是把它当关系型数据库的 JSON 皮肤用——建模时仍然按表思维拆文档、靠应用层做关联,结果两头不占:既没有关系型的关联查询与约束,又放弃了文档模型的聚簇读取优势。第二个高频错误是无节制嵌套:文档嵌套层数过深、数组无限增长,单文档体积上限(MongoDB 为 16MB)触顶或性能劣化。判断口诀:一起读的放进来,无限长的分出去。
文档门派擅长的三种数据形态
文档库把一个对象整体存成一个结构化的值,并且能理解值内部的结构(可建索引、可按路径查询)。这让它在三种数据形态上格外顺手。
形态一:聚合体(Aggregate)。 一个业务对象天然包含若干子对象,且这些子对象总是被一起读取。典型是"订单 + 明细""博客 + 评论""设备 + 传感器读数"。把子对象嵌入父文档,一次主键读取即可拿到全部内容,避免了关系型里的 N+1 查询。
形态二:异构实体。 同一集合里的文档结构可以不同——三十种设备各有各的属性,无需为每种设备建表,也无需用几十个 nullable 列凑合。加一种新设备,只是多一种字段组合。
形态三:结构持续演进的实体。 业务早期字段天天变,文档模型不需要迁移脚本,新旧文档可以共存,应用代码按需兼容。
// 同一集合里两种异构设备文档共存,各带各的字段 { _id: "dev-01", type: "空调", tenant: "t-7", rated_power: 3500, location: { type: "Point", coordinates: [113.6, 34.7] } } { _id: "dev-02", type: "电表", tenant: "t-7", meter_no: "E20190031", readings: [ { ts: ISODate("2026-09-01T10:00:00Z"), kwh: 128.4 } ] }
不擅长的三种情况
深度关联。 文档之间的引用要应用层自己解析,多跳查询代价高。若业务核心是"朋友的朋友""供应链上下游追溯"这类多跳关系,图门派更合适。跨文档的强一致更新。 多文档事务虽然可用,但代价明显高于关系型,能用单文档原子性解决就别开事务。超大规模的即席分析。 聚合流水线适合中等复杂度的统计,海量数据的多维分析应当同步到列式存储去做。
选型时的自检问题只有一个:我的核心查询,是不是"按一个明确的键,把一个对象整体读出来"? 是,文档门派大概率合适;不是,先想清楚查询长什么样再选。
本节要点回顾
- 文档门派 = 树状自完备文档 + 数据库理解内部结构,区别于键值门派的黑盒值。
- 嵌入 vs 引用是建模核心抉择:一起读则嵌入,无限增长则引用。
- 代表产品三足:MongoDB 通用全能、CouchDB 离线同步、RavenDB 绑定 .NET。
- 收益是灵活结构与一次 IO 聚合读取,代价是复杂关联与多变报表弱。
- 把文档库当"带 JSON 的 MySQL"用,是最典型的双输用法。
第三站列族门派:把"行"铺开成"列",为海量写入与稀疏数据而生。