2.5 新兴门派:时序、搜索与向量
2.5 新兴门派:时序、搜索与向量
门派巡礼的最后一站不拜访某一个门派,而是看一片持续扩张的新城区:时序数据库、搜索引擎数据库与向量数据库。它们常被归入广义 NoSQL,共同点是为某一种数据维度做了极端特化——时序特化"时间"、搜索特化"文本语义"、向量特化"高维空间距离"。认清它们的本命场景,能避免用通用数据库硬扛特化负载的经典弯路。
时序门派:时间是主键
物联网设备、监控指标、行情数据有一个共同形状:同一数据源持续追加带时间戳的读数,写入永不停止,读取几乎总是按时间范围。这个形状对通用数据库处处别扭——表无限膨胀、旧数据与热数据抢索引、按时间聚合全表扫描——却与时序门派完美咬合。
时序门派的三个看家本领。时间优先的存储布局:数据按时间分区落盘,写入是顺序追加,读数按时间范围裁剪。高压缩比:相邻读数高度相似,专用的增量与游程压缩常能把原始数据压到几十分之一。数据生命周期内建:保留策略(如"原始数据留 30 天,聚合后留 2 年")与自动降采样是标配,不用写定时清理任务。
代表产品分两个阵营。InfluxDB、TDengine 是独立时序库,生态自成一体;Prometheus 走"拉取式指标 + 内置查询语言"路线,已是云原生监控事实标准。选择上有个朴素规则:监控指标选 Prometheus,业务与设备时序选独立时序库——前者要的是生态与告警体系,后者要的是海量写入与 SQL 式分析。
搜索门派:倒排索引的艺术
"按内容找数据"是键值门派的死穴、文档门派的弱项,却是搜索门派的全部。Elasticsearch(及同源的 OpenSearch、轻量的 Meilisearch)把每个文本字段拆词,建立倒排索引——从词到文档的映射,使"包含某词的文档"从全表扫描变成词表直查。
搜索门派的能力超出关键词匹配:分词与同义词处理中文语料的歧义;相关性打分(如按词频与稀缺度加权)决定结果排序;聚合能力支持分面统计("各分类下命中多少")。工程上的常规搭配是双写模式:业务数据以 MongoDB 或关系型库为准,异步同步到搜索引擎专职检索——搜索库承查询,主库保正确,各司其职。
向量门派:为 AI 而生的距离计算
大模型兴起把向量数据库推到台前。文本、图片经嵌入模型编码后是几百到几千维的浮点向量,"语义相近"表现为向量在空间中距离近。要"在海量向量中找出最近的 K 个"(近邻检索),暴力计算不可行,向量门派的核心武器是近似最近邻索引(如 HNSW 图索引、IVF 聚类索引),用可接受的精度损失换百倍千倍的检索加速。
代表产品:Milvus、Qdrant 等独立向量库功能完整;pgvector 这类扩展则让关系型数据库也能做小规模向量检索。典型用法是检索增强生成(RAG):文档切块向量化入库,用户提问向量化后取最近邻,把命中文段交给大模型作答。小规模场景(百万级以下)用扩展或内存库即可,上亿向量再考虑分布式专用库。
图:三大新兴门派的本命场景对照
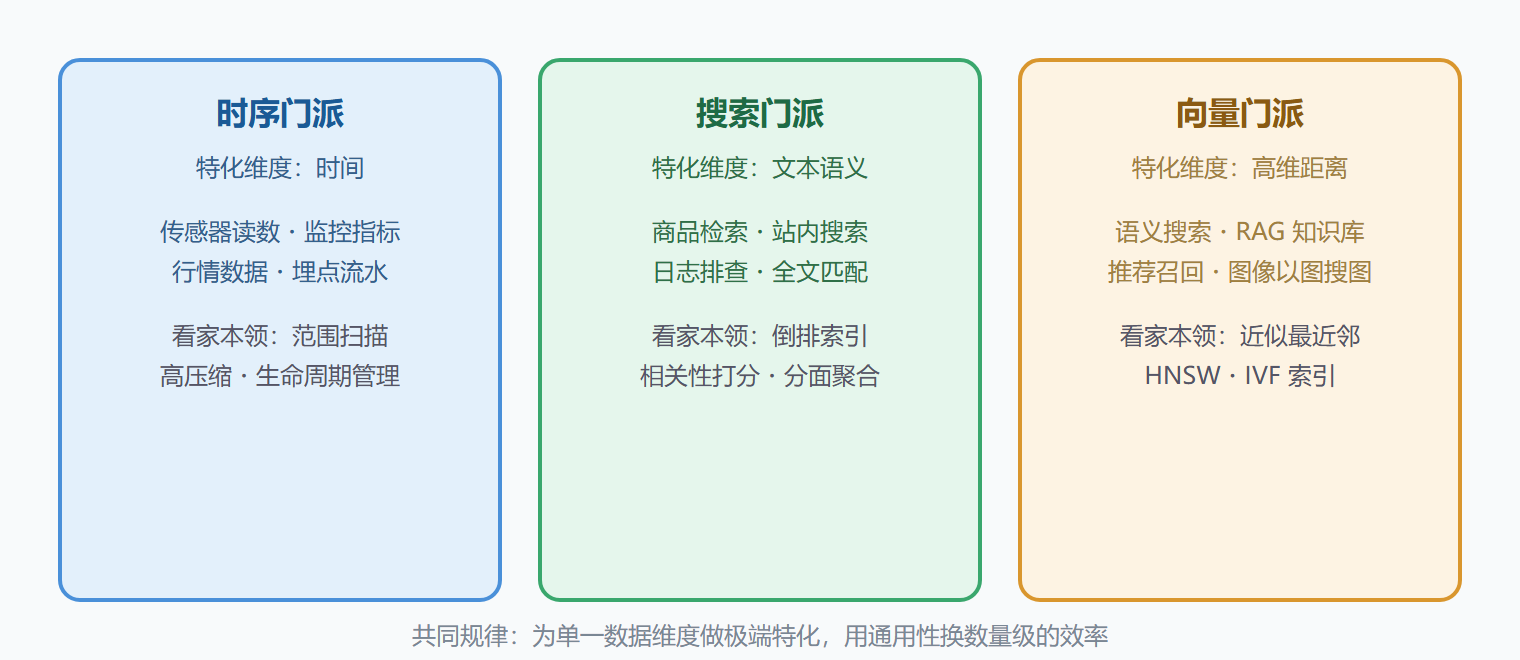
演练:一个日志平台的组件选型
背景:一个中型平台要建日志系统:应用日志每秒约 5 万条,需求是关键字检索(排障用)、按服务与时间聚合(周报用)、原始日志保留 30 天。
操作:评估三个候选。纯 MongoDB:文档模型存日志毫无压力,但 30 天百亿行的关键字检索要自建索引与清理任务,工程量失控。纯时序库:生命周期与压缩对口,但全文检索不是时序门派强项。搜索引擎数据库:倒排索引与分面聚合直接对口前两个需求,30 天保留用索引生命周期管理配置一条规则即可。
结果:采用搜索引擎数据库存储与检索,日志按天建索引、到期自动删除;同时给核心服务的错误日志按分钟聚合成指标写入时序库供告警,两个门派各干各的活。
解读:注意最终方案是组合而非二选一——全文检索交给搜索门派,聚合告警交给时序门派,原始明细只留一份在搜索库。新兴门派的正确打开方式几乎总是这种"各展所长"的流水线,硬要一库通吃反而处处将就。
变式:若日志里要支持"语义相近的故障案例查找"(比如"跟这个数据库连接超时类似的以往案例"),就轮到向量门派出场:日志向量化入库,检索时先关键词后语义,两路结果合并。三个门派在同一条链路上协作,正是 2.5 节想留给你的终局图景。
三派速查表:时序、搜索、向量
三派都是"为单一负载做到极致"的代表,把它们并排看,能更清楚地理解"针对性优化"意味着什么。
| 门派 | 数据形态 | 核心查询 | 关键优化手段 | 代表产品 |
|---|---|---|---|---|
| 时序 | 时间戳 + 指标 + 标签 | 按时间窗口聚合、降采样、最新值 | 时间分区、列式压缩、增量聚合预计算 | InfluxDB、TimescaleDB、Prometheus |
| 搜索 | 文本 + 结构化字段 | 全文检索、相关性排序、聚合分面 | 倒排索引、分词器、打分模型 | Elasticsearch、OpenSearch、Solr |
| 向量 | 高维向量 + 元数据 | 近似最近邻检索、混合过滤 | HNSW、IVF 等近似索引,量化压缩 | Milvus、Qdrant、Weaviate、pgvector |
时序的关键洞察是:时序数据几乎总是按时间范围查询、且旧数据访问频率骤降。于是优化手法都围绕时间——按时间分区让冷数据可以被廉价归档,按时间列式压缩把存储空间压到十分之一,预计算把常用窗口的聚合结果提前算好。若用关系型硬扛每秒百万点的写入,磁盘与索引会先撑不住。
搜索的关键洞察是:用户要的是"相关"而非"精确匹配"。倒排索引把"哪些文档包含这个词"预先建好,检索时只做集合运算;相关性打分(词频、逆文档频率、字段长度归一)决定排序。这套机制与数据库的 B+ 树完全是两条路,因此"在数据库里用 LIKE 做搜索"永远是个错误答案。
向量的关键洞察是:语义相似性可以表达成向量空间里的距离。高维精确检索代价极高,于是近似索引(如 HNSW 的层级图结构)用可接受的精度损失换取数量级的性能提升。向量库通常还与标量过滤配合——先按元数据过滤(租户、时间),再在候选集里做向量检索。
选型时的两条经验
第一,先确认是不是真的需要新引擎。 很多团队在数据量还很小的时候就引入了搜索或向量库,结果多了一套需要运维的分布式系统。PostgreSQL 上的全文检索与 pgvector 扩展,往往能支撑到相当可观的规模——先用扩展,撑不住了再迁移,代价通常小于一开始就上重装备。
第二,把新引擎当派生层。 三派都适合作为主库的派生副本:主库写入后通过变更数据捕获或双写同步到搜索/向量/时序库,查询走派生层。这样主数据的一致性由主库保证,派生层挂了可以重建——这个定位能规避掉绝大部分一致性事故。
本节要点回顾
- 新兴门派的共同哲学:单一维度极端特化,效率提升以牺牲通用性为价。
- 时序看时间布局、压缩比与生命周期内建;监控选 Prometheus,业务时序选独立库。
- 搜索看倒排索引与相关性打分;常规架构是主库保正确、搜索库承查询。
- 向量看近似最近邻索引;小规模用扩展,大规模上专用库,RAG 是头号场景。
- 生产系统里它们常以组合流水线出现,而非单独承担全部存储职责。
五大门派拜访完毕。下一章转入通用内功:无论哪一派,一旦跨入分布式,都要面对同一组法则。