2.4 图门派:关系即数据的信徒
2.4 图门派:关系即数据的信徒
巡礼第四站来到图门派。前三个门派的数据模型再不同,存储的都是"一条条独立的记录";图门派把记录之间的关系抬升为一等公民——在某些问题上,这个视角差异不是优化,而是能不能做的分界线。
历史动因:关系越深,表越痛
关系型数据库用外键与关联查询表达关系,这在两三跳以内是够用的。但当业务开始问"我的好友的好友里,谁和我关注了同一个博主""从这笔付款到那个收款账户,中间隔了几层壳公司""这个变更会影响哪些下游模块"时,表模型立刻露出疲态:每多一跳就多一次代价高昂的连接,四跳以上的关联查询在真实数据量下基本不可用。
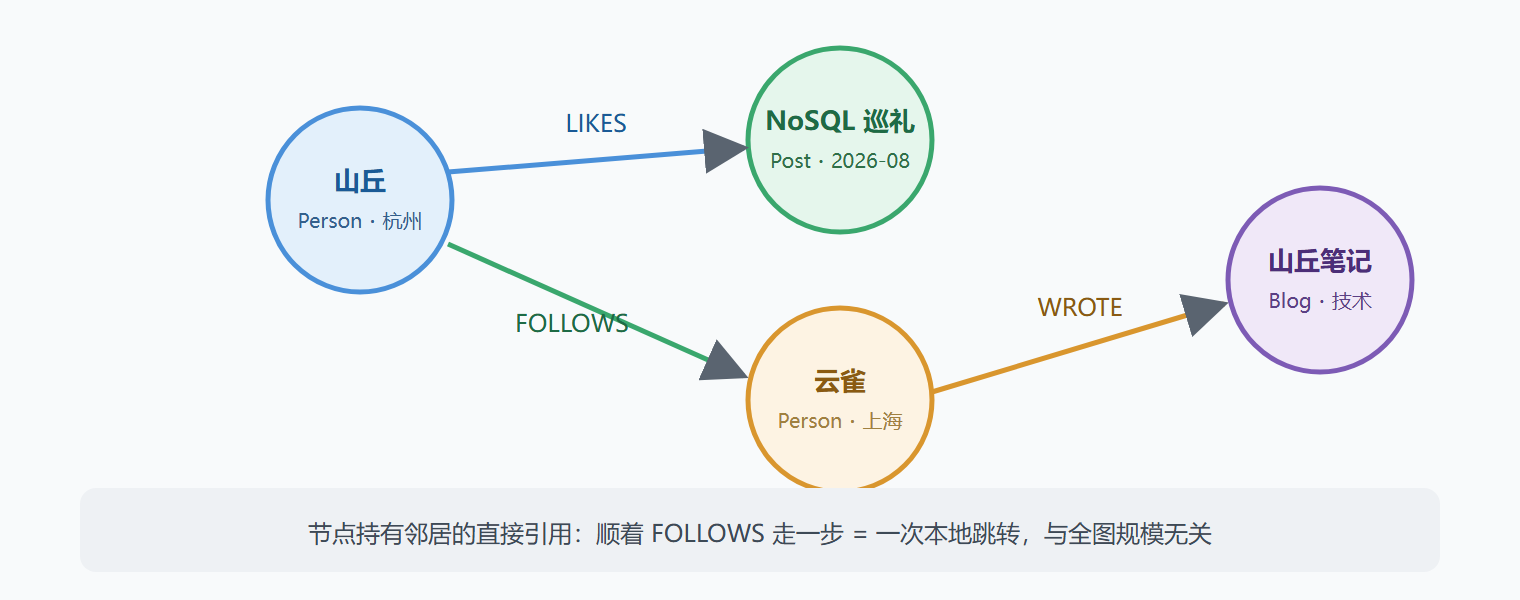
问题根源在于表模型里关系是间接的——它藏在连接条件的计算里,每次查询都要现场计算。图数据库把关系变成直接的物理结构:节点直接持有指向邻居的指针(邻接表),顺着关系走一步就是一次指针跳转,与全图规模无关。Neo4j 于 2007 年发布,是这个门派最著名的代表;同一时期还有更学术谱系的 RDF 三元组存储,但工业界主流是属性图模型。
数据模型:节点、关系与属性
属性图模型只有三个构件,但表达力惊人:
节点(Person) { name: "山丘", city: "杭州" } │ │ 关系 (LIKES) { since: 2024 } ← 关系有方向、有类型、可带属性 ▼ 节点(Post) { title: "NoSQL 巡礼", date: 2026-08 } 同一节点可参与任意多条不同类型的关系
两个与生俱来的特点。方向与类型:关系是命名、有向的实体,"LIKES"与"FOLLOWS"是两条不同的边,语义直接写进数据。无索引邻接:每个节点物理持有与相邻节点的直接引用,遍历邻居不需要全局索引查找——这是图查询"复杂度与全图规模无关、只与遍历范围有关"的原理基础。反过来说,图门派不擅长"从茫茫节点里按属性捞一批",那是索引与倒排的活,通常是文档或搜索门派的任务。
代表产品
| 产品 | 定位 | 查询语言 | 备注 |
|---|---|---|---|
| Neo4j | 通用属性图数据库,门派代表 | Cypher | 原生图存储,可视化工具完善 |
| NebulaGraph | 国产分布式图数据库 | nGQL | 超大图规模、分布式 |
| ArangoDB | 多模型(文档 + 图 + 键值) | AQL | 一个引擎服务多种模型 |
Cypher 值得一提,它用"所见即所写"的 ASCII 图案描述关系,可读性极佳:(a)-[:LIKES]->(b) 读出来就是"A 喜欢 B"。这种声明式图查询的思想后来被标准化的图查询语言 GSQL、ISO GQL 吸收。
演练:二度好友推荐的完整过程
背景:社交应用要做"可能认识的人"功能:推荐与我互相关注的好友们共同关注的人,并标注共同好友数。用户过千万,关系链人均几十条。
操作:在关系型数据库里,这个查询要自连接两三次,好友表千万行时执行计划惨不忍睹,只能预计算落缓存——但预计算本身又是一套任务体系。换图数据库后直接写遍历:
-- Cypher:我好友的好友,且不是我好友,按共同好友数排序 MATCH (me:Person {name:'山丘'})-[:FOLLOWS]->(f:Person)-[:FOLLOWS]->(fof:Person) WHERE NOT (me)-[:FOLLOWS]->(fof) AND fof <> me RETURN fof.name, count(f) AS mutual ORDER BY mutual DESC LIMIT 10;
结果:千万级节点、人均几十条边的图上,该查询在毫秒级返回;遍历只触及我的好友数量级的局部子图,与全图 1000 万的规模无关。
解读:性能来自两个叠加——无索引邻接让每跳是本地跳转;遍历路径被查询本身约束在"二度以内",局部性天然成立。这也解释了图门派的适用判据:问题本质是多跳关系遍历。若是"按城市统计用户数"这类聚合,图模型没有任何优势,老老实实用文档或关系型。
变式:风控场景把同款思路用于资金链路——以账户为节点、转账为边,查"从可疑账户两跳内能到达的账户",正是图门派的本命场景;知识图谱的实体关联查询同理。而如果你的"图"只是层级关系(组织架构树),别用图数据库,一张带父节点字段的表就够了。
图:属性图模型的三个构件与无索引邻接
易错点
最大的陷阱是把图门派当万能库:看到关系就想全部用图表达,结果聚合查询慢、写入吞吐低、团队还要学一门新查询语言。第二个错误是忽视属性索引:图查询虽靠邻接快,但遍历的起点仍需要按属性定位节点,起点定位慢整个查询就慢,常用起点属性要建索引。第三个是无界遍历:不限制深度的变长路径查询在大图上可能吃掉全部内存,任何遍历都要给跳数设上限。
图查询与关系型递归查询的对照
图数据库的核心卖点是"多跳关系查询的代价与跳数弱相关"。这句话听起来抽象,对照着写一遍就清楚了。需求:找出"张三的朋友的朋友中,谁在 2026 年买过相机"。
-- 关系型:递归 CTE,三跳关联,数据量一大就吃力 WITH RECURSIVE friend_of AS ( SELECT friend_id FROM friendship WHERE user_id = (SELECT id FROM user WHERE name='张三') UNION SELECT f.friend_id FROM friendship f JOIN friend_of fo ON f.user_id = fo.friend_id ) SELECT DISTINCT u.name FROM friend_of fo JOIN user u ON u.id = fo.friend_id JOIN orders o ON o.user_id = u.id JOIN order_item oi ON oi.order_id = o.id WHERE oi.item_name LIKE '%相机%' AND o.created_at >= '2026-01-01';
// 图查询:路径模式直接写出来,语义更贴近问题本身 MATCH (me:User {name:'张三'})-[:FRIEND*1..2]-(f:User)-[:PURCHASED]->(:Item {name:'相机'}) WHERE f.purchase_year = 2026 RETURN DISTINCT f.name;
差异不在"哪个更短",而在执行方式:关系型靠 JOIN 与集合运算,代价随数据量与跳数快速增长;图库把关系存成邻接表,遍历时沿边直接走,跳数增加时代价增长平缓。
图门派的适用边界
适合的场景:社交网络与推荐(多跳关系、社群发现)、风控反欺诈(团伙识别、资金链路追溯)、知识图谱(实体关系推理)、IT 与网络拓扑(依赖影响分析)。这些场景的共同点是关系本身就是查询对象——你不只是在查数据,你在查数据之间的连线形状。
不适合的场景:简单的一对多查询(关系型足够了)、大规模批量扫描(图遍历优势用不上)、以及需要强事务的账务(图库的事务能力通常弱于关系型)。此外图库的学习成本与运维门槛都偏高,团队要先确认有没有人能长期维护。
一句实用建议:把图库当成"关系分析层"而非主存储。主数据仍在关系型或文档库里,把关系同步进图库做分析,兼顾事务与分析两头,是落地时最常见的稳妥方案。
本节要点回顾
- 图门派把关系抬升为一等公民,查询是沿关系遍历而非关联计算。
- 无索引邻接是性能原理:遍历成本与全图规模无关,只与局部子图有关。
- 属性图三构件:节点、(有向有类型可带属性的)关系、属性。
- Neo4j 与 Cypher 是门派代表;超大规模分布式看 NebulaGraph。
- 适用判据:多跳关系遍历是问题本质;聚合与即席检索请改道。
最后一站新兴门派:数据的时间维度与语义维度,各自催生了什么。