5.1 Redis 简介与特点
5.1 Redis 简介与特点
深访第一站照例先认识主人:Redis 为什么快到能当缓存的顶配,又为什么自称"数据结构服务器"而不是"缓存"。本节拆它的三个速度来源与定位边界,后面七节的所有机制都建立在这套地基上。
学习目标
阅读完本节,你应当能够:
- 说出 Redis 高性能的三个技术来源,并解释它们各自的代价;
- 复述 Redis 与 Memcached 的定位差异;
- 列举 Redis 在生产中的六类典型用途,判断自家业务该不该上。
出身:一个人写给自己的工具
2009 年,意大利工程师 Salvatore Sanfilippo(网名 antirez)在做一个实时访问统计项目时,嫌现有存储太慢,写了个内存键值服务——取名 Redis(Remote Dictionary Server,远程字典服务)。项目开源后以极简的 API 与惊人的性能在社区爆发,antirez 长期以近乎单人维护的姿态迭代了十年,Redis 也因此带上鲜明的个人审美:命令语义直白、数据结构讲究、代码克制。2010 年起 VMware 与后来的 Redis 公司接手主导,2024 年许可协议变更后社区另立了 Valkey 分支——这段插曲说明它的生态地位已重要到"协议变更都能催生新分支"的程度。
快的三个来源
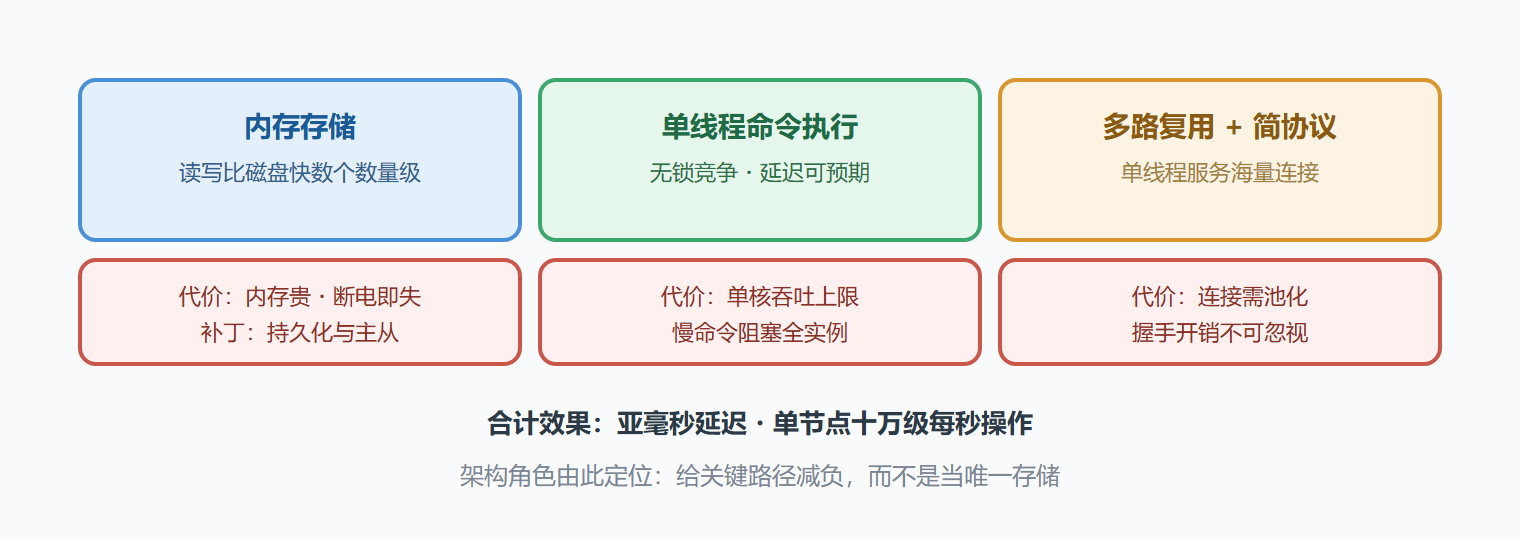
内存存储:数据常驻内存,读写天然比磁盘快几个数量级——这是 1.4 节"高性能"特点的最极致体现,代价是内存贵、容量有限,且断电即失(5.3 的持久化就是为这个代价打的补丁)。
单线程命令执行:命令处理在主线程内串行执行(6.0 起网络读写与协议解析可多线程,命令执行仍是单线程)。串行意味着没有锁竞争,每个操作的完成时间可预期,也意味着所有原子的多步操作(5.6)能靠"排队"天然实现。代价同样直白:单核成为吞吐上限,慢命令(如对百万级大键排序)会阻塞整个实例——"禁用 keys 这种全量扫描命令"由此成为生产铁律。
IO 多路复用 + 高效协议:单线程却服务成千上万的连接,靠的是事件驱动的多路复用机制(同一套思路撑起了 Nginx);通信协议 RESP 极简(文本协议、按行解析),解析开销小。
三个来源合起来的工程意义是:Redis 的性能可预期性极强——亚毫秒延迟、十万级每秒操作(单节点),这个数字决定了它在架构里的角色:给关键路径减负。
图:三个速度来源与各自的代价
定位与典型用途
Redis 与 Memcached 的差异在 2.1 节有一张表,这里补一个判断口诀:要复杂数据结构、持久化、主从、原子脚本选 Redis;只要纯字符串缓存且要多线程大吞吐,Memcached 依然合格。Redis 的六类典型用途:缓存(查询结果、热点数据,5.4 专讲);会话与登录态(2.1 演练的案例);计数与限流(INCR 的原子性天然适配);排行榜(有序集合,5.2);消息队列轻量版(列表与 Stream,5.5);分布式锁(字符串 + 过期 + Lua,5.6)。
演练:给接口加缓存的全过程
背景:商品详情接口直查数据库,大促期间数据库 CPU 冲到 90%,接口 95 分位延迟 300 毫秒。
操作:第一步定位热点——监控显示 80% 流量打在 5% 的商品上,热点集中,适合缓存;第二步写缓存逻辑:请求先查 Redis(GET product:88312),未命中则查库并回写(SET 带 30 分钟过期 + 随机偏移防同时过期),命中直接返回;第三步处理一致性——商品修改时删除对应缓存(先更库后删缓存),下次读取重建;第四步压测验证,命中率的预期是 90% 以上。
结果:数据库 CPU 降到 20%,接口延迟 95 分位 12 毫秒;上线第三天发现少数商品缓存频繁失效(更新频繁的商品),为它们改用短缓存 + 主动刷新策略。
解读:案例里藏着三个通用规律——缓存只救读多写少的数据;过期时间加随机偏移是雪崩防御的最低配版(5.4 展开);"先更库后删缓存"是常用的一致性折中,但极端并发下仍有窗口,强一致数据别靠缓存。
变式:若热点不集中(长尾商品每个只被看一两次),缓存命中率上不去,收益反而覆盖不了引入成本——这时该优化的是数据库索引(4.4)而不是加缓存。缓存不是性能问题的默认答案。
易错点
第一个是把 Redis 当数据库:持久化(5.3)只是保险丝,不是备份体系;核心数据仍要有独立的主存储与备份。第二个是忽视单线程的阻塞面:一次 keys 扫描、一条 O(N) 的大键操作都能让全实例卡顿,大键(百万元素级)要拆分或改用增量遍历命令。第三个是连接与内存裸奔:连接不池化导致频繁握手,maxmemory 不设导致内存吃满后行为不可控——两者都是上线第一天就该配好的参数。
快的四个来源拆解
"Redis 快"是共识,但快在哪、各占多少,很少有人说清。拆开看有四个来源。
| 来源 | 说明 | 贡献 |
|---|---|---|
| 内存存储 | 数据主要在内存,省去磁盘寻道 | 最根本,数量级差异 |
| 单线程执行命令 | 无锁竞争、无上下文切换开销 | 显著,尤其在高并发下 |
| IO 多路复用 | 单线程处理上万连接,事件驱动 | 支撑高并发连接 |
| 高效数据结构 | 为每种类型定制编码(如 ziplist、skiplist) | 省内存、省 CPU |
需要澄清一个常见误解:Redis 的单线程指的是"执行命令"单线程。6.0 起网络 IO 可以多线程,持久化、异步删除等也由后台线程完成。命令执行保持单线程,是为了让每个命令天然原子——这也是 Lua 脚本能保证原子性的根本原因。
实测对照:Redis 与关系型的数量级差异
在同一台机器上,简单键值读写的吞吐通常差一到两个数量级:单机 Redis 轻松跑到每秒十万级简单操作,而同等条件下的关系型数据库在万级上下(且受事务、日志、索引维护拖累)。
# 自带基准测试工具,用于摸清自己机器的量级(不要在生产主库上跑) redis-benchmark -t set,get -n 100000 -q # 输出示例:SET: 112359.55 requests per second # GET: 116279.07 requests per second
数字不是重点,量级才是:Redis 的价值不在"比数据库快一点",而在"把某些负载从数据库的成本中心里彻底剥离出去"。计数、限流、会话、排行榜这些负载,放在 Redis 里几乎不消耗什么,放在关系型里却会吃掉大量连接与 IO。
不擅长的四件事
大 Value 与批量扫描:单线程意味着一个慢命令会阻塞后续所有请求,KEYS * 这类全量遍历在生产上等同于故障。替代方案是 SCAN 系列命令分批迭代。
复杂查询:只能按键访问,没有二级索引、没有关联、没有聚合。需要按内容查询就得自己维护索引结构(集合、有序集合)。
数据量大到内存装不下:内存成本高于磁盘,几十 GB 以上要慎重,通常的做法是热数据放 Redis、全量数据放别处。
强持久化要求:即便开了 AOF 每秒刷盘,也存在一秒的丢失窗口。账务类数据不应以 Redis 为唯一存储。
本节要点回顾
- Redis 的速度 = 内存 + 单线程无锁 + IO 多路复用,代价是容量、单核上限、阻塞敏感。
- 定位是数据结构服务器:五大类型、持久化、主从、脚本,超出"缓存"两个字。
- 与 Memcached 分工:复杂结构选 Redis,纯字符串大吞吐缓存 Memcached 仍可用。
- 缓存只救读多写少且热点集中的数据,否则收益为负。
- 生产三纪律:禁全量扫描命令、连接池化、maxmemory 必设。
认识了主人,下一站看它的数据形态——五种类型各有底层结构,选对了事半功倍。