5.2 五大基础数据类型
5.2 五大基础数据类型
键值门派的值是黑盒(2.1),但 Redis 给黑盒开了五种"规格"——字符串、哈希、列表、集合、有序集合。选对类型不只是代码优雅问题:每种类型背后是不同的内存布局与算法复杂度,选错类型是 Redis 性能与内存问题的第一来源。本节逐型拆解,并给出"类型选型表"收尾。
字符串与哈希:最常用的两型
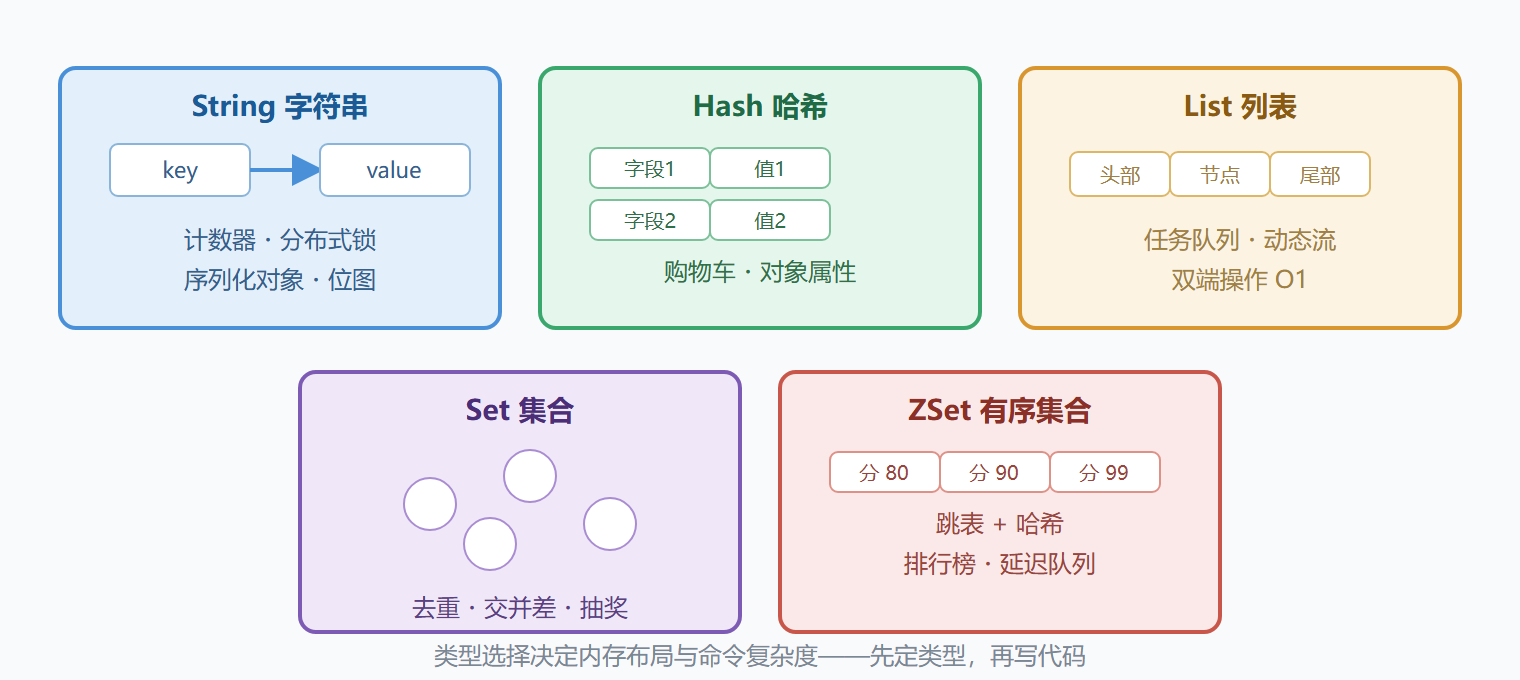
**字符串(String)**是默认类型,也是唯一能存二进制的一型。除了存值,它有一组原子命令让它成为计数器与分布式锁的载体:
SET stock:88312 100 # 存 GET stock:88312 # 取 INCR hits:home # 原子自增(计数器) SET lock:order:1 "uid-9" NX EX 30 # 不存在才写入 + 过期 = 简单分布式锁
哈希(Hash)在键下再挂一层字段,适合"对象"语义:购物车、用户属性。与"整个对象序列化成一个大字符串"相比,哈希可以按字段读写(改购物车里某商品数量不必读写整个对象),也能按字段过期遍历:
HSET cart:1001 sku88312 2 # 用户 1001 的购物车:商品 88312 数量 2 HINCRBY cart:1001 sku90001 1 # 原子加一件 HGETALL cart:1001 # 整车取出 HDEL cart:1001 sku88312 # 移除单件
内存细节值得一提:元素少且短时,哈希底层用压缩列表/紧凑列表编码(连续内存、省指针开销),超阈值自动转哈希表——这就是"小对象更省"的机制来源,OBJECT ENCODING 命令可直接查看。
列表、集合、有序集合
**列表(List)**是双端链表(快速链表实现):头部尾部插入弹出都是常数级,天然适配任务队列与最新动态流(LPUSH + LTRIM 实现"只留最近一百条"的滑动窗口)。
**集合(Set)**是无序去重集合,交并差集内建:抽奖去重、共同关注(交集)、标签系统都是它的主场。SPOP 可做"随机抽取",SRANDMEMBER 抽样。
有序集合(Sorted Set / ZSet)在集合上加了分数与排序,成员唯一、按分数有序:排行榜的首选。底层是跳表 + 哈希的组合——跳表负责按分数的有序性与范围查询(对数复杂度),哈希负责按成员定位分数:
ZADD board:2026 980 "user:1001" # 上榜(分数为积分) ZINCRBY board:2026 15 "user:1001" # 加 15 分 ZREVRANGE board:2026 0 9 WITHSCORES # 前 10 名(含分数) ZRANK board:2026 "user:1001" # 我的排名
图:五种类型的结构与典型用途
演练:排行榜与延迟队列的组合实现
背景:答题活动需要两个功能:实时积分榜(前百名 + 我的排名)、答题超时未提交的自动判卷(延迟任务)。
操作:积分榜用有序集合——每次提交 ZINCRBY 加分,前端两个读接口分别用 ZREVRANGE 取前百、ZRANK 取名次;延迟队列也用有序集合——把任务 ID 以"应执行时间戳"为分数放入,定时任务每秒 ZRANGEBYSCORE 取出到期任务执行,处理后 ZREM 防重复。两个功能共用一个实例,类型都是 ZSet 但键空间独立。
结果:百万参与规模下榜单读取毫秒级;延迟判卷误差在一秒内;活动结束后两键直接删除,无残留。
解读:同一数据类型服务两个看似无关的功能(排行与延迟),关键洞察是有序集合的本质是"按分数排序的唯一成员集"——分数是积分还是时间戳,它不在乎。识别这种"结构本质"比背命令更重要。另注意延迟队列用 Redis 是轻量方案,任务量大、可靠性要求高时应上专业消息队列(5.5 的边界讨论)。
变式:若榜单要按天滚动(每日清零),键里加日期(board:20260901)并设置过期,旧榜自动消失——键设计承担了时间维度,类型只管结构。
易错点
第一个是大键:百万元素的集合/列表/哈希读写与删除都可能是秒级阻塞,DEL 大键要用 UNLINK(异步回收);监控大键(内存分析工具)应成为日常。第二个是把哈希当关系表:字段数无节制增长退化成大键,且失去关系型的二级索引能力;对象字段可控用哈希,检索需求用文档门派。第三个是忽视编码阈值:小对象用紧凑编码、超阈值转标准结构,中间状态的单键性能漂移常让人困惑——理解编码机制后这类"玄学"就有了解释。
类型 — 底层编码 — 命令 — 陷阱 四栏表
五种基础类型是 Redis 的全部数据结构,但每种类型在不同规模下会切换底层编码,理解这一点才能解释很多"内存突然变大"的现象。
| 类型 | 小规模编码 | 大规模编码 | 典型命令 | 常见陷阱 |
|---|---|---|---|---|
| String | int / embstr | raw | SET / GET / INCR / SETNX | 把对象序列化成 JSON 塞进 String,丧失部分操作能力 |
| Hash | ziplist(紧凑) | hashtable | HSET / HGET / HGETALL | 无限制增长的 Hash 会转成 hashtable,内存翻倍 |
| List | ziplist / listpack | quicklist | LPUSH / RPOP / LRANGE | 当队列用但没有消费确认,消息可能丢 |
| Set | intset | hashtable | SADD / SISMEMBER / SINTER | 大集合求交集开销高,可能阻塞 |
| ZSet | ziplist | skiplist + dict | ZADD / ZRANGEBYSCORE | 分数相同按字典序,别依赖它做稳定排序 |
# String:计数与分布式锁的基础 SET lock:order:90001 "node-7" NX PX 30000 # 获取锁,30 秒自动释放 INCR article:view:8801 # 计数 # Hash:对象的字段级读写,比整存 JSON 省网络与解析开销 HSET user:90001 nickname 阿澈 level 3 city 郑州 HINCRBY user:90001 level 1 HGETALL user:90001 # List:轻量队列(无确认机制,重要消息请用 Stream) LPUSH queue:mail "msg-1" RPOP queue:mail # 阻塞版,避免空轮询 BRPOP queue:mail 30 # Set:去重与关系运算 SADD article:8801:likers 90001 90002 SISMEMBER article:8801:likers 90001 SCARD article:8801:likers # ZSet:排行榜与延迟队列 ZADD leaderboard 2560 "player-07" ZREVRANGE leaderboard 0 9 WITHSCORES ZRANGEBYSCORE delay:queue 0 1788000000 LIMIT 0 100
编码切换的实战影响
以 Hash 为例:字段数少、值短时使用紧凑编码(listpack/ziplist),所有字段挤在一块连续内存里,省指针开销;一旦超过阈值(字段数或单个值的长度),就转成哈希表,内存占用可能增加一倍以上。
这意味着"用很多小 Hash 存数据"比"用少量大 Hash"更省内存(前提是每个 Hash 不超阈值)。这也是 Redis 里经典的"分片 Hash"技巧:把 user:90001 这样的对象拆成按 ID 取模的多个小 Hash 存储。
另一个影响是大 Key 的危害:一个包含百万元素的 Set 或 ZSet,删除时(DEL)会阻塞单线程较长时间。4.0 起可以用 UNLINK 异步删除,把释放内存的工作交给后台线程。生产环境建议:删除未知大小的 Key 一律用 UNLINK。
本节要点回顾
- 五型对应五类结构:字符串(原子计数与锁)、哈希(按字段读写)、列表(双端队列)、集合(去重与交并差)、有序集合(排序)。
- 类型即性能契约:键内结构决定命令复杂度,选型先于编码。
- 底层编码动态切换(紧凑列表对哈希表、跳表对哈希),"小对象更省"由此而来。
- 延迟队列与排行榜同源:有序集合 = 按分数排序的唯一成员集。
- 大键是第一杀手:用 UNLINK 删、用监控查、拆分键粒度。
类型齐了,下一节回答键值门派最致命的问题:内存里的数据断电怎么办。