5.7 高可用哨兵机制
5.7 高可用哨兵机制
单机 Redis 挂了服务就停——高可用的第一步是主从复制,第二步是自动故障转移,哨兵(Sentinel)就是后者的管理者。本节先铺主从复制的底子,再拆哨兵的三大任务与判定流程,最后算清脑裂这笔账。它和 4.5 的 MongoDB 复制集是绝佳的对照样本:同样的主从切换问题,MongoDB 用多数派写关注回答,Redis 哨兵用 min-replicas 参数回答,一致性哲学的差异一目了然。
主从复制:哨兵的地基
主从复制的建立分两段:全量同步——从库首次连接时,主库 bgsave 生成 RDB 发给从库加载,期间新写入进入缓冲区随后补发;命令传播——此后主库把写命令实时流式发给从库(与 MongoDB 的 oplog 重放异曲同工)。断线重连时若复制位移还在缓冲区内则增量续传,否则退化全量——缓冲区太小 + 从库断得久 = 频繁全量同步 = 主库网卡与 CPU 双重抖动,这是复制配置的头号调优点。
哨兵的三任务与判定流程
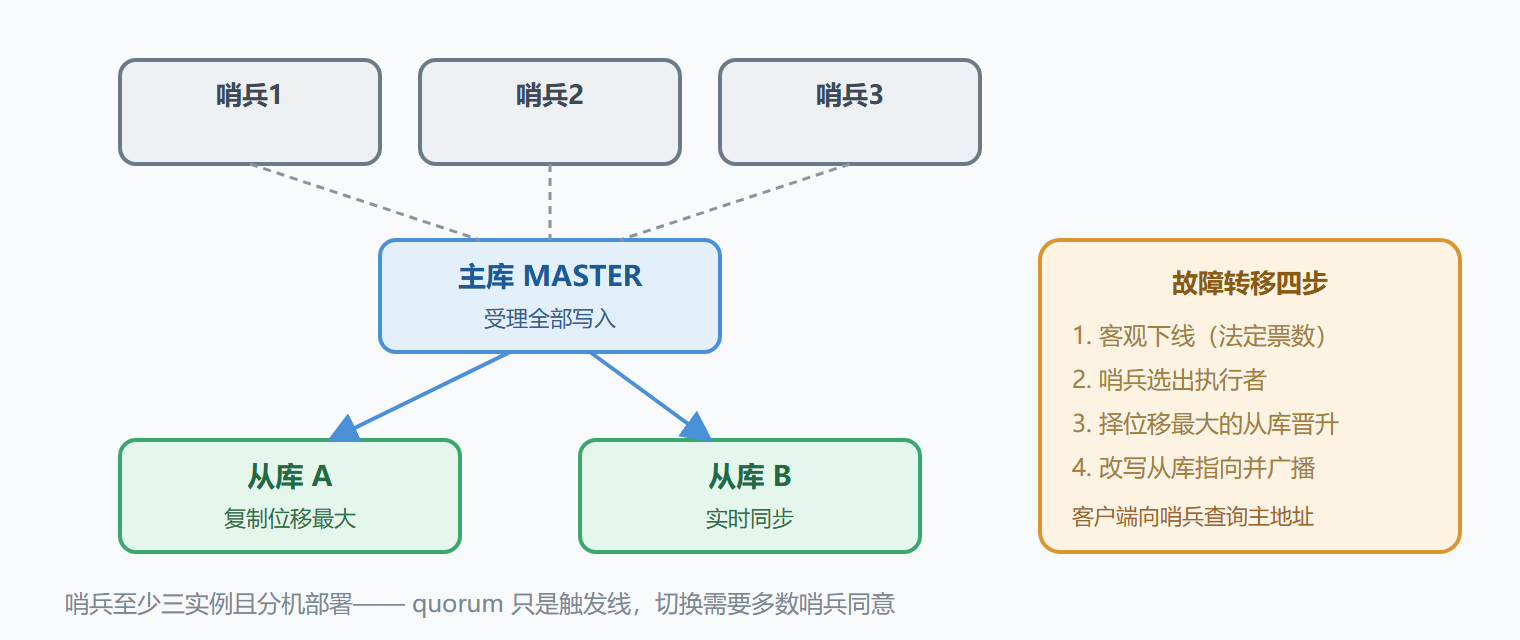
哨兵是独立进程(建议至少三实例、分布在不同物理机),承担三个任务:监控(持续 ping 主从)、通知(异常时通知运维与客户端)、自动故障转移(选新主、通知客户端换主)。判定分两级:单个哨兵 ping 不通主库是主观下线(可能是自己网络问题);达到配置的法定票数(quorum)后升级为客观下线,触发选举与切换。
切换流程四步:哨兵们先选出执行者(Raft 式);执行者从从库中挑新主(优先级、复制位移、运行 ID 三级排序——复制位移最大者数据最新);向新主发晋升命令;改写其余从库的复制指向并广播新主地址。客户端不硬编码主地址,而是先问哨兵要地址(SENTINEL get-master-addr-by-name),切换后自动跟随——应用的连接串要配成哨兵模式,这是代码层面的配套。
脑裂与 min-replicas 防线
脑裂场景值得专门推演:主库与哨兵/从库之间的网络分区,主库还活着、客户端还在往它写,但哨兵已选出新主;分区愈合后旧主降级为从并清空自己同步新主——分区期间写入旧主的那些数据全部丢失。防线是 min-replicas-to-write 与 min-replicas-max-lag:主库发现自己连不上足够多的从库(或从库延迟超限)就拒绝写入——宁可不可用,也不接收注定丢失的写入。这正是 3.1 CAP 的 Redis 版表态:分区时刻,用可用性换一致性。
图:哨兵架构与故障转移流程
演练:一次主库宕机的切换复盘
背景:一主两从 + 三哨兵(quorum 为 2),客户端走哨兵地址;某晚主库进程 OOM 崩溃。
操作:推演时间线。第 0 秒主库崩溃;第 5 秒哨兵 1 与哨兵 2 各自判定主观下线,达到 quorum 后升级客观下线;第 8 秒哨兵间选出执行者,对比两从库复制位移,从库 A 领先被选中;第 10 秒从库 A 晋升主库,从库 B 改挂新主;第 15 秒客户端刷新地址完成切换,写入恢复。事后核对:主库崩溃前最后 5 秒内异步复制未及传播的约 200 毫秒写入丢失,业务层按幂等重试补齐。
结果:全程无人值守,恢复用时约 15 秒;数据损失窗口在预期内(异步复制的固有代价)。
解读:两个数字要刻进印象——切换通常十秒级(判定超时 + 选举 + 晋升 + 客户端刷新),缓存型业务无感,写入型业务要有重试与幂等配套;丢失窗口与复制延迟同量级,压到 200 毫秒靠的是从库性能与网络,配置只能兜底不能消除。若业务零容忍,升级为 5.8 集群 + 应用层强一致写入,或把事实源交给 MongoDB 这类多数派确认的存储(4.5)。
变式:哨兵数量与 quorum 的权衡——三哨兵 quorum 2 是常规解;哨兵部署必须跨故障域(不同机器/机架),全塞一台机器等于没有哨兵。
易错点
第一个是哨兵单实例或同机部署:故障域重合,切换能力形同虚设。第二个是客户端直连主库地址:切换后应用还往旧主写,要么报错要么写进降级节点;连接配置必须走哨兵发现。第三个是关闭 min-replicas 防线:脑裂的丢失窗口从毫秒变秒级;开启后带来的"分区期拒绝写入"是可接受的代价。第四个是全量同步风暴:从库批量重启同时申请全量,主库 bgsave 连发;错峰重启、调大复制缓冲区是标准预防。
哨兵判定流程与切换演练
哨兵(Sentinel)是一组独立进程,负责监控主从实例、判定故障并执行切换。它本身也是分布式的——多个哨兵互相投票,避免单个哨兵误判。
判定流程分两层:
| 概念 | 含义 | 目的 |
|---|---|---|
| 主观下线(SDOWN) | 单个哨兵在规定时间内收不到实例的有效响应 | 单个哨兵的初步判断 |
| 客观下线(ODOWN) | 足够多的哨兵都认为该实例下线 | 集群共识,避免单点误判 |
| 领导者选举 | 哨兵之间投票选出执行切换的那一个 | 保证只有一个哨兵动手 |
| 故障转移 | 选出新主、其余从节点改指向、通知客户端 | 恢复服务 |
演练:主节点宕机后的完整过程
- 哨兵每秒向主从实例发 PING,主节点连续 down-after-milliseconds(默认 30 秒)无有效响应,该哨兵标记 SDOWN;
- 该哨兵询问其他哨兵,若认为下线的哨兵数达到 quorum,标记为 ODOWN;
- 哨兵之间选举领导者(基于 Raft 思路,先到先得加多数票);
- 领导者按规则选新主:先排除断线的从节点,再按优先级(replica-priority)、复制偏移量(数据最新)、运行 ID 排序,选出最优者;
- 向新主发
REPLICAOF NO ONE,向其余从节点发REPLICAOF 新主,完成拓扑切换; - 通过发布订阅频道通知客户端新主地址。
# 哨兵配置关键项(sentinel.conf) sentinel monitor mymaster 10.0.0.11 6379 2 # 2 表示需要 2 个哨兵同意才判 ODOWN sentinel down-after-milliseconds mymaster 30000 sentinel parallel-syncs mymaster 1 # 切换后同时同步的从节点数,避免全量同步压垮新主 sentinel failover-timeout mymaster 180000 # 查看被监控的主节点与哨兵状态 redis-cli -p 26379 SENTINEL masters redis-cli -p 26379 SENTINEL get-master-addr-by-name mymaster
哨兵的三个已知弱点
切换期间写入可能丢失。 Redis 复制是异步的,主节点宕机时,已返回成功但尚未同步到从节点的写入会永久丢失。哨兵无法解决这一点——这是异步复制的固有代价,只能通过业务层(如改用队列、接受少量丢失、或对关键数据不用 Redis 作主存储)规避。
客户端必须支持哨兵。 应用需要通过哨兵查询当前主节点地址,并在切换后自动重连。不支持哨兵协议的客户端在切换后会持续连到旧主(或报错)。
网络分区下可能出现双主。 少数派分区里的哨兵若达到 quorum 也可能发起切换,导致两个主节点同时接受写入。缓解手段是把哨兵部署成奇数个并跨机架分布,同时把 min-replicas-to-write 等参数配置好,让少数派主节点在无法满足写入条件时拒绝写入。
本节要点回顾
- 主从复制两段式:RDB 全量 + 命令流传播,缓冲区决定断线续传能力。
- 哨兵三任务:监控、通知、自动转移;判定两级:主观下线 → 客观下线(quorum)。
- 新主挑选看复制位移:数据最新者优先;切换十秒级,客户端走哨兵发现。
- 脑裂防线 = min-replicas 参数:分区期拒绝写入,用可用性换一致性。
- 异步复制的丢失窗口是固有属性,配套幂等重试消化。
高可用就位,最后一站走到底:数据多到一台机器装不下——集群模式。