5.8 集群模式与数据分片
5.8 集群模式与数据分片
哨兵(5.7)解决了可用性,没解决容量——单主内存再大也有上限。Redis 集群(Cluster)是官方的终极形态:数据分片 + 每片自带复制 + 去中心化路由。本节拆 16384 槽位模型、MOVED/ASK 重定向与客户端路由、集群的能力边界,并在全册收束处对照 MongoDB 分片,为整次巡礼收官。
16384 槽位:固定分片的艺术
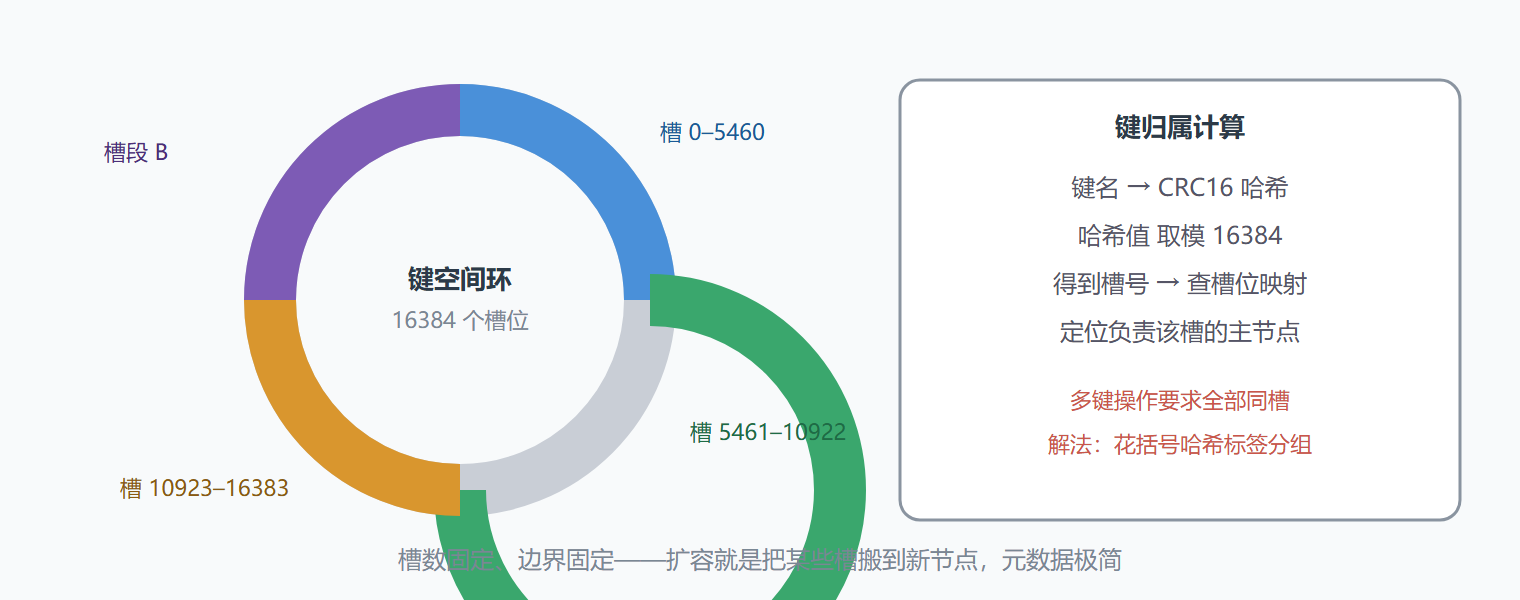
集群把键空间切成 16384 个槽(slot),每个键按 CRC16(键名) 取模 16384 归属唯一槽位,槽位分配给各主节点——默认等分,可手动重划。这与 MongoDB 的"块按需分裂"不同:槽数固定、边界固定,容量扩展就是"把某些槽搬到新节点",元数据极简且再平衡可控。
SET product:88312:name "冲锋衣" # CRC16 哈希后落入槽 15231,路由到负责该槽的节点 GET product:88312:stock # 同前缀键落同槽,多键操作可行 SET {cart:1001}.lock 1 # 花括号显式指定哈希标签,cart:1001 相关键全部同槽
多键操作与 Lua 的多键要求全部键同槽——这引出键设计的集群适配:把相关键带上共同前缀并用花括号哈希标签(如 {cart:1001}:lock、{cart:1001}:items),既有逻辑分组又满足同槽。哈希标签是集群键设计的核心技巧,没有之一。
路由:MOVED、ASK 与智能客户端
集群节点间用 Gossip 协议互相通报状态(无中心协调者,与 Cassandra 同哲学)。客户端访问的键不在当前节点时收到两种重定向:MOVED(槽已永久归属别的节点,客户端应更新槽位映射缓存)与 ASK(槽正在迁移中,本次先去目标节点试,映射表暂不更新)。生产环境用支持集群协议的智能客户端:本地缓存完整槽位映射表,直接发往正确节点,重定向只在拓扑变化后偶发——这是集群性能的保障,也是"客户端必须换库"的迁移成本来源。
图:16384 槽位环与节点槽位分配
能力边界与替代方案
集群模式有四条硬限制,动笔前必须知道:多键跨槽禁用(事务、Lua、多键命令都要同槽,哈希标签缓解但强相关数据可能跨不了);数据库编号失效(只有 db0);SELECT 与部分命令不可用;复制结构与哨兵并存复杂(集群自带分片内复制,通常不再叠哨兵)。另外集群最小生产规模是 3 主 3 从(每个主至少一个从做故障转移),小项目硬上集群是负优化。
替代方案要摆到台面:数据量不大(内存几十 GB 内)时"一主多从 + 哨兵"(5.7)就是终局,容量瓶颈先做键瘦身(大键拆分、TTL 清理);追求简单扩展可上代理层方案(客户端连代理、代理路由,功能兼容性更好);云托管则把分片运维整体外包。集群模式是容量到了单机物理上限(几百 GB 内存级)之后的答案。
演练:从主从到集群的扩容全过程
背景:一主两从架构,内存用到 180GB(单机上限),写入持续增长,决定迁三主三从集群。
操作:第一步键审计——扫描大键与散键分布,把 cart:<uid> 家族键统一加哈希标签改写为 {cart:<uid>}:items(应用双写过渡);第二步搭 3 主 3 从集群,槽位等分;第三步数据迁移——对每类键按前缀批量 MIGRATE COPY 到对应槽位节点(哈希标签保证多键原子性),期间业务双写新旧两套;第四步校验后切读流量,下线旧主从。
结果:容量扩到三节点合计约 500GB 上限,写入吞吐近三倍;热身期发现两个问题并修复——某个 Lua 脚本跨槽报错(改写为哈希标签分组),一处运维脚本仍用 SELECT 1(集群只有 db0,改键前缀隔离)。
解读:迁移流程的关键是键空间改造先行——哈希标签改写必须赶在切流前完成,切流后再改就要停业务。第二个收获是限制清单的价值:SELECT 失效这类问题若在架构评审时就对照 5.8 的四条硬限制排查,两处返工都不会发生。集群迁移的一半工作量在"适配限制",不在搬数据。
变式:若业务键天然无关联分组(纯缓存字符串),无哈希标签负担,直接集群化代价更低;若数据量其实还能靠"键瘦身 + 淘汰策略"压回单机,退回 5.7 方案,省掉整套集群复杂度。
易错点
第一个是小容量硬上集群:3 主 3 从起步的运维成本远超收益,容量估算先行。第二个是多键操作跨槽上线后才暴露:事务与 Lua 在集群报错是运行时错误,评审阶段就按"同槽改造清单"过一遍所有多键代码。第三个是槽位映射缓存陈旧:拓扑变更后客户端不刷新,请求持续打错节点被 MOVED 弹回;智能客户端要开启映射自动刷新。第四个是忘记分片内的高可用:集群某主节点挂了,它负责的槽位由从库晋升接管——从节点缺失的主节点是集群的单点,3 主 3 从的"3 从"不是可选项。
槽位模型与扩缩容演练
Redis Cluster 采用固定槽位:一共 16384 个槽,每个键按 CRC16 校验后取模落在某个槽上,槽再分配给各主节点。
# 查看集群节点与槽位分配 redis-cli --cluster info 10.0.0.11:6379 redis-cli CLUSTER NODES # 列出每个节点持有的槽位区间 redis-cli CLUSTER SLOTS # 计算某个键属于哪个槽(注意大括号可指定"哈希标签",让相关键落在同一槽) redis-cli CLUSTER KEYSLOT user:90001 redis-cli CLUSTER KEYSLOT order:{90001}:items # 哈希标签相同 → 同一槽
演练:从三主扩到四主
- 加入新节点:
redis-cli --cluster add-node 新节点 已有节点,新节点初始不持有槽位; - 规划迁移:把现有三个主节点各自的一部分槽位(约 4096 个)迁给新节点,保证最终四主各持约 4096 个;
- 逐槽迁移:对每个待迁移的槽,在目标节点执行
CLUSTER SETSLOT <slot> IMPORTING <源>,在源节点执行MIGRATING,然后用MIGRATE命令搬运键,完成后SETSLOT <slot> NODE <目标>提交; - 自动模式:
redis-cli --cluster reshard可以自动完成上述规划与迁移,指定迁移槽数与源、目标节点即可; - 校验:
redis-cli --cluster check检查槽位是否全覆盖、有无迁移残留。
# 交互式扩容:迁移 4096 个槽到新节点 redis-cli --cluster reshard 10.0.0.11:6379 --cluster-from <源节点ID> --cluster-to <新节点ID> --cluster-slots 4096 --cluster-yes
集群模式的能力限制清单
这些限制在选型时必须提前知道,否则上线后会处处碰壁。
| 限制 | 说明 | 应对 |
|---|---|---|
| 多键操作受限 | 不在同一槽的键不能在一个命令里操作 | 用哈希标签强制同槽,或拆成多次调用 |
| Lua 脚本的键约束 | 脚本涉及的键必须落在同一槽 | 用哈希标签设计键名 |
| 只支持 0 号数据库 | 集群模式下不能 SELECT 其他库 | 用键前缀做命名空间 |
| 事务受限 | 跨槽事务不支持 | 同上,靠键设计规避 |
| 扩容期间延迟抖动 | 迁移消耗网络与 IO | 限流迁移、低峰期操作 |
| 客户端要求 | 需要支持集群协议的客户端 | 主流语言客户端均支持 |
# 哈希标签示例:把同一用户的所有键归到同一槽,使 MGET 可用 MGET user:{90001}:profile user:{90001}:settings user:{90001}:cart # 只有大括号内的内容参与槽位计算,因此三个键同槽,MGET 可用
哨兵与集群怎么选
选哨兵:数据量单机能装下(几十 GB 以内)、主要诉求是高可用、希望保留全部命令能力(多键操作、多数据库)。
选集群:数据量超出单机内存、或写入吞吐需要多主分流、且能接受多键操作受限。
第三条路:多个独立主从 + 客户端分片(在应用层按业务拆分到不同 Redis 实例)。很多团队最终走这条路——它牺牲了自动扩缩容的便利,换来了简单可控与完整的命令能力,在数据量可预期的场景下往往更省心。
本节要点回顾
- 16384 固定槽位:键按 CRC16 模 16384 归槽,扩展 = 搬槽,元数据极简。
- 哈希标签(花括号前缀)是同槽分组的核心技巧,先于切流完成键改造。
- 路由三级:智能客户端本地映射 → MOVED 永久重定向 → ASK 迁移期重定向。
- 四条硬限制:跨槽多键禁用、单 db、部分命令不可用、最小 3 主 3 从。
- 方案阶梯:键瘦身 → 主从哨兵(5.7)→ 代理层 → 集群,按容量台阶走。
槽位模型落定,键值门派深访至此收官。五站门派、三层内功、两场深访——全册巡礼在导读的知识地图上画完了最后一笔,愿这套世界观在你下一次选型与排错时派上用场。