1.4 函数与模块:把脚本拆成零件
1.4 函数与模块:把脚本拆成零件
本节摘要:代码一过百行,"从上读到下"就变成了体力活。函数把一段有明确职责的代码封进名字里,主流程退化成几行"调零件"的清单;模块再把函数按主题分进不同文件。本节讲函数的定义、参数、返回值与作用域,然后把轻记账 v0.1 重构成函数版——功能一分不变,可读性和可改性上一个台阶,也为第二章拆文件铺路。
动手前先定目标
阅读完本节,你应当能够:
- 定义带参数与返回值的函数,说清"传进去什么、吐出来什么"
- 区分位置参数、关键字参数与默认参数
- 解释局部变量与全局变量的作用域差异
- 把 v0.1 重构成函数版,理解"主流程读起来像目录"
问题:重复与超长,是代码变烂的两个起点
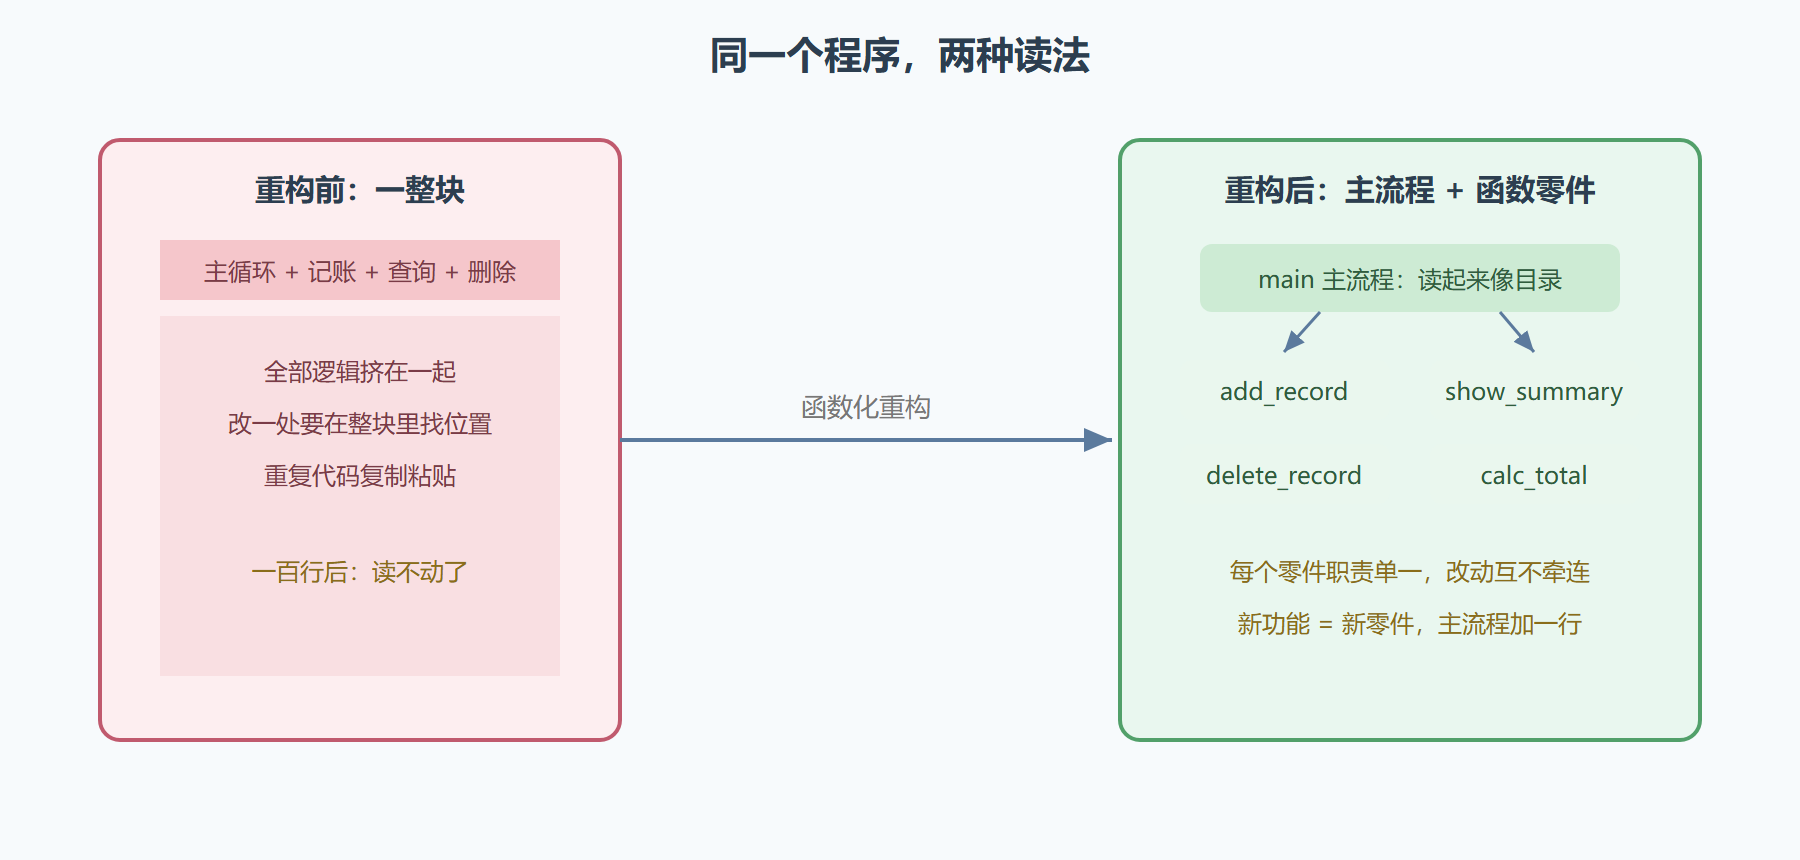
看看 v0.1 的主循环:记账逻辑六行、汇总逻辑五行,全挤在分支里。将来要加"统计某天支出""导出账目",主循环会膨胀到两三百行,想改汇总就得在几百行里翻找。函数解决的就是这个问题:给一段代码起名字,之后用名字调用它。改功能时只改函数内部,调用处一行不动——这是"可维护"三个字最朴素的实现。
图 1-3 脚本演进:从一整块到零件组装
函数的 anatomy:参数、返回值、文档
def add_record(ledger, item, amount): """往账本里记一笔,返回追加后的总条数。""" ledger.append({"item": item, "amount": amount}) return len(ledger)
五个部件:def 开头;函数名小写下划线;圆括号里是参数——函数的"进料口";三引号字符串是文档字符串,说明这函数干什么、返回什么,编辑器悬停时能看到;return 是出口,把结果交还给调用者。没有 return 的函数返回 None。
调用就是"名字加实参":
ledger = [] n = add_record(ledger, "早饭", 12.5) print(n) # 1
参数有三种写法,各有用途:
def calc_total(ledger, since=None, only_big=False): total = 0.0 for record in ledger: if since and record.get("date", "") < since: continue if only_big and record["amount"] < 10: continue total += record["amount"] return total print(calc_total(ledger)) # 位置参数 print(calc_total(ledger, only_big=True)) # 关键字参数:可读性最好 print(calc_total(ledger, since="2026-09-02"))# 默认参数:不传就用默认值
since=None 这种"可选开关"设计在后面章节反复出现——API 的查询参数、ORM 的过滤条件,全是这个模式。
作用域:函数有自己的一亩三分地
函数内部创建的变量是局部变量,函数返回就消失;函数外的是全局变量,谁都能读:
total = 0.0 # 全局 def add_amount(amount): temp = amount * 2 # 局部,函数结束即销毁 return temp print(add_amount(10)) # 20 # print(temp) # NameError —— 外面看不见 temp
要在函数内修改全局变量,得用 global 声明。但更好的做法是不用全局:把数据当参数传进去、把结果当返回值带出来。参数进、返回值出,函数像一台干净的机器,测试和复用都容易。轻记账重构版就坚持"数据靠参数流动",第 3 章的类会把这个习惯推到极致。
演练:v0.1 函数化重构
def add_record(ledger, item, amount): ledger.append({"item": item, "amount": amount}) def show_all(ledger): for i, record in enumerate(ledger, start=1): print(f"{i}. {record['item']} {record['amount']} 元") def calc_total(ledger): return sum(record["amount"] for record in ledger) def main(): ledger = [] running = True while running: command = input("指令(记 / 查 / 退):") if command == "记": add_record(ledger, input("用途:"), float(input("金额:"))) elif command == "查": show_all(ledger) print(f"合计 {calc_total(ledger):.1f} 元") elif command == "退": running = False else: print("指令无效") main()
读 main,主流程四行指令一目了然。变式一:加 find_big(ledger, threshold) 函数,返回大额账目列表,在"查"分支里顺便显示。变式二:把账本数据 ledger 从 main 的局部变量改成函数间传递——你会发现参数一多就心烦,这正是第 3 章用类把"数据 + 操作"打包的动机。
模块:函数再多一个家
函数攒多了要分文件。Python 里一个源文件就是一个模块,import 拿来用:
# 账目工具模块里定义了 calc_total # 主脚本里: # import ledger_tools # print(ledger_tools.calc_total(my_ledger))
标准库就是官方写好的模块集合:datetime 管时间、json 管数据交换,第二章会真正用起来。自己写的模块和标准库用法完全一致——这种"官方与民开同构"的整洁,是 Python 生态能滚雪球的原因之一。
易错点清单
- 忘了 return:函数算完没交结果,调用处拿到 None,后续运算报错
- 可变默认参数:默认参数用列表并在函数内追加,数据会在多次调用间累积——默认值写 None 再在函数内新建
- 局部覆盖全局:函数内给与全局同名的变量赋值,它就变成局部,别处读到的还是旧全局
- 文档字符串当摆设:三个月后第一个读它的是你自己,参数含义、返回值务必写
本节要点回顾
- 函数 = 名字 + 参数 + 返回值,主流程调用零件,读起来像目录
- 三种参数:位置、关键字(可读性最好)、默认(做可选开关)
- 数据靠参数流动,少用 global,函数保持"进料出料"的干净接口
- 模块是函数的家,一个文件一个模块,自写模块与标准库同构
- v0.1 完成函数化,结构就绪,只欠两样:数据存不住、错误接不住
零件的形状都有了,下一章先把"存不住"治了——文件读写与 JSON 持久化,让账目在关机之后依然活着。